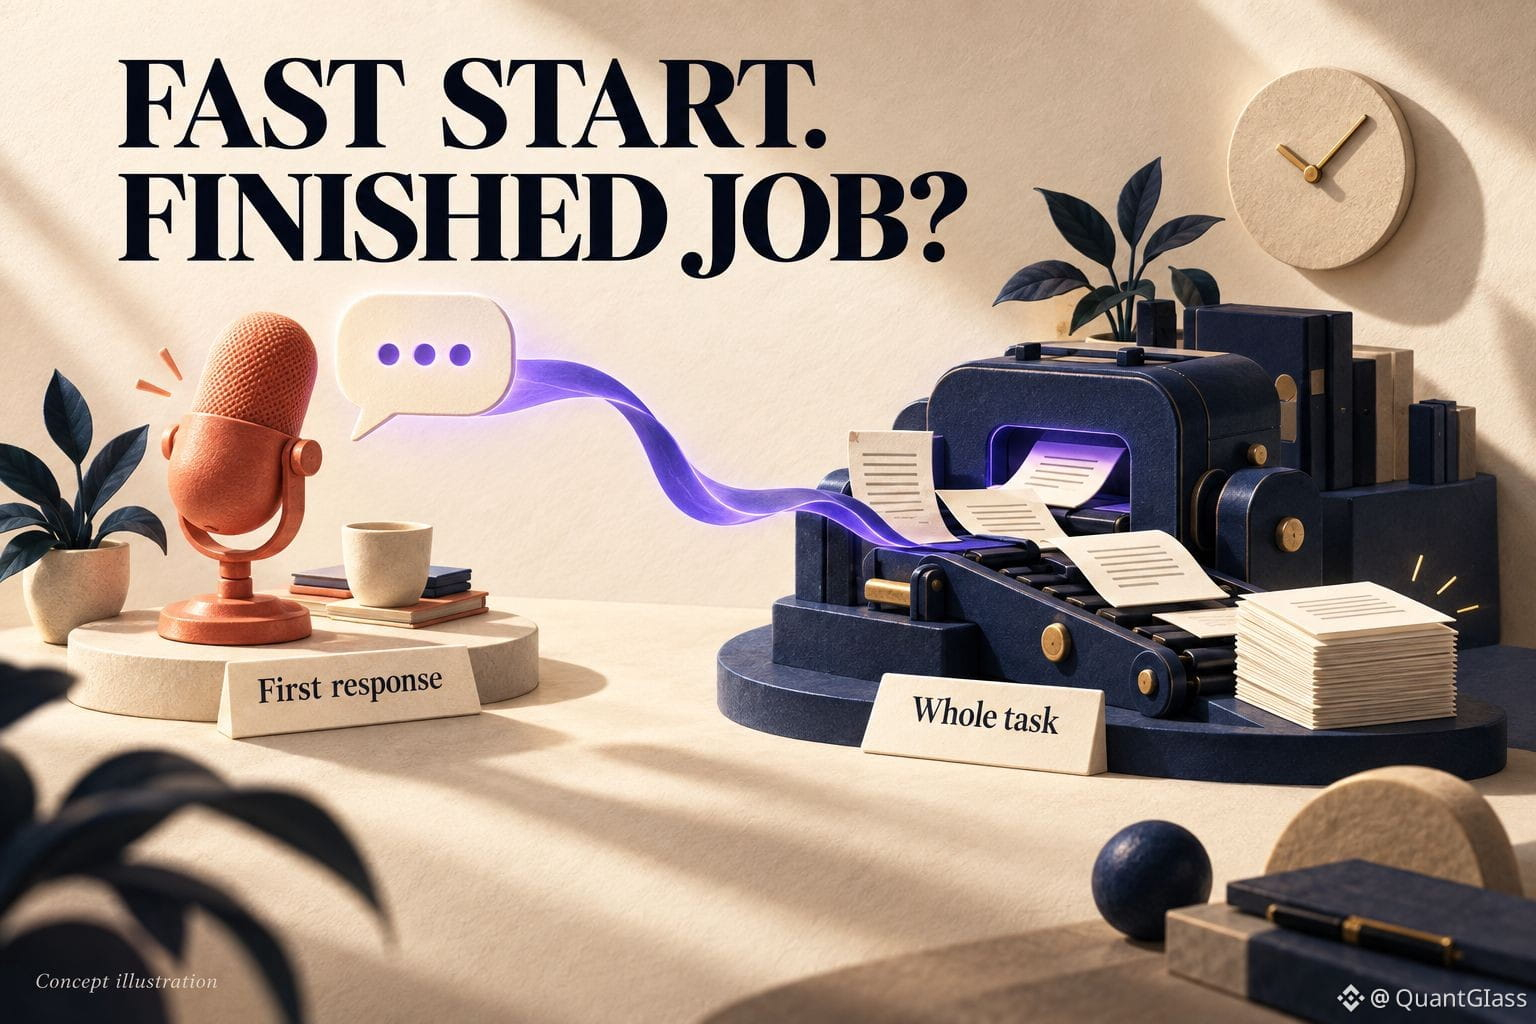
Một AI bắt đầu trả lời nhanh vẫn có thể mất hàng thế kỷ để hoàn tất công việc.
Trong bài viết ngày 18 tháng 9, io.net phân biệt thời gian đến token đầu tiên—thời gian chờ trước khi bắt đầu xuất nội dung—với thông lượng theo lô. Họ đặt các GPU phân tán của mình dựa trên chi phí và tính linh hoạt, chứ không phải nhằm giành cuộc đua token đầu tiên.
Bài kiểm tra của tôi cho câu chuyện $IO compute: đo lường toàn bộ tác vụ. Trợ lý giọng nói trực tiếp cần phản hồi nhanh; một tác vụ xử lý tài liệu qua đêm cần kết quả chính xác đúng hạn với tổng chi phí hợp lý. Các ví dụ về chi phí trong bài viết chỉ mang tính minh họa, không phải các chuẩn so sánh độc lập. Các khối lượng công việc thực tế vẫn cần được kiểm thử.
Cái nào khiến bạn bực hơn: chờ từ đầu tiên, hay chờ câu trả lời đã hoàn tất? #AIInference
Trong bài viết ngày 18 tháng 9, io.net phân biệt thời gian đến token đầu tiên—thời gian chờ trước khi bắt đầu xuất nội dung—với thông lượng theo lô. Họ đặt các GPU phân tán của mình dựa trên chi phí và tính linh hoạt, chứ không phải nhằm giành cuộc đua token đầu tiên.
Bài kiểm tra của tôi cho câu chuyện $IO compute: đo lường toàn bộ tác vụ. Trợ lý giọng nói trực tiếp cần phản hồi nhanh; một tác vụ xử lý tài liệu qua đêm cần kết quả chính xác đúng hạn với tổng chi phí hợp lý. Các ví dụ về chi phí trong bài viết chỉ mang tính minh họa, không phải các chuẩn so sánh độc lập. Các khối lượng công việc thực tế vẫn cần được kiểm thử.
Cái nào khiến bạn bực hơn: chờ từ đầu tiên, hay chờ câu trả lời đã hoàn tất? #AIInference