Có người đã làm một bài thử nghiệm AI đối kháng của “StarCraft” (Brood War Bench), cho các mô hình ngôn ngữ lớn đang thống trị hiện nay “đấu với nhau” trong thời gian thực của thể loại chiến lược. Kết quả là trình độ của tất cả các mô hình đều không vượt nổi người mới.
“StarCraft: Brood War” là tựa game chiến lược thời gian thực kinh điển từ năm 1998, đồng thời cũng là người bạn lâu năm của nghiên cứu AI. Năm 2019, AlphaStar của DeepMind đã từng đánh bại các tuyển thủ chuyên nghiệp trong chính trò chơi này. Nhưng đó là AI được huấn luyện chuyên biệt bằng học tăng cường. Lần thử nghiệm này khác: thay vì vậy, nó cho các mô hình đa năng tiếp cận trực tiếp dưới dạng các “tác nhân AI” để thao tác, xem liệu chúng có tự xây căn cứ, sản xuất quân lính, rồi tiến hành chiến đấu được hay không.
Tác giả Ben Swerdlow ban đầu chỉ làm một phiên bản StarCraft “chỉ có thể điều khiển thông qua thao tác của tác nhân”, để mang đi chơi với bạn bè. Không ngờ vài người bạn gần như chưa từng chơi lại tỏ ra khá ổn — họ nói rằng chỉ cần đưa một câu lệnh kiểu “đi tấn công”, rồi tác nhân tự xây dựng một đội lính nhỏ xông thẳng sang. Điều này khiến anh tò mò: nếu để AI hoàn toàn tự chơi thì sẽ đạt đến trình độ nào?
Đáp án là: rất kém, nhưng lại rất thú vị.
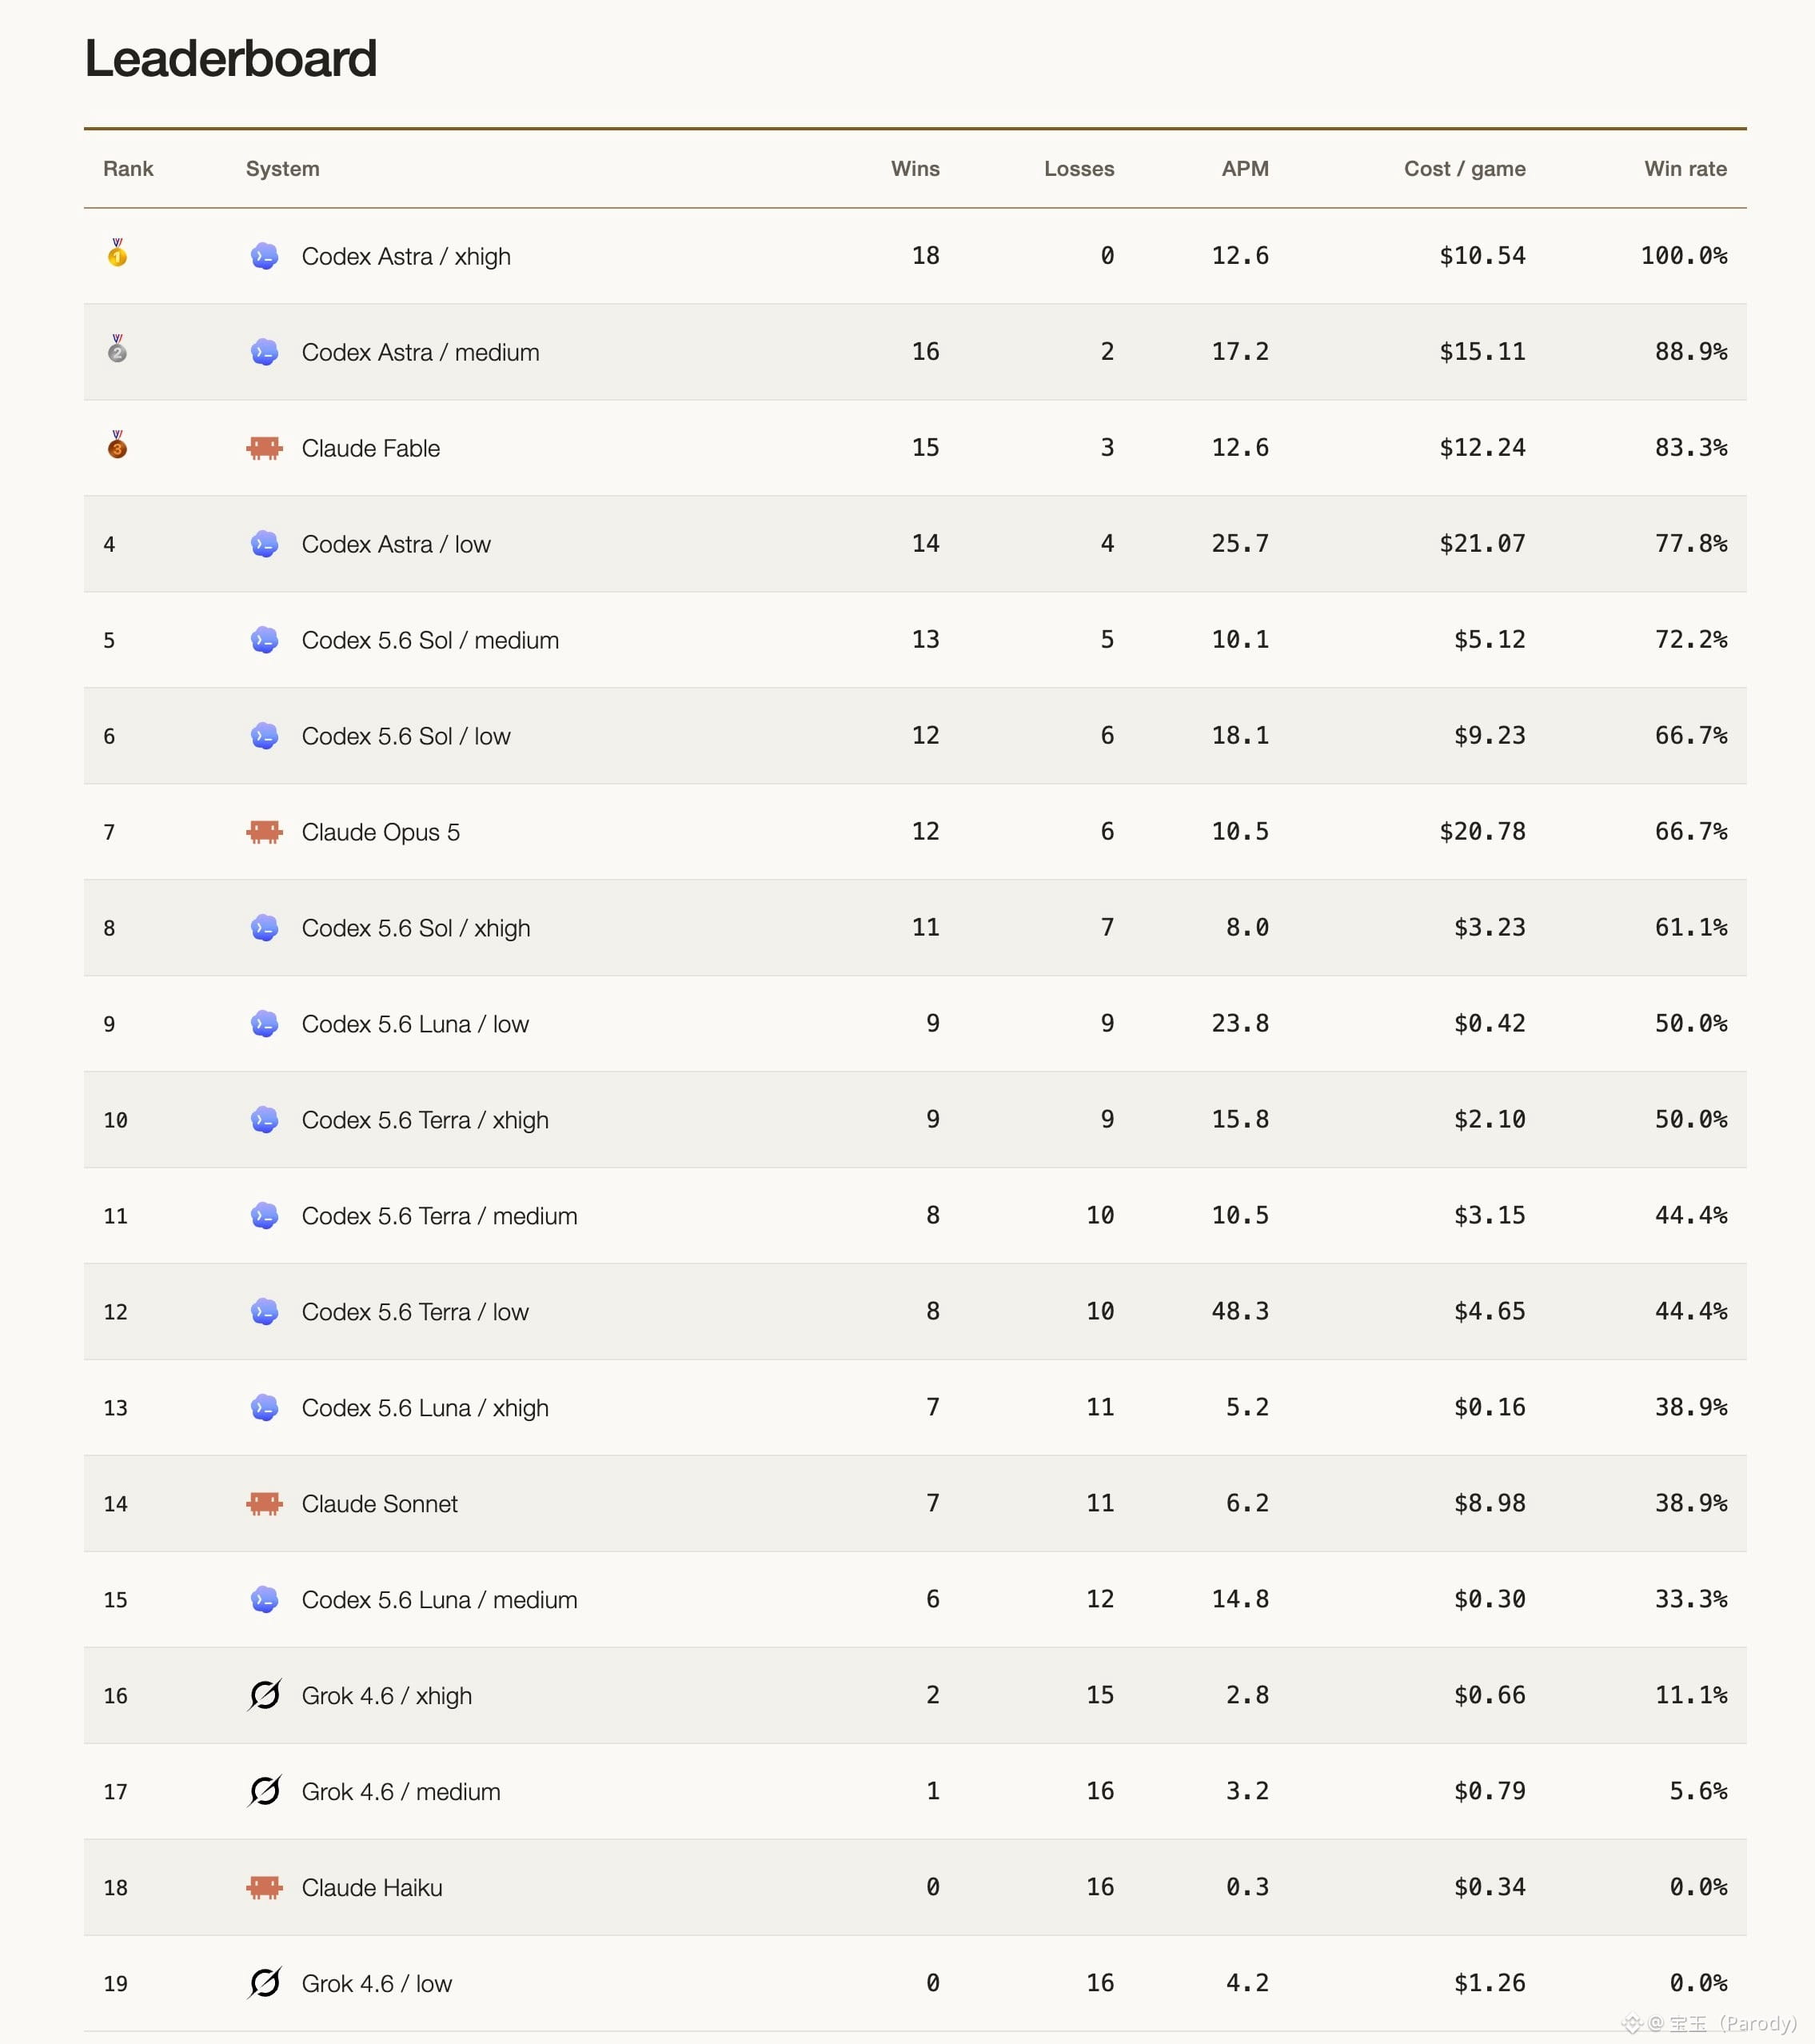
Codex Astra xếp hạng số một thắng cả 18 trận. Tuy nhiên, điểm mạnh của nó không phải là giao chiến chính diện, mà là “quấy rối”: phái một người lính công nghiệp đi khai thác (Probe) chạy sang khu căn cứ của đối phương để phá rối. Chiêu này đặc biệt hiệu quả trước các đối thủ AI, vì khi thấy một công nhân đã tới, tác nhân bên kia sẽ mất hàng chục giây để suy nghĩ nên xử lý thế nào, trong khoảng thời gian đó chẳng làm gì cả. Còn ở mảng phát triển kinh tế đàng hoàng và giao tranh quy mô lớn, Codex lại khá yếu: nó thường chỉ tạo một hoặc hai đơn vị rồi ném sang phía đối thủ, thay vì tích đủ quân lực rồi mới xuất kích.
Claude Fable đứng thứ ba, tỉ lệ thắng 83,3%, là mô hình tham dự “giống đang thực sự chơi game” nhất. Nó sẽ ngoan ngoãn phát triển kinh tế, leo thang công nghệ, thậm chí trong một ván đã tạo ra được phi long (Mutalisk), còn ở ván khác lại nghiên cứu tới công nghệ hiệp sĩ thánh đường. Dù đôi lúc nó nghiên cứu cả một đống mà lực lượng lại không theo kịp, ít nhất Fable cũng nghiêm túc hơn bất kỳ ai trong việc “cố gắng hiểu luật chơi”.
Hiệu suất của Grok là tệ nhất. Grok 4.6 trong một trận 43 phút đã tạo ra hơn 11.000 token suy luận, nhưng chỉ phát ra 6 lệnh thao tác, suốt cả trận không tạo ra nổi một đơn vị chiến đấu nào. Về bản chất, nó đang coi chiến lược thời gian thực như trò chơi theo lượt: cứ nghĩ mãi, quên mất phải hành động.
Thử nghiệm này chỉ ra vấn đề cốt lõi: các mô hình ngôn ngữ lớn hiện tại vẫn chưa đủ để dùng trong môi trường thời gian thực đòi hỏi quan sát liên tục, ra quyết định nhanh và phối hợp đa luồng. Dù mô hình tốt nhất cũng vậy, chỉ cần một người mới biết chơi cũng có thể giành chiến thắng ở mọi trận nếu biết cách đánh bài “pháo photon tốc độ” (một chiến thuật fast-attack cơ bản nhất). Nhưng mặt khác, các mô hình này đã có thể hiểu những khái niệm cơ bản như xây dựng, khai thác, tấn công — chỉ là chúng kém xa về nhịp thực thi và điều phối nhiều nhiệm vụ.
Mã nguồn của bài thử nghiệm và nền tảng đối kháng đã được mở. Bất kỳ ai cũng có thể mang tác nhân của riêng mình lên để đấu một ván. Địa chỉ là http://bw.swerdlow.dev.
“StarCraft: Brood War” là tựa game chiến lược thời gian thực kinh điển từ năm 1998, đồng thời cũng là người bạn lâu năm của nghiên cứu AI. Năm 2019, AlphaStar của DeepMind đã từng đánh bại các tuyển thủ chuyên nghiệp trong chính trò chơi này. Nhưng đó là AI được huấn luyện chuyên biệt bằng học tăng cường. Lần thử nghiệm này khác: thay vì vậy, nó cho các mô hình đa năng tiếp cận trực tiếp dưới dạng các “tác nhân AI” để thao tác, xem liệu chúng có tự xây căn cứ, sản xuất quân lính, rồi tiến hành chiến đấu được hay không.
Tác giả Ben Swerdlow ban đầu chỉ làm một phiên bản StarCraft “chỉ có thể điều khiển thông qua thao tác của tác nhân”, để mang đi chơi với bạn bè. Không ngờ vài người bạn gần như chưa từng chơi lại tỏ ra khá ổn — họ nói rằng chỉ cần đưa một câu lệnh kiểu “đi tấn công”, rồi tác nhân tự xây dựng một đội lính nhỏ xông thẳng sang. Điều này khiến anh tò mò: nếu để AI hoàn toàn tự chơi thì sẽ đạt đến trình độ nào?
Đáp án là: rất kém, nhưng lại rất thú vị.
Codex Astra xếp hạng số một thắng cả 18 trận. Tuy nhiên, điểm mạnh của nó không phải là giao chiến chính diện, mà là “quấy rối”: phái một người lính công nghiệp đi khai thác (Probe) chạy sang khu căn cứ của đối phương để phá rối. Chiêu này đặc biệt hiệu quả trước các đối thủ AI, vì khi thấy một công nhân đã tới, tác nhân bên kia sẽ mất hàng chục giây để suy nghĩ nên xử lý thế nào, trong khoảng thời gian đó chẳng làm gì cả. Còn ở mảng phát triển kinh tế đàng hoàng và giao tranh quy mô lớn, Codex lại khá yếu: nó thường chỉ tạo một hoặc hai đơn vị rồi ném sang phía đối thủ, thay vì tích đủ quân lực rồi mới xuất kích.
Claude Fable đứng thứ ba, tỉ lệ thắng 83,3%, là mô hình tham dự “giống đang thực sự chơi game” nhất. Nó sẽ ngoan ngoãn phát triển kinh tế, leo thang công nghệ, thậm chí trong một ván đã tạo ra được phi long (Mutalisk), còn ở ván khác lại nghiên cứu tới công nghệ hiệp sĩ thánh đường. Dù đôi lúc nó nghiên cứu cả một đống mà lực lượng lại không theo kịp, ít nhất Fable cũng nghiêm túc hơn bất kỳ ai trong việc “cố gắng hiểu luật chơi”.
Hiệu suất của Grok là tệ nhất. Grok 4.6 trong một trận 43 phút đã tạo ra hơn 11.000 token suy luận, nhưng chỉ phát ra 6 lệnh thao tác, suốt cả trận không tạo ra nổi một đơn vị chiến đấu nào. Về bản chất, nó đang coi chiến lược thời gian thực như trò chơi theo lượt: cứ nghĩ mãi, quên mất phải hành động.
Thử nghiệm này chỉ ra vấn đề cốt lõi: các mô hình ngôn ngữ lớn hiện tại vẫn chưa đủ để dùng trong môi trường thời gian thực đòi hỏi quan sát liên tục, ra quyết định nhanh và phối hợp đa luồng. Dù mô hình tốt nhất cũng vậy, chỉ cần một người mới biết chơi cũng có thể giành chiến thắng ở mọi trận nếu biết cách đánh bài “pháo photon tốc độ” (một chiến thuật fast-attack cơ bản nhất). Nhưng mặt khác, các mô hình này đã có thể hiểu những khái niệm cơ bản như xây dựng, khai thác, tấn công — chỉ là chúng kém xa về nhịp thực thi và điều phối nhiều nhiệm vụ.
Mã nguồn của bài thử nghiệm và nền tảng đối kháng đã được mở. Bất kỳ ai cũng có thể mang tác nhân của riêng mình lên để đấu một ván. Địa chỉ là http://bw.swerdlow.dev.