Một nhà đóng gói người Hàn Quốc vừa giải quyết một trong những vấn đề lớn đang kìm hãm các gói AI siêu lớn.
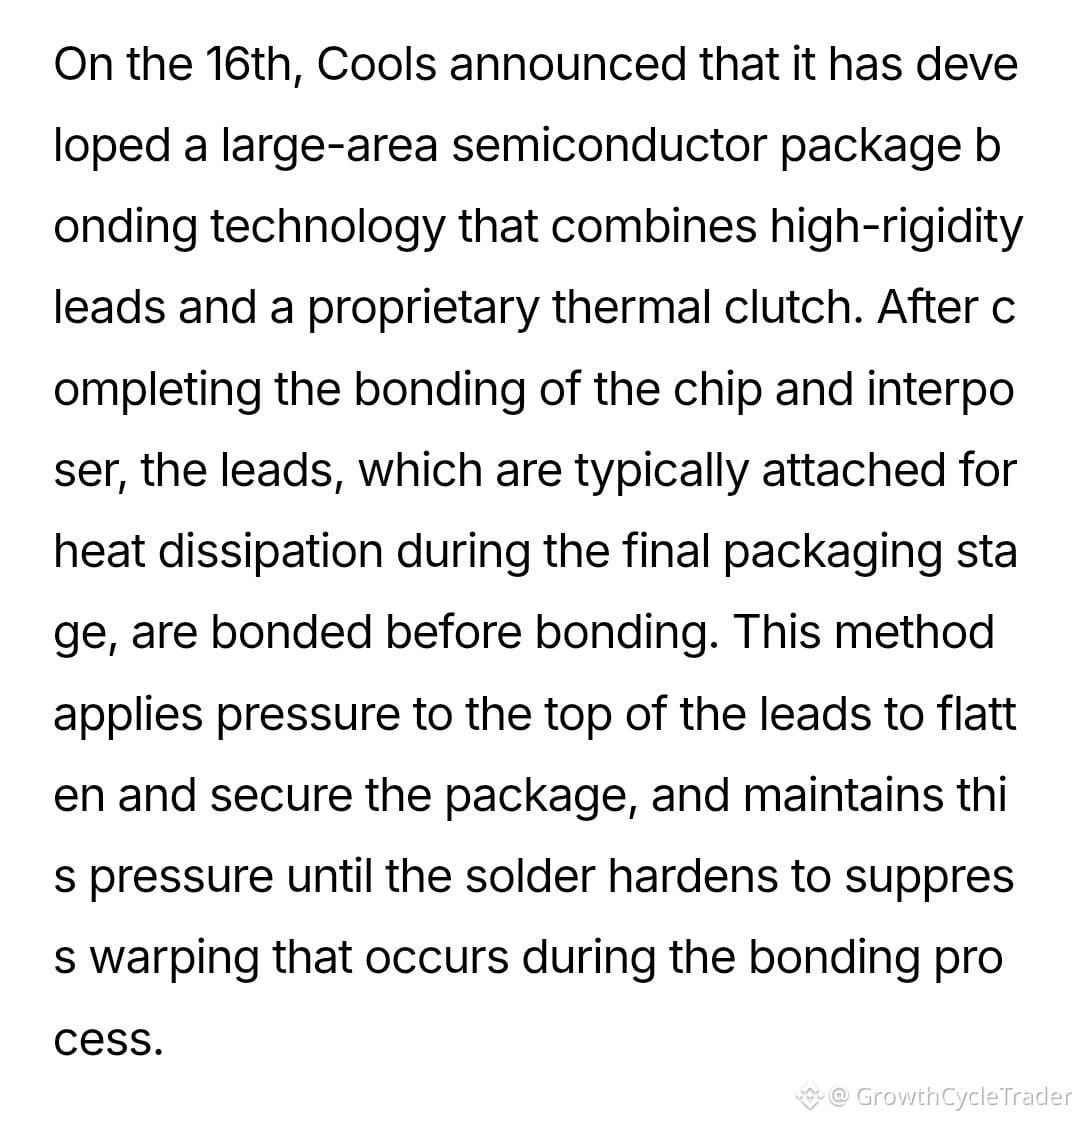
CoolS đã chế tạo mối liên kết nhiệt bằng phương pháp nén theo kiểu “đặt nắp trước”, kẹp nắp trước khi hàn chảy (reflow) — chứ không phải sau. Áp suất giữ cả chồng phẳng cho đến khi các mối nối đông cứng. Sau đó, bộ ly nhiệt sẽ cắt thời gian nung và làm nguội từ hơn một phút xuống dưới 10 giây trên một gói kích thước 180×70 mm. Cong vênh sau liên kết vẫn dưới 0,1 mm.
Vì sao điều này quan trọng: Các gói AI lớn đã chuyển từ hàn chảy trong lò sang liên kết nhiệt bằng nén (thermal compression bonding) vì silicon và đế nền hữu cơ giãn nở với tốc độ khác nhau. TCB giữ mặt phẳng phẳng bằng nhiệt và lực, nhưng thời gian chu kỳ lại bị ảnh hưởng vì nắp (lid) dày sẽ “thấm” nhiệt. Bộ ly nhiệt chặn đường truyền nhiệt trong giai đoạn nung và mở đường này trong giai đoạn làm nguội.
CEO Cho Jin-hyun cho biết đây là cách để giữ cho một module thuộc “đẳng cấp 4 GPU” có thể hoạt động hiệu quả. Phác thảo đầu tiên của $NVDA về Rubin Ultra dự kiến nhồi bốn chip GPU và 16 cụm HBM4E vào trong một gói dài. SemiAnalysis báo cáo hồi tháng 6 rằng rủi ro sản xuất khiến cấu hình phải chuyển sang bản chia 2-GPU.
Cho lập luận rằng dải dài 4-GPU vẫn có thể chế tạo nếu kiểm soát được độ cong vênh và thời gian chu kỳ. CoolS nắm giữ 277 hạng mục IP liên quan.
Một mối liên kết 10 giây không tự nhiên “ghép” lại bốn GPU lên cùng một interposer. Nhưng nó cho thấy cuộc chiến về tỉ lệ lỗi nằm ở đâu. Nếu một gói 180×70 mm có thể giữ cong vênh dưới 0,1 mm, thì Rubin Ultra sẽ vẫn là bản 2-GPU, hay bản phác thảo 4 die sẽ được xem xét lại?
CoolS đã chế tạo mối liên kết nhiệt bằng phương pháp nén theo kiểu “đặt nắp trước”, kẹp nắp trước khi hàn chảy (reflow) — chứ không phải sau. Áp suất giữ cả chồng phẳng cho đến khi các mối nối đông cứng. Sau đó, bộ ly nhiệt sẽ cắt thời gian nung và làm nguội từ hơn một phút xuống dưới 10 giây trên một gói kích thước 180×70 mm. Cong vênh sau liên kết vẫn dưới 0,1 mm.
Vì sao điều này quan trọng: Các gói AI lớn đã chuyển từ hàn chảy trong lò sang liên kết nhiệt bằng nén (thermal compression bonding) vì silicon và đế nền hữu cơ giãn nở với tốc độ khác nhau. TCB giữ mặt phẳng phẳng bằng nhiệt và lực, nhưng thời gian chu kỳ lại bị ảnh hưởng vì nắp (lid) dày sẽ “thấm” nhiệt. Bộ ly nhiệt chặn đường truyền nhiệt trong giai đoạn nung và mở đường này trong giai đoạn làm nguội.
CEO Cho Jin-hyun cho biết đây là cách để giữ cho một module thuộc “đẳng cấp 4 GPU” có thể hoạt động hiệu quả. Phác thảo đầu tiên của $NVDA về Rubin Ultra dự kiến nhồi bốn chip GPU và 16 cụm HBM4E vào trong một gói dài. SemiAnalysis báo cáo hồi tháng 6 rằng rủi ro sản xuất khiến cấu hình phải chuyển sang bản chia 2-GPU.
Cho lập luận rằng dải dài 4-GPU vẫn có thể chế tạo nếu kiểm soát được độ cong vênh và thời gian chu kỳ. CoolS nắm giữ 277 hạng mục IP liên quan.
Một mối liên kết 10 giây không tự nhiên “ghép” lại bốn GPU lên cùng một interposer. Nhưng nó cho thấy cuộc chiến về tỉ lệ lỗi nằm ở đâu. Nếu một gói 180×70 mm có thể giữ cong vênh dưới 0,1 mm, thì Rubin Ultra sẽ vẫn là bản 2-GPU, hay bản phác thảo 4 die sẽ được xem xét lại?