$ETH Vitalik: Thiết kế cơ chế đối kháng có thể là chìa khóa cho an toàn AI
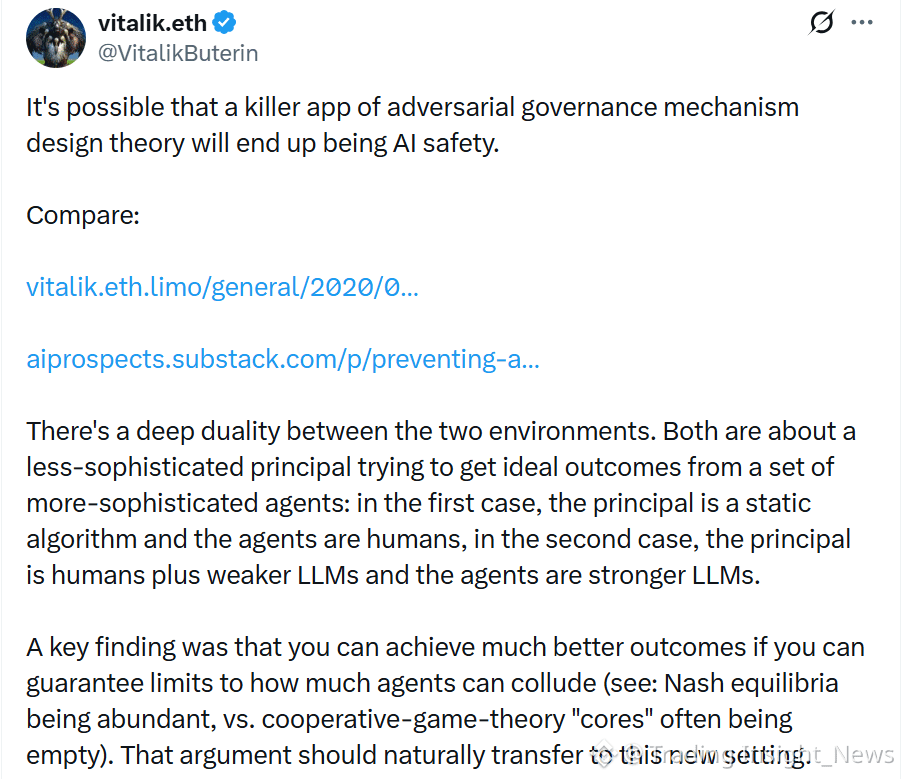
Vitalik Buterin vừa đưa ra một so sánh đáng chú ý: lý thuyết thiết kế cơ chế đối kháng quen thuộc trong crypto có thể là một ứng dụng quan trọng cho an toàn AI.
Cả hai lĩnh vực đều có cấu trúc nhị phân sâu sắc giữa bên ủy quyền (principal) và tác nhân (agent):
Trong crypto: Bên ủy quyền là một thuật toán tĩnh (năng lực yếu), còn tác nhân là con người (năng lực mạnh hơn).
Trong AI: Bên ủy quyền là một con người và một LLM yếu hơn, còn tác nhân là một LLM mạnh hơn.
Các nghiên cứu liên quan cho thấy rằng nếu bạn có thể giới hạn mức độ cấu kết giữa các tác nhân, bạn có thể đạt được kết quả tốt hơn. Kết luận này có thể áp dụng trực tiếp cho an toàn AI.
Đây là một trong những ý tưởng thú vị nhất mà Vitalik đã chia sẻ gần đây. Vấn đề cốt lõi của an toàn AI là: làm thế nào để con người kiểm soát một hệ thống thông minh hơn chính mình?
Câu trả lời mà crypto đã học được qua nhiều năm: đừng kiểm soát bằng cách tin tưởng, hãy kiểm soát bằng thiết kế cơ chế. Các cơ chế đối kháng trong đó các bên có lợi ích mâu thuẫn và giám sát lẫn nhau đã chứng minh hiệu quả trong các giao thức blockchain.
Áp dụng logic này cho AI là một cách tiếp cận mới. Thay vì cố gắng "dạy" AI trở nên tốt, chúng ta có thể thiết kế các môi trường nơi các tác nhân AI kiểm tra và ràng buộc lẫn nhau.
Theo bạn, cơ chế đối kháng có thể là một giải pháp thực sự cho an toàn AI, hay chỉ là một cách tiếp cận mang tính lý thuyết?
Tin tức chỉ để tham khảo, không phải lời khuyên đầu tư. Vui lòng đọc kỹ trước khi đưa ra quyết định.
Vitalik Buterin vừa đưa ra một so sánh đáng chú ý: lý thuyết thiết kế cơ chế đối kháng quen thuộc trong crypto có thể là một ứng dụng quan trọng cho an toàn AI.
Cả hai lĩnh vực đều có cấu trúc nhị phân sâu sắc giữa bên ủy quyền (principal) và tác nhân (agent):
Trong crypto: Bên ủy quyền là một thuật toán tĩnh (năng lực yếu), còn tác nhân là con người (năng lực mạnh hơn).
Trong AI: Bên ủy quyền là một con người và một LLM yếu hơn, còn tác nhân là một LLM mạnh hơn.
Các nghiên cứu liên quan cho thấy rằng nếu bạn có thể giới hạn mức độ cấu kết giữa các tác nhân, bạn có thể đạt được kết quả tốt hơn. Kết luận này có thể áp dụng trực tiếp cho an toàn AI.
Đây là một trong những ý tưởng thú vị nhất mà Vitalik đã chia sẻ gần đây. Vấn đề cốt lõi của an toàn AI là: làm thế nào để con người kiểm soát một hệ thống thông minh hơn chính mình?
Câu trả lời mà crypto đã học được qua nhiều năm: đừng kiểm soát bằng cách tin tưởng, hãy kiểm soát bằng thiết kế cơ chế. Các cơ chế đối kháng trong đó các bên có lợi ích mâu thuẫn và giám sát lẫn nhau đã chứng minh hiệu quả trong các giao thức blockchain.
Áp dụng logic này cho AI là một cách tiếp cận mới. Thay vì cố gắng "dạy" AI trở nên tốt, chúng ta có thể thiết kế các môi trường nơi các tác nhân AI kiểm tra và ràng buộc lẫn nhau.
Theo bạn, cơ chế đối kháng có thể là một giải pháp thực sự cho an toàn AI, hay chỉ là một cách tiếp cận mang tính lý thuyết?
Tin tức chỉ để tham khảo, không phải lời khuyên đầu tư. Vui lòng đọc kỹ trước khi đưa ra quyết định.