


Tiêu đề gốc: (Kỳ lân AI pháp lý định giá 1,1 tỷ USD do OpenAI đầu tư, bắt đầu “bọc vỏ” mô hình mã nguồn mở của Trung Quốc)
Tác giả gốc: Dongcha Beating
Ngày 20 tháng 8, công ty AI pháp lý Harvey do OpenAI đầu tư đã ra mắt Tenet. Công ty được thành lập vào năm 2022 này hiện có định giá 11 tỷ USD, là công ty AI pháp lý định giá cao nhất toàn cầu. Tenet phục vụ hàng nghìn tổ chức, và trong danh sách cổ đông còn có Sequoia, a16z và GIC.
Tenet là bộ mô hình tự phát triển đầu tiên của nó, nền tảng sử dụng Kimi K3 với trọng số được Moonshot AI mở vào tháng 7. Hiện Tenet vẫn đang ở giai đoạn nghiên cứu preview, và Harvey dự định đưa dần các năng lực đã được xác minh trong đó vào sản phẩm.
Nhà sáng lập của Harvey, Winston Weinberg, ban đầu là luật sư kiện tụng của O'Melveny & Myers; Gabe Pereyra từng làm nghiên cứu mô hình ngôn ngữ lớn ở Google Brain và Meta. OpenAI đã đầu tư vào họ từ rất sớm; sau đó hai bên cũng cùng huấn luyện một mô hình về án lệ, đưa vào huấn luyện dữ liệu án lệ Mỹ khoảng 10 tỷ token. Trong các case nghiên cứu khách hàng mà OpenAI công bố lúc đó, Pereyra nói Harvey đã đánh giá nhiều phương án và cuối cùng chỉ tin tưởng phương án hoàn thành riêng này khi hợp tác cùng OpenAI để huấn luyện tùy chỉnh.
Trong vài năm qua, gần như nó luôn là khách hàng tiêu biểu nhất của các mô hình đóng (closed-source) trong ngành dịch vụ chuyên nghiệp—và cũng luôn có thể gọi tới một nhóm mô hình đóng mạnh nhất toàn cầu. Nhưng lần đầu tiên khi nó quyết định thực sự “viết” nhiệm vụ pháp lý của mình, tiêu chí chấm điểm của luật sư và lượng tính toán trong 2 tháng đó vào một bộ trọng số, thì cái “đế” được chọn lại là một mô hình trọng số mở đến từ Trung Quốc.
Sau khi một mô hình được phát hành, ngành sẽ rất nhanh biết được hai điều. Nó thông minh đến mức nào, và những năng lực đó bán giá bao nhiêu. Chỉ trong vài giờ, kết quả cập nhật của benchmark, thay đổi thứ hạng Arena, và các biểu đồ tọa độ đủ loại về thông minh/thị giá bắt đầu được lan truyền. Một mô hình được huấn luyện hàng tháng và tiêu tốn lượng lớn tính toán cuối cùng chỉ còn bị nén thành một điểm trên biểu đồ.
Với đa số nhà phát triển, cách tiếp cận này vẫn còn hiệu lực. Tiền đề đằng sau là khi mô hình được bàn giao cho người dùng, năng lực đã gần như được “đóng hình”. Khi API đóng nguồn chiếm ưu thế, tiền đề này là đúng. Các công ty mô hình sẽ hoàn thành tiền huấn luyện và huấn luyện tiếp sau, rồi bọc năng lực đó thành một giao diện (API). Doanh nghiệp ở tầng dưới có thể thay đổi prompt, làm truy hồi, hoặc xây dựng agent, nhưng rất khó thay đổi chính bản thân mô hình.
Các trọng số mở đã phá vỡ tiền đề đó. Khi doanh nghiệp có được trọng số, họ có thể tiếp tục đưa dữ liệu và phản hồi của chuyên gia của chính mình vào để huấn luyện, mang “đúng nhiệm vụ thật” và “đúng tiêu chí đánh giá” vào quá trình huấn luyện. Cùng là hai mô hình khi phát hành được 90 điểm, sử dụng cùng một lô dữ liệu và cùng một lượng tính toán; một mô hình dừng ở 91 điểm, mô hình còn lại có thể đạt 97 điểm. Với những công ty dự định đầu tư vài tháng thời gian, tài nguyên tính toán và nguồn lực chuyên gia, hai mô hình phát hành cùng đạt 90 điểm nhưng khác biệt đến mức trời vực.
Tuy nhiên, có một điều kiện tiên quyết. Doanh nghiệp sẵn sàng bỏ ra vài tháng thời gian và một lượng tính toán để tiếp tục huấn luyện, thì trước hết họ phải có một bộ trọng số đáng để huấn luyện. Trong vài năm qua, giữa các mô hình mở và các mô hình đóng nguồn tiên tiến nhất luôn tồn tại một khoảng cách. Khoảng cách này không quá lớn trong các tác vụ hỏi đáp phổ thông và viết code hằng ngày; nhưng khi bước vào bối cảnh chuyên môn có chi phí sai lầm rất cao, khoảng cách đó sẽ được khuếch đại. Pháp luật lại là một trong những lĩnh vực đòi hỏi cao nhất. Những công ty từng có thể thực sự đưa vào hoạt động cốt lõi của mình như Harvey trong quá khứ, về cơ bản đều dựa vào các mô hình đóng nguồn mạnh nhất thời điểm đó. Trọng số mở đương nhiên dễ kiểm soát và tùy biến hơn; nhưng nếu ngay cả nhiệm vụ chuyên môn cơ bản nhất còn không hoàn thành được, thì cũng không có không gian để nói về “huấn luyện tiếp sau” phía sau.
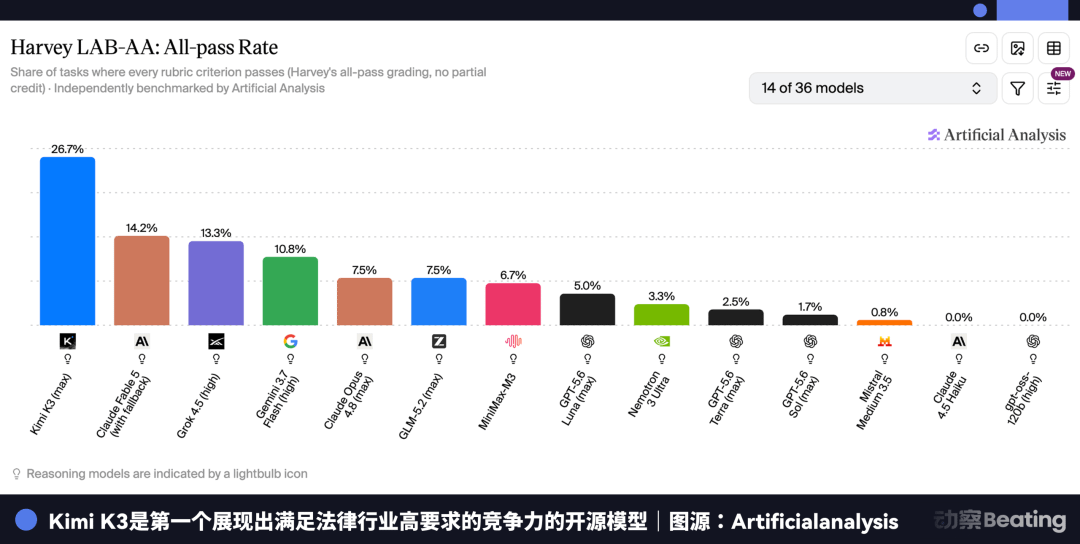
Kimi K3 lần đầu tiên vượt qua ngưỡng “khó nhảy” tồn tại lâu nay. Tổng số tham số đạt 2.8 nghìn tỷ, hỗ trợ ngữ cảnh 1 triệu token, và đã sẵn năng lực nền tảng khá tốt cho nhiệm vụ tầm xa, sử dụng công cụ và suy luận phức tạp. Với Harvey, mô hình trọng số mở lần đầu không còn chỉ là một phương án thay thế rẻ hơn và có quyền kiểm soát nhiều hơn; nó bắt đầu bước vào phạm vi có thể được đánh giá nghiêm túc cùng các mô hình tiên phong.
Thế là họ bắt đầu quan tâm tới một vấn đề trước đây rất ít khi được đem ra thảo luận riêng: các trọng số này rốt cuộc dễ được huấn luyện tiếp sau đến mức nào.
Khi huấn luyện Composer 2, Cursor không chọn mô hình theo danh sách bảng xếp hạng tác nhân lập trình thông thường. Lý do của họ là năng lực về tác nhân và nhiệm vụ tầm xa sẽ thay đổi rất lớn trong quá trình học tăng cường, nên thứ hạng trước huấn luyện có thể không dự đoán được kết quả cuối cùng. So với điểm theo bảng xếp hạng, Cursor coi trọng kiến thức lập trình của mô hình, khả năng theo dõi trạng thái, mức độ bối rối (uncertainty/confusion) của mô hình trên kho mã nội bộ, và hiệu suất của nó khi chạy trên hạ tầng của chính Cursor. Cuối cùng, “đế” (foundation model) được chọn là mô hình Kimi K2.5.
Cognition đứng sau Devin cũng có cùng phán đoán. Sau khi K3 mở trọng số, họ nhanh chóng kết nối mô hình vào Devin Desktop và CLI; trên hệ thống FrontierCode 1.1 Extended của chính mình, K3 đạt 58.2% điểm và 63.6% tỷ lệ pass. Bộ kiểm thử này đánh giá các tác vụ kỹ thuật thực; liệu code cuối cùng có nhập được vào nhánh chính hay không, chất lượng có đủ hay không đều được tính đến. Cognition cũng nói rằng K3 thể hiện đặc biệt tốt trong việc tái hiện bug và quản lý môi trường chạy của riêng nó—và đúng hai việc này lại là những mắt xích dễ “đứt gãy” nhất trong các nhiệm vụ lập trình tầm xa. Sau đó, họ cũng thực hiện huấn luyện tiếp sau trên chính bộ trọng số này.
Thứ thực sự khan hiếm không phải là dữ liệu pháp luật
Harvey tăng trưởng rất nhanh. Năm nay tháng 3, họ phục vụ khoảng 1300 tổ chức và hơn 100.000 luật sư; chỉ sau năm tháng, số lượng khách hàng đã tăng gần gấp đôi, phủ 70 quốc gia. Trong số các hãng luật AmLaw 100, hơn 3/4 đang sử dụng Harvey.
Các dự án dịch vụ pháp lý có giá trị lớn và khả năng chịu lỗi thấp. Một báo cáo thẩm định sáp nhập và mua lại có thể cần tìm điều khoản thay đổi quyền kiểm soát trong hàng trăm, hàng nghìn tài liệu, đánh giá giao dịch có kích hoạt hay không, và sau đó nhận diện rủi ro kèm căn cứ theo nguyên văn. Thông thường có hàng chục phán đoán cần đúng liên tiếp; chỉ cần bỏ sót một vấn đề thực sự ảnh hưởng đến giao dịch thì phần lớn công việc làm đúng ở phía trước cũng không còn ý nghĩa nhiều.
Khi số lượng hãng luật sử dụng dịch vụ ngày càng nhiều, Harvey cũng tích lũy được một loại dữ liệu mà các công ty mô hình nền tảng khó tự có. Nó biết luật sư sẽ sắp xếp công việc theo cách nào, và nó cũng biết các đối tác sẽ chọn chỗ nào để bắt lỗi ở kết quả cuối cùng.
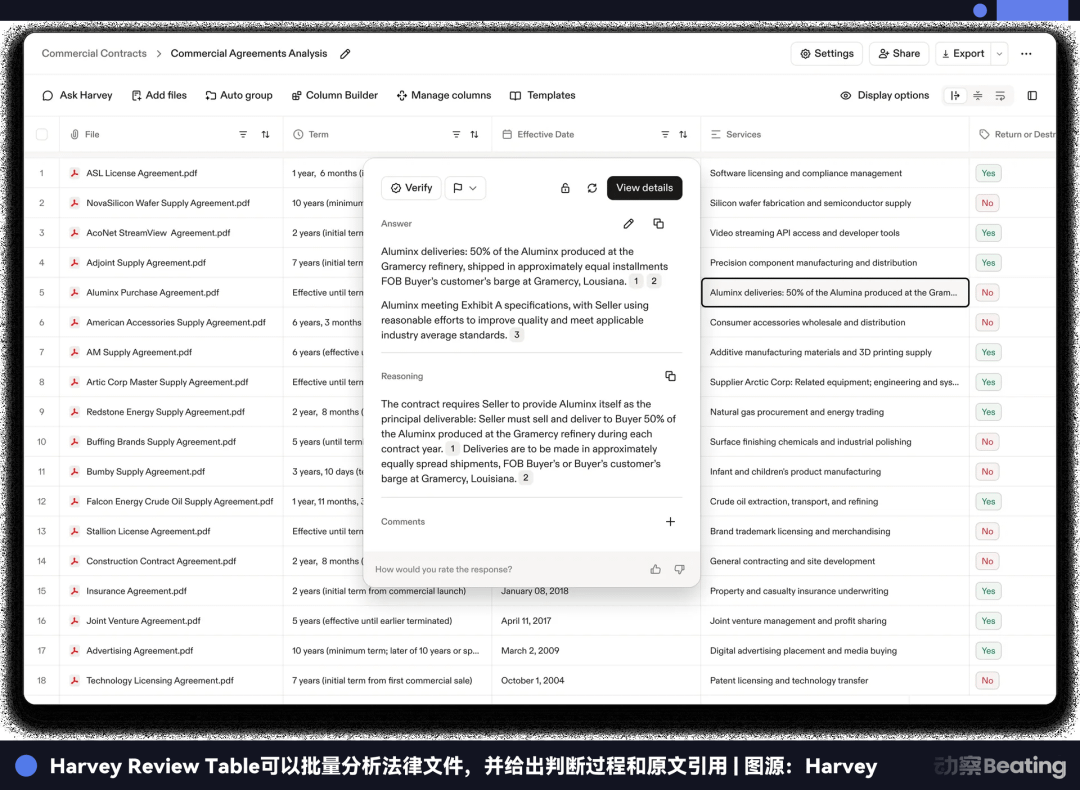
Những kinh nghiệm này sau đó được biến thành Legal Agent Benchmark. Bên trong có hơn 1200 nhiệm vụ pháp lý tầm xa (long-range), bao phủ 24 lĩnh vực hành nghề. Mỗi nhiệm vụ có mô tả trung bình chỉ khoảng 50 từ; sau đó mô hình sẽ bước vào một môi trường “sự việc của khách hàng” khép kín. Các tài liệu liên quan và nhiều nội dung không liên quan bị trộn lẫn với nhau; nó cần tự tìm kiếm, đọc, đánh giá, rồi cuối cùng trả ra một kết quả có thể được kiểm tra theo từng mục.
Mỗi nhiệm vụ trung bình có khoảng 50 tiêu chí chấm điểm; các nhiệm vụ phức tạp có thể lên tới vài trăm tiêu chí. Việc có tìm đủ sự thật không, kết luận có đúng hay không, trích dẫn có khớp với nguyên văn không, mức độ rủi ro và khuyến nghị có hợp lý không… tất cả đều được tách thành các hạng mục chấm điểm có thể đánh giá độc lập. Một nhiệm vụ dài nhất có thể kéo dài hơn 1000 vòng, tiêu tốn hàng chục vạn token.
Sau vài năm làm việc, các luật sư trẻ dần hiểu khách hàng thực sự lo điều gì, và họ cũng nhớ những điều khoản tưởng như không quan trọng mà không được bỏ sót. Những kinh nghiệm này trước đây rất khó ghi đầy đủ vào giáo trình; phần lớn nằm lại trong các bản chỉnh sửa của đối tác, thói quen làm việc nội bộ của nhóm, và từng bộ hồ sơ đã được bàn giao.
Harvey tách một phần trong đó thành nhiệm vụ, tài liệu và tiêu chí chấm điểm. Mỗi lần mô hình hoàn thành một công việc, quá trình ấy sẽ tạo ra phản hồi có thể được tính toán và so sánh.
Prompt và truy vấn (retrieval) có thể cho mô hình biết đi đâu tìm; còn tiêu chí chấm điểm bắt đầu trả lời một câu hỏi khác: một công việc pháp lý rốt cuộc cần đạt mức nào thì được xem là hoàn thành. Những gì Harvey tích lũy được trong vài năm qua—ngoài khách hàng và dữ liệu pháp luật—còn có một hệ thống đánh giá chuyên môn có thể dùng trực tiếp cho huấn luyện mô hình.
Viết kinh nghiệm pháp lý vào trọng số
Những nhiệm vụ và tiêu chí chấm điểm bắt đầu được đưa vào huấn luyện một cách thực sự. Dữ liệu đến từ các tài liệu pháp lý công khai, dữ liệu tổng hợp và dữ liệu từ chuyên gia con người; luật sư hành nghề tham gia xây dựng nhiệm vụ, chấm điểm và rà soát lại dữ liệu tổng hợp. Harvey đã chuẩn bị tổng cộng khoảng 1750 môi trường nhiệm vụ cho các Legal agent.
Sau khi mô hình bước vào không gian làm việc có tài liệu và công cụ, nó phải tự đọc tài liệu, gọi công cụ và nộp kết quả; hệ thống sau đó lại kiểm tra toàn bộ quỹ đạo công việc theo các tiêu chuẩn do luật sư đặt ra. Nó xem rõ từng yêu cầu được hoàn thành đến mức nào và vấn đề pháp lý đã được giải quyết đến đâu. Nếu mọi yêu cầu then chốt đều qua hết, nó sẽ nhận thêm phần thưởng.
Mỗi chu kỳ huấn luyện tạo ra hơn một vạn quỹ đạo nhiệm vụ. Harvey dùng chiến lược sắp xếp theo chuỗi (group/sequence strategy) để tối ưu, tức GSPO: để mô hình sinh ra nhiều cách làm khác nhau trên cùng một nhiệm vụ, rồi dựa vào chênh lệch chất lượng giữa các kết quả để cập nhật trọng số. Khi điểm hai quỹ đạo quá gần nhau, hệ thống còn chấm lại, giảm ảnh hưởng của nhiễu đánh giá đến quá trình huấn luyện.
Toàn bộ quá trình kéo dài khoảng hai tháng, sử dụng khoảng 150 thẻ NVIDIA B300. Việc tiền huấn luyện một mô hình tiên tiến thường cần hơn vạn thẻ; lượng tính toán Harvey lần này đầu tư là một bậc khác. Harvey dùng rank-64 LoRA, bao phủ các lớp attention của Kimi K3, mạng feed-forward và trọng số bộ định tuyến của các chuyên gia, liên quan đến khoảng 500.000 tensor chuyên gia.
Huấn luyện với quỹ đạo dài còn đối mặt với một vấn đề kỹ thuật. Một nhiệm vụ pháp lý có thể kéo dài hàng trăm vòng; khi mô hình đang sinh quỹ đạo nhiệm vụ, trọng số ở phía huấn luyện đã được cập nhật. Khi bộ huấn luyện quay lại tính toán cho quỹ đạo đó, nếu trạng thái mô hình ở hai phía không khớp, thì xác suất tương ứng với mỗi bước hành động tại thời điểm đó sẽ thay đổi, khiến phần thưởng rất khó “chấm” chính xác vào các quyết định ban đầu.
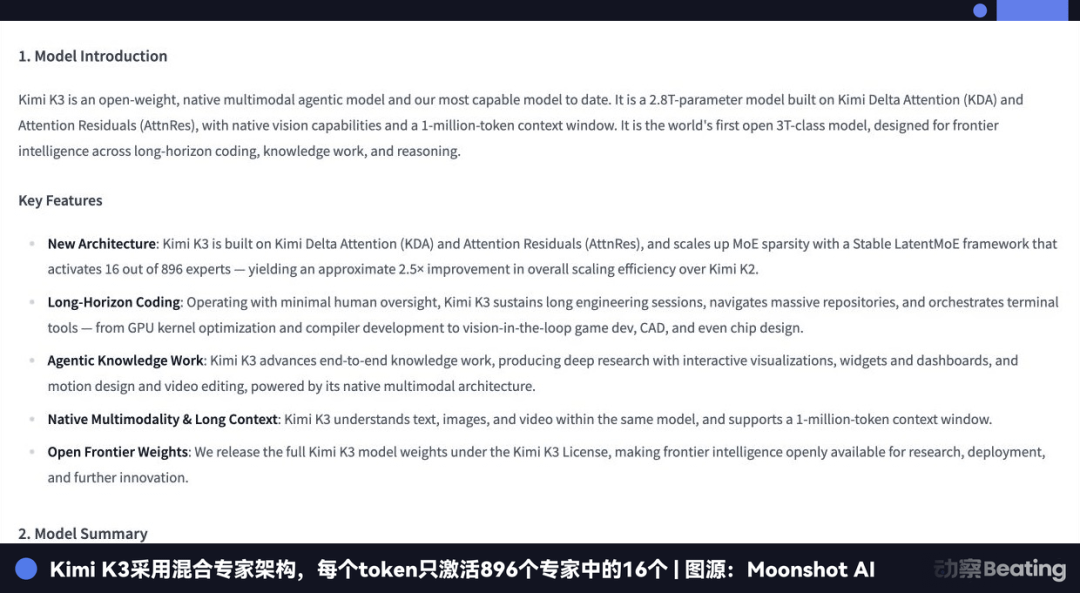
Kiến trúc hỗn hợp chuyên gia (mixture of experts) của Kimi K3 khiến vấn đề này phức tạp hơn. Mỗi token đi vào mô hình, bộ định tuyến sẽ chọn 16 trong số 896 chuyên gia để tham gia tính toán. Chỉ cần phía huấn luyện và phía thực thi có khác biệt nhỏ về độ chính xác số hoặc cách batch, cùng một token cũng có thể được gán cho các chuyên gia khác nhau, khiến quỹ đạo ban đầu khó có thể tái hiện trọn vẹn.
Vì vậy, Harvey và các nhà cung cấp đã thực hiện việc “đồng bộ số học” (numerical alignment) giữa máy huấn luyện và môi trường thực thi ở tầng lõi (kernel). Mỗi lần trọng số cập nhật xong sẽ được hot-load trực tiếp vào môi trường thực thi, không cần dừng lại tạo nhiệm vụ lặp đi lặp lại. Hệ thống cũng ghi lại kết quả định tuyến của chuyên gia tương ứng với token; khi máy huấn luyện tính lại, nó có thể quay lại càng gần càng tốt quỹ đạo mà mô hình đã đi khi tạo ra các token đó.
Đến đây, Tenet đã không còn giống một lần “nhét” (fine-tune) dữ liệu ngữ liệu pháp lý vào mô hình theo kiểu micro-tuning thường thấy. Harvey đang xây dựng một quy trình huấn luyện có thể chạy đi chạy lại. Nhiệm vụ pháp lý liên tục đi vào môi trường, mô hình hoàn thành công việc, tiêu chuẩn đánh giá theo luật sư sẽ chấm toàn bộ quỹ đạo, trọng số sau đó được cập nhật, rồi mô hình mới quay lại môi trường để thực hiện vòng nhiệm vụ tiếp theo.
Khả năng Kimi K3 có được huấn luyện tiếp sau một cách ổn định hay không cũng được kiểm chứng thực tế trong chính vòng lặp như vậy.
Sau khi huấn luyện, nó giống hơn một Legal Agent
Thứ Harvey thực sự muốn nâng cao là năng lực hoàn thành các công việc pháp lý tầm xa. Họ áp dụng một tiêu chuẩn all-pass rất nghiêm ngặt: mọi tiêu chí chấm điểm then chốt trong một nhiệm vụ đều phải vượt qua hết. Theo kết quả nội bộ mà Harvey công bố, trên bộ LAB giữ lại chưa tham gia huấn luyện, số lượng nhiệm vụ Tenet hoàn thành đầy đủ (full completion) gần gấp hai lần so với Kimi K3 gốc; tỷ lệ all-pass tăng từ khoảng 11% lên 19.7%, tức tăng thêm khoảng 9 điểm phần trăm.
Trong các LAB Contracts chuyên dùng để kiểm thử soạn thảo, rà soát và đàm phán hợp đồng, số lượng nhiệm vụ hoàn thành tăng khoảng 20%, tỷ lệ all-pass đạt 11.3%, tăng khoảng 2 điểm phần trăm. Theo bảng xếp hạng nội bộ của chính Harvey, Tenet đứng thứ nhất trong LAB Contracts và đứng thứ hai trong bộ LAB đầy đủ.
Sau đó họ lại đưa Tenet vào hai bộ kiểm thử bên ngoài: Mercor’s APEX Agents Corporate Law và Crosby’s Redline Bench. Bộ trước kiểm tra các nhiệm vụ chuyên môn tầm xa trong môi trường công việc; bộ sau yêu cầu mô hình sửa hợp đồng liên tục, rồi chấm điểm theo các tiêu chuẩn do luật sư đặt ra.
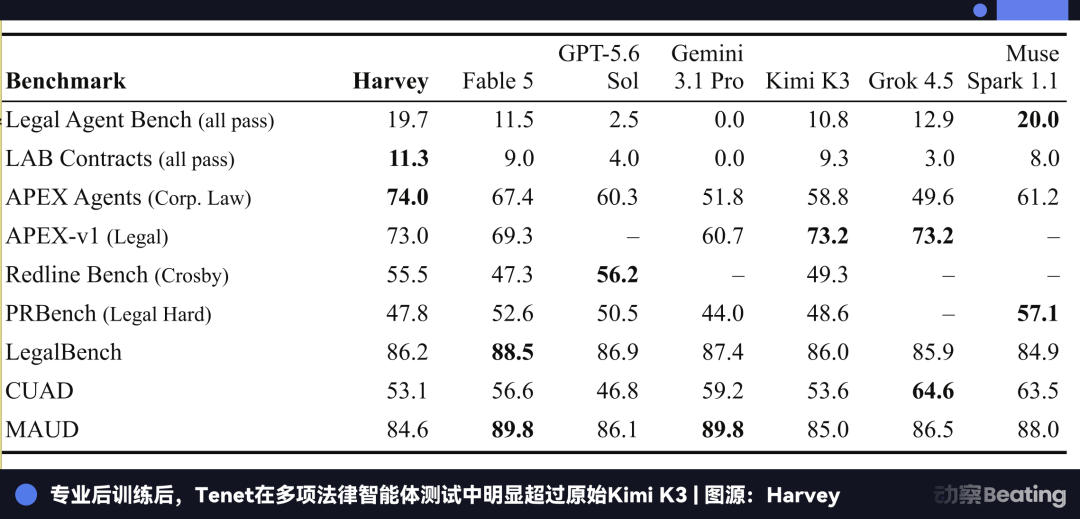
Tenet chưa từng được tiếp xúc dữ liệu huấn luyện của hai bộ kiểm thử này; điểm số vẫn cao rõ rệt so với Kimi K3 gốc, cho thấy các năng lực được luyện trong môi trường nhiệm vụ của Harvey có thể chuyển giao sang các nhiệm vụ pháp lý mới.
Tuy nhiên, vấn đề khác là việc “huấn luyện tiếp sau” thường khiến mô hình ngày càng giỏi hơn ở một nhóm công việc nhất định, đồng thời lại đánh mất một phần kiến thức và năng lực suy luận ban đầu.
Trên LegalBench, CUAD và MAUD, Tenet không có dấu hiệu suy giảm rõ rệt. Ở cụm khó của Scale Professional Reasoning Benchmark, điểm số thậm chí tăng nhẹ từ 36.0% lên 36.8%. Ít nhất nhìn từ nhóm kết quả này, sau khi Kimi K3 mạnh hơn ở nhiệm vụ pháp lý, không xuất hiện vấn đề “quên năng lực” đáng kể.
Thiết kế phần thưởng của Harvey sẽ ưu tiên quỹ đạo ngắn hơn khi chất lượng kết quả gần tương đương, vì mỗi lần agent pháp lý đọc thêm một tài liệu hay gọi thêm một công cụ là lại làm tăng tiêu hao token và thời gian chờ. Sau khi huấn luyện, Tenet giảm được một phần bước không hiệu quả; trong khi chất lượng nhiệm vụ tăng lên thì chi phí hoàn thành công việc về cơ bản vẫn giữ ổn định.
Điểm thay đổi nhiều nhất trong lần huấn luyện tiếp sau này là cách Kimi K3 xử lý các công việc pháp lý phức tạp. Nó biết sắp xếp các bước hợp lý hơn, gọi công cụ tốt hơn, và ít bỏ sót các yêu cầu then chốt trong nhiệm vụ hơn.
Harvey từ năm 2025 đã bắt đầu dùng chiến lược đa mô hình; năm nay vẫn tiếp tục tích hợp các mô hình mới của OpenAI và Anthropic. Cuối cùng Tenet đã thêm lần đầu một mô hình trọng số mở do chính Harvey tự huấn luyện và tự kiểm soát vào hệ thống này.
Thứ nó cần là một mô hình nền tảng vốn đã đạt chuẩn. Nhiệm vụ pháp lý của Harvey có thể phải xử lý lượng lớn tài liệu, thực thi liên tục vài trăm thậm chí hơn một nghìn vòng; trong suốt công việc kéo dài, mô hình còn phải duy trì trạng thái. Huấn luyện tiếp sau có thể tiếp tục “định hình” cách nó xử lý công việc pháp lý, nhưng rất khó có thể từ đầu bổ sung một bộ năng lực mà nền tảng ban đầu vốn không có.
Một điều kiện khác là quyền kiểm soát. Harvey có thể gọi GPT và Claude qua API, nhưng không thể tiếp tục đưa 1750 môi trường nhiệm vụ pháp lý và tiêu chí đánh giá của luật sư vào các mô hình đóng nguồn đó. Trọng số mở cho phép họ tự quyết định cách huấn luyện và cách thiết kế phần thưởng; đồng thời cũng giữ lại năng lực chuyên môn đã luyện được trong các trọng số mà họ tự nắm giữ.
Tuy nhiên, sau khi đã có trọng số, còn phải xem mô hình này có phù hợp để huấn luyện tiếp sau nữa hay không. Học tăng cường với quỹ đạo dài có chạy ổn định được không, định tuyến của hỗn hợp chuyên gia có thể tái hiện chính xác được không, sau khi năng lực chuyên môn tăng lên có làm mất kiến thức ban đầu hay không, chi phí suy luận có còn nằm trong phạm vi sử dụng được cho sản xuất hay không—tất cả đều phải thử thực sự một lần mới biết.
Sau khi chạy xong hai tháng, Kimi K3 cho ra đáp án của vòng này. Quá trình huấn luyện có thể chạy ổn định, năng lực nhiệm vụ pháp lý tăng rõ rệt, không thấy hiện tượng quên năng lực đáng kể, và chi phí cũng không bị “mất kiểm soát” cùng với hiệu quả.
Đối với Harvey, các kết quả này quan trọng hơn bản thân cụm từ “trọng số mở”. Trọng số có thể tải xuống—chỉ cho thấy doanh nghiệp có tư cách tiếp tục huấn luyện. Sau huấn luyện còn lưu lại được bao nhiêu năng lực, thì mới quyết định liệu bộ mô hình này có đáng tiếp tục đầu tư tính toán, dữ liệu và thời gian của chuyên gia hay không.
Một mảng kinh doanh khác của công ty mô hình
Harvey nói mục tiêu của họ là giúp các hãng luật có thể huấn luyện mô hình độc quyền của riêng mình trên các trọng số mở (open weights), và có được năng lực hình thành sau khi huấn luyện. Tenet không phải là một tập hợp mô hình, mà đúng hơn là một phương pháp.
Trước đây, công việc kinh doanh của các công ty mô hình nền tảng chủ yếu diễn ra ở phần “gọi” sau khi mô hình được phát hành. Trọng số mở tạo ra một mối quan hệ khác: một công ty có thể lấy mô hình nền tảng sẵn có để tiếp tục huấn luyện, đưa kiến thức chuyên ngành của mình vào trọng số, cuối cùng nhận được một bộ mô hình gần với hoạt động kinh doanh của chính họ hơn.
Trước đây, dạng nhu cầu này rất khó hình thành một thị trường thực sự. Khi năng lực của mô hình tổng quát chưa đủ mạnh, dù công ty dọc (vertical) có lấy được trọng số đi nữa thì cũng khó chỉ bằng huấn luyện tiếp sau để bù đầy suy luận tầm xa, gọi công cụ và xử lý các tác vụ phức tạp. Tiền huấn luyện lại từ đầu thì quá đắt; đa số công ty cũng không cần làm.
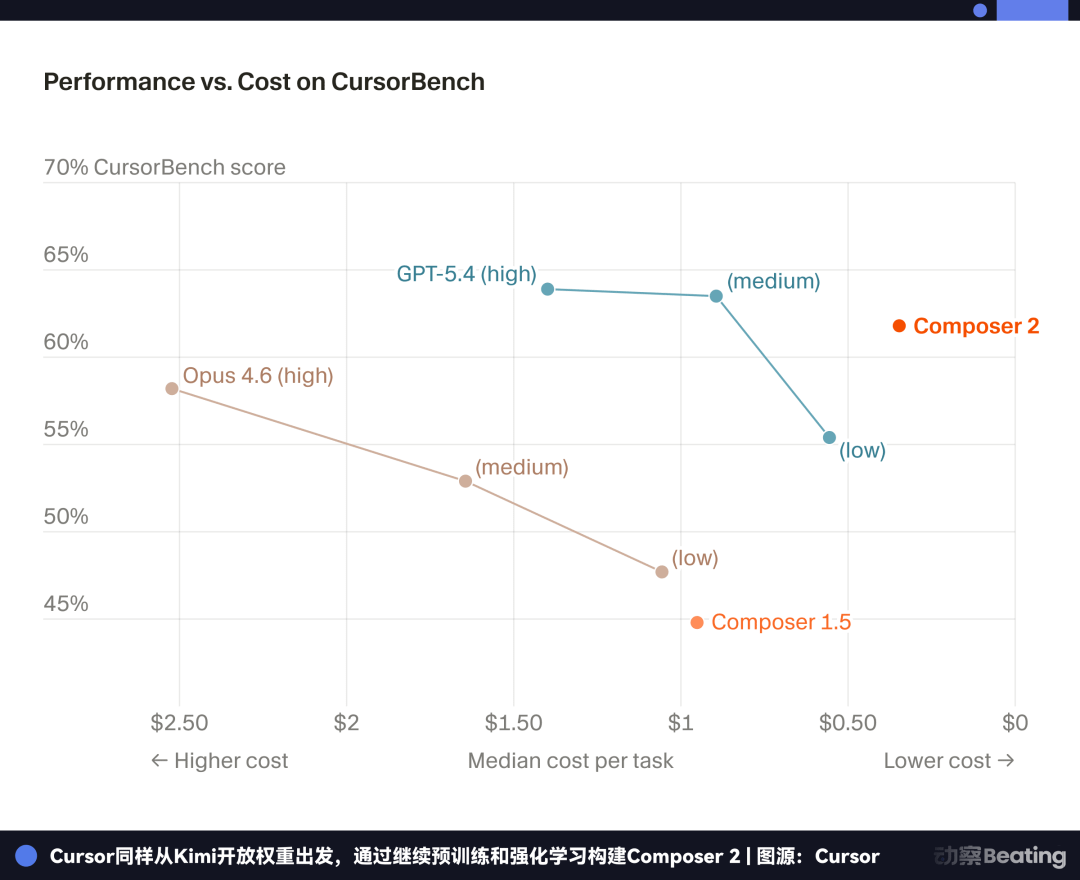
Cursor đã huấn luyện Composer 2 trong lập trình; Cognition cũng tiếp tục huấn luyện mô hình mà Devin sử dụng trên cùng một bộ trọng số. Còn Harvey thì trong lĩnh vực pháp lý đã tạo ra Tenet. Lập trình và pháp luật cách xa nhau, nhưng cả hai đều chọn xuất phát từ năng lực tổng quát đã được Kimi huấn luyện, rồi đưa tiếp vào phần công việc chuyên môn mà họ am hiểu nhất.
Tenet cũng giúp cụ thể hóa ngưỡng của việc này. Chỉ cần 2 tháng, khoảng 150 thẻ (cards), cộng với một bộ tiêu chí đánh giá do các luật sư hành nghề định nghĩa, một công ty đã có thể đẩy một bộ trọng số phổ quát lên “đỉnh” trong ngành của mình. Ngưỡng tính toán đã giảm đi một bậc độ lớn; phần khó bắt chước hơn bắt đầu nằm ở đầu bên kia: làm rõ được rằng một công việc chuyên môn cần đạt đến mức nào mới được xem là hoàn thành.
Phát triển phần mềm và pháp luật chỉ là hai ví dụ đã xuất hiện. Tài chính, tư vấn, dược phẩm, kế toán, cũng như vô số ngành dịch vụ chuyên nghiệp khác đều có dữ liệu, quy trình làm việc và năng lực phán đoán của chuyên gia riêng. Bản thân các ngành đó chính là thị trường công việc trí thức quy mô tính bằng hàng nghìn tỷ đô la. Nhóm công ty đứng đầu có thể không tự ý tiền huấn luyện mô hình nền tảng, nhưng ngày càng có điều kiện để tiếp tục huấn luyện thêm trong một bộ trọng số đã trưởng thành nhằm tạo ra mô hình thuộc riêng mình.
Nếu lộ trình này tiếp tục đúng, thì thị trường mà Kimi đối mặt sẽ không còn chỉ là “có bao nhiêu người gọi/ sử dụng nó”. Điều đáng theo dõi hơn tiếp theo là sau Harvey, Cursor và Devin, sẽ còn bao nhiêu công ty chọn huấn luyện mô hình của riêng mình trên Kimi.
Liên kết bản gốc