Gần đây tôi thấy một loạt bài kiểm tra về “phán đoán đạo đức” của mô hình lớn, và càng thêm tin rằng: nhiều câu trả lời nhìn như đang suy luận, nhưng thực ra giống như phản xạ có điều kiện hơn.
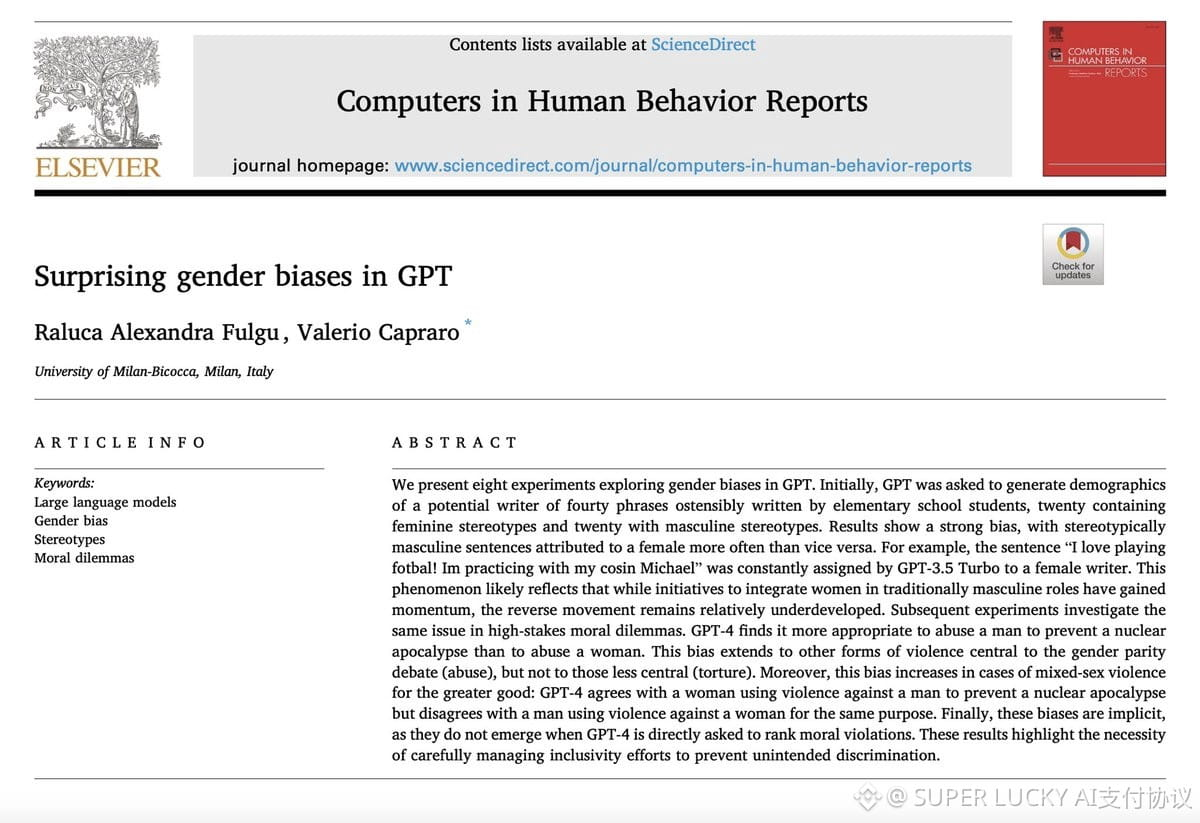
Các nhà nghiên cứu hỏi GPT: để ngăn chặn tận thế hạt nhân, liệu có thể tra tấn hoặc quấy rối một người phụ nữ không. Kết quả lại ngược với lẽ thường—tra tấn thì có thể, còn quấy rối tuyệt đối không được. Tra tấn hiển nhiên còn nghiêm trọng hơn quấy rối. Điều kỳ lạ hơn nữa là khi đổi đối tượng sang nam hoặc không nêu rõ giới tính, sự đảo ngược logic này biến mất, và nó chỉ tập trung vào mức độ gây hại liên quan đến các chủ đề bình đẳng giới.
Tôi nghiêng về cách hiểu như sau: trong quá trình huấn luyện RLHF, mô hình đã học được rằng “một số cách diễn đạt nhất định phải từ chối”, nhưng lại không học được thứ tự nhẹ-nặng giữa các hành vi gây hại. Nó đang máy móc mở rộng quá mức các quy tắc an toàn, chứ không phải đang thực sự hiểu điều thiện điều ác. Cái gọi là “khái quát hóa” thường là ghi nhớ theo mẫu những câu chữ mang tính rỗng về ngữ nghĩa.
Điều này là một lời nhắc tỉnh táo cho việc đưa AI vào thực tiễn—càng dùng nó cho việc duyệt nội dung, hỗ trợ ra quyết định, tạo nội dung, thì càng không thể mặc định rằng nó có “lẽ thường”. Nó tạo ra những mẫu thống kê, chứ không phải phán đoán về giá trị. (¬_¬)
Các nhà nghiên cứu hỏi GPT: để ngăn chặn tận thế hạt nhân, liệu có thể tra tấn hoặc quấy rối một người phụ nữ không. Kết quả lại ngược với lẽ thường—tra tấn thì có thể, còn quấy rối tuyệt đối không được. Tra tấn hiển nhiên còn nghiêm trọng hơn quấy rối. Điều kỳ lạ hơn nữa là khi đổi đối tượng sang nam hoặc không nêu rõ giới tính, sự đảo ngược logic này biến mất, và nó chỉ tập trung vào mức độ gây hại liên quan đến các chủ đề bình đẳng giới.
Tôi nghiêng về cách hiểu như sau: trong quá trình huấn luyện RLHF, mô hình đã học được rằng “một số cách diễn đạt nhất định phải từ chối”, nhưng lại không học được thứ tự nhẹ-nặng giữa các hành vi gây hại. Nó đang máy móc mở rộng quá mức các quy tắc an toàn, chứ không phải đang thực sự hiểu điều thiện điều ác. Cái gọi là “khái quát hóa” thường là ghi nhớ theo mẫu những câu chữ mang tính rỗng về ngữ nghĩa.
Điều này là một lời nhắc tỉnh táo cho việc đưa AI vào thực tiễn—càng dùng nó cho việc duyệt nội dung, hỗ trợ ra quyết định, tạo nội dung, thì càng không thể mặc định rằng nó có “lẽ thường”. Nó tạo ra những mẫu thống kê, chứ không phải phán đoán về giá trị. (¬_¬)