

Hai Ngõ Vào Khác Nhau
Trước đây tôi chỉ nhìn vào quy trình làm việc dựa trên CLI của Newton — tạo CIDs, triển khai, cấu hình, mô phỏng, rồi nộp. Khi xem lại tài liệu, có một lối đi thứ hai, tách biệt: một SDK TypeScript, `@magicnewton/newton-protocol-sdk`, kết hợp với viem, hướng tới các nhà phát triển muốn viết code hơn là chạy lệnh CLI. Khác đối tượng, nhưng cùng một giao thức nền tảng.
Con đường bằng SDK tập trung vào một phương thức gọi là `simulateTask()` — một lần chạy thử (dry run), được ghi rõ là không gửi bất kỳ thứ gì lên onchain, không cần Sepolia ETH và cũng không cần ví. Bạn đưa cho nó một ý định (from, to, value, calldata, chain ID, chữ ký hàm) và một đối tượng `policyTaskData` mô tả sẽ kiểm tra theo chính sách nào, và nó trả về kết quả ngay tại chỗ.
Đó là một cách thử Newton cực kỳ ít rào cản — không cần ví đã được cấp kinh phí, không cần triển khai, không có gì phải đánh đổi. Và đó cũng chính là lý do vì sao ví dụ cụ thể mà phần quickstart đưa cho bạn đáng để xem xét kỹ.
Chính sách Demo mà Ai Cũng Nhận
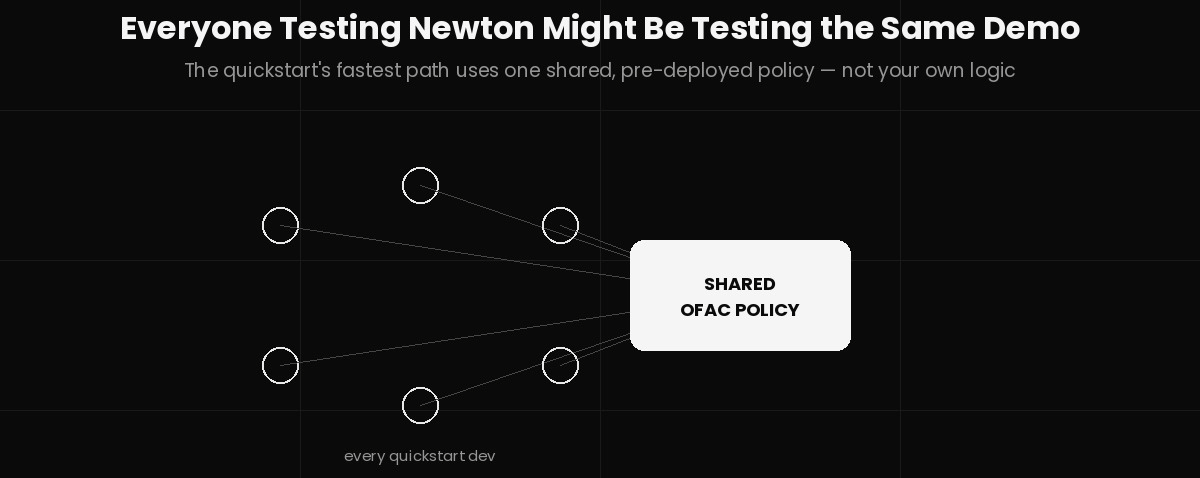
Ví dụ `simulateTask()` trong quickstart không yêu cầu bạn viết một chính sách. Nó trỏ tới một chính sách đã đang chạy: một chính sách sàng lọc lệnh trừng phạt OFAC đã được triển khai sẵn trên Sepolia, với một địa chỉ chính sách cụ thể, một ID chính sách cụ thể, và một địa chỉ oracle danh sách trừng phạt cụ thể — tất cả đều được cung cấp trực tiếp trong tài liệu dưới dạng giá trị có thể copy-paste. Tài liệu nói thẳng: "bạn có thể dùng điều này để thử nghiệm."
Vì vậy, con đường nhanh nhất từ số không đến "Tôi vừa dùng Newton" không liên quan gì đến việc viết logic chính sách. Nó liên quan đến việc gọi một hàm kiểm tra một địa chỉ ví dụ được mã hóa sẵn so với một chính sách do người khác viết, đã triển khai và đang duy trì.
Vì sao điều này đáng chú ý, chứ không phải để chỉ trích
Tôi muốn cẩn thận về giọng điệu ở đây, vì không có gì sai với một bản demo ít gây cản trở — mọi công cụ nghiêm túc đều có một bản như vậy, và việc yêu cầu một nhà phát triển viết và triển khai một chính sách thực trước khi họ có thể đánh giá liệu công cụ đó có đáng với thời gian của họ hay không sẽ tạo ra trải nghiệm onboarding tệ hơn, chứ không phải trải nghiệm chặt chẽ hơn.
Nhưng điều đó cũng đồng nghĩa với việc có một khoảng trống đáng kể giữa hai tuyên bố khác nhau: "Tôi đã thử quickstart của Newton và nó hoạt động" và "Tôi đã kiểm thử logic chính sách của mình dựa trên engine đánh giá của Newton". Tuyên bố thứ nhất, theo thiết kế, là việc một lượng rất lớn nhà phát triển đi theo đúng lộ trình năm phút đó sẽ có thể nói rằng nó đã chạy được, vì sử dụng đúng chính sách đã được xây dựng sẵn và đúng địa chỉ ví dụ. Tuyên bố thứ hai lại yêu cầu bạn viết Rego của riêng mình, triển khai hợp đồng dữ liệu chính sách của riêng bạn, và mô phỏng dựa trên ý định của chính bạn — một mức đầu tư lớn hơn đáng kể so với những gì quickstart yêu cầu bạn phải làm trước khi tuyên bố thành công.
Nơi mà đường đi bằng CLI tách ra
Đó là lý do tôi nghĩ rằng hai con đường tích hợp — SDK-kèm-chính-sách-demo-dùng-chung so với CLI-kèm-chính-sách-do-bạn-triển-khai — thực ra không phải là những điểm khởi đầu có thể hoán đổi để dẫn đến cùng một trải nghiệm. Con đường CLI mà tôi đã xem trước đó buộc bạn phải tự tạo các CIDs và triển khai hợp đồng chính sách của riêng mình trước khi bạn thậm chí đến được bước simulate; không có phím tắt tương đương nào dẫn tới một chính sách đã được nhúng sẵn trong quy trình đó. Ngược lại, đường SDK tối ưu hóa theo hướng khác: nhanh nhất để có cảm giác "nó hoạt động," đổi lại việc lần thành công đầu tiên đó thực sự chưa kích hoạt bất kỳ logic nào do chính bạn viết.
Không có con đường nào sai đối với thứ mà nó đang tối ưu hóa. Nhưng người đánh giá Newton bằng cách làm theo hướng dẫn nhanh của SDK, và người đánh giá nó bằng cách làm theo chuỗi triển khai thông qua CLI, có thể đi đến những mức độ xác minh thực tế khác nhau một cách đáng kể, trong khi cả hai đều có thể nói đúng rằng họ "đã thử".
Phần cần đặt câu hỏi trực tiếp
Tôi không có khả năng nhìn thấy chính xác có bao nhiêu tích hợp trực tiếp (live) hiện vẫn đi qua đúng chính sách demo dùng chung đó, thay vì một chính sách thực sự được tùy chỉnh, hoặc liệu Newton có theo dõi sự khác biệt này nội bộ hay không. Đây là một câu hỏi hợp lý để hỏi trực tiếp: trong số các chính sách đang được đánh giá trên mạng, có bao nhiêu chính sách là logic do nhà phát triển tự viết, và có bao nhiêu vẫn được trỏ đến các ví dụ tham chiếu từ tài liệu. Con số đó sẽ cho bạn biết điều mà cách diễn đạt "X tích hợp đã được phát hành" không cho biết — hệ sinh thái đã thực sự làm phần công việc khó hơn là viết và triển khai quy tắc của riêng họ đến mức nào, so với việc chỉ chạy trên logic demo được mượn mà vẫn hoạt động được.
Điểm tôi cho rằng hợp lý nhất
Một lộ trình năm phút không gây ma sát để "tôi đã dùng Newton" là một thiết kế sản phẩm tốt. Chỉ cần nói chính xác về việc năm phút đó thực sự đã xác minh được điều gì — hệ thống hạ tầng (plumbing) của giao thức có hoạt động hay không, bằng cách dùng chính sách của người khác — thay vì coi đó như bằng chứng rằng logic tuân thủ của riêng bạn, dù cuối cùng nó là gì, đã được kiểm thử một cách đáng kể.