#opg $OPG Vài hôm trước, mình đã thử nghiệm trong chat.opengradient.ai ở số @OpenGradient , cho một số mô hình viết phân tích về tác động của việc mở khóa token đối với lưu thông. Những từ khóa mà mình đưa ra khá tinh vi, và phản hồi từ một số mô hình nổi tiếng thật sự khiến mình ngạc nhiên vì sự khác biệt.
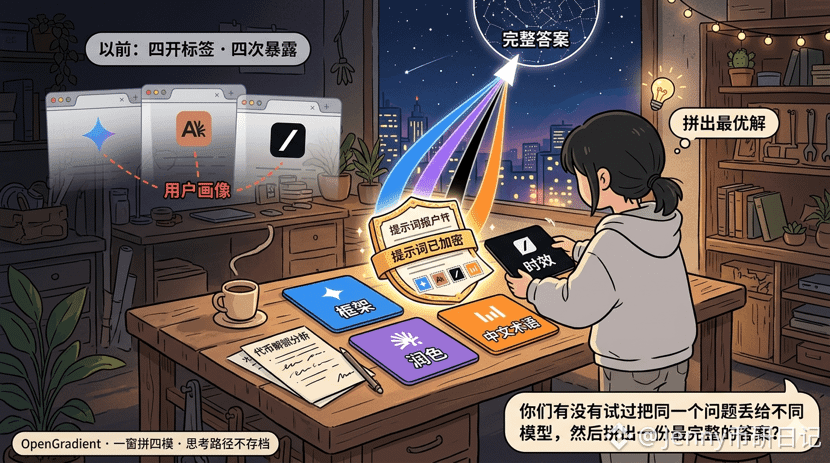
Trước tiên, Gemini đưa ra câu trả lời giống như một báo cáo nghiên cứu, cấu trúc rõ ràng, các điểm dữ liệu chính được liệt kê rất đầy đủ, nhưng đọc vào cảm giác như đang đọc giáo trình. Ngược lại, Claude viết mượt mà hơn, logic giao tiếp rất hiểu chuyện, nhịp điệu của câu dài và ngắn được nắm bắt rất tốt, phù hợp để dán trực tiếp vào PPT. Câu trả lời của Grok ngắn nhất, nhưng lại chèn vào những chủ đề nóng liên quan trên X lúc đó, cảm giác thời sự rất mạnh, tuy nhiên độ sâu thì hơi thiếu một chút. ByteDance Seed nắm vững nhất các thuật ngữ tiếng Trung, một số cách diễn đạt địa phương mà các mô hình khác hoàn toàn không nắm bắt được thần thái.
Điều khiến mình thấy thú vị nhất là mình có thể chuyển đổi giữa các mô hình trong cùng một cuộc trò chuyện. Trước tiên cho Gemini tạo khung, sau đó để Claude chỉnh sửa ngôn ngữ, cuối cùng là Grok bổ sung một câu về bối cảnh thời gian thực. Toàn bộ quá trình không cần phải chuyển trang, và các từ khóa của mình cũng không để lại mảnh vụn giữa các nền tảng.
Trước đây, tình huống này phải mở ba bốn tab trình duyệt, mỗi nền tảng đều lưu lại lịch sử câu hỏi của mình. Khi gộp lại thành một cửa sổ, tiết kiệm được rất nhiều việc, hơn nữa bảo mật là mặc định. Nền tảng không thể thấy mình đang so sánh mô hình nào, cũng không biết mình đang nghiên cứu nhịp độ mở khóa của token nào.
Thế giới này vốn dĩ không có AI hoàn hảo, một mô hình đơn lẻ rất khó để đồng thời đảm bảo tính nghiêm ngặt, dễ đọc và thời sự, bây giờ có thể phân phối chúng theo nhu cầu, và lộ trình suy nghĩ của mình cũng không bị bất kỳ nền tảng nào ghi lại.
Các bạn đã từng thử ném cùng một câu hỏi cho các mô hình khác nhau chưa, rồi ghép lại thành một câu trả lời hoàn chỉnh nhất chưa?