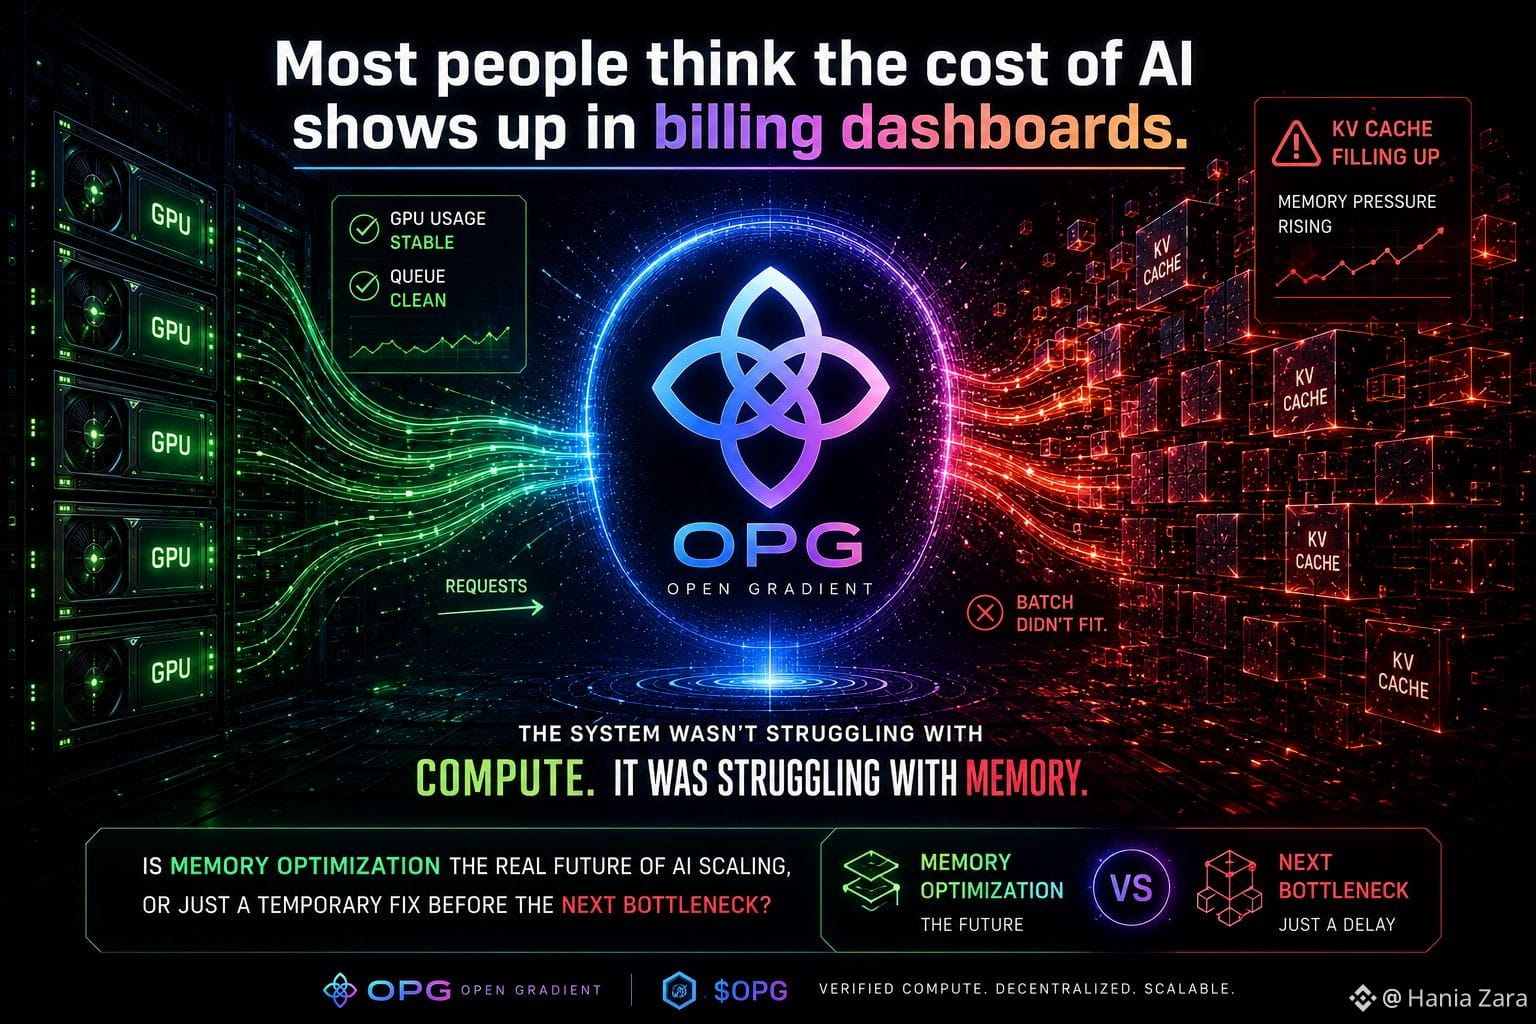
Hầu hết mọi người nghĩ rằng chi phí của AI thể hiện qua các bảng điều khiển thanh toán.
Nhưng thật lòng mà nói… đó không phải là nơi bạn thực sự cảm nhận được.
Lần đầu tiên tôi nhận ra điều này, mọi thứ trông hoàn hảo — mức sử dụng GPU ổn định, hàng đợi sạch sẽ, không có gì đáng lo ngại cả.
Nhưng một lô hàng vẫn không phù hợp.
Và đó là lúc tôi nhận ra… hệ thống không gặp khó khăn với tính toán.
Nó đang gặp khó khăn với bộ nhớ.
Các prompt dài đang âm thầm giữ KV cache như không gian tạm thời mà không bao giờ hoàn toàn giải phóng — từ từ giảm lượng mà hệ thống thực sự có thể xử lý.
Quản lý KV cache dựa trên phân trang cố gắng khắc phục điều này bằng cách chia bộ nhớ thành các trang nhỏ có thể tái sử dụng. Nhiều yêu cầu hơn sẽ phù hợp, các cuộc hội thoại dài không ngay lập tức trở thành nút thắt.
Nhưng đây mới là cuộc tranh luận thực sự:
Liệu điều này có đủ cho tương lai của các hệ thống AI như OpenGradient Chat (https://chat.opengradient.ai)?
Hay chúng ta chỉ đang trì hoãn nút thắt tiếp theo?
Bởi vì việc mở rộng tính toán đã được xác minh với $OPG không chỉ là vấn đề hiệu suất nữa… mà còn là vấn đề kiến trúc.
Vậy bạn nghĩ sao:
👉 Tối ưu hóa bộ nhớ có phải là tương lai thực sự của việc mở rộng AI, hay chỉ là một giải pháp tạm thời?
@OpenGradient
#opengradientchat
#OPG
$OPG
Nhưng thật lòng mà nói… đó không phải là nơi bạn thực sự cảm nhận được.
Lần đầu tiên tôi nhận ra điều này, mọi thứ trông hoàn hảo — mức sử dụng GPU ổn định, hàng đợi sạch sẽ, không có gì đáng lo ngại cả.
Nhưng một lô hàng vẫn không phù hợp.
Và đó là lúc tôi nhận ra… hệ thống không gặp khó khăn với tính toán.
Nó đang gặp khó khăn với bộ nhớ.
Các prompt dài đang âm thầm giữ KV cache như không gian tạm thời mà không bao giờ hoàn toàn giải phóng — từ từ giảm lượng mà hệ thống thực sự có thể xử lý.
Quản lý KV cache dựa trên phân trang cố gắng khắc phục điều này bằng cách chia bộ nhớ thành các trang nhỏ có thể tái sử dụng. Nhiều yêu cầu hơn sẽ phù hợp, các cuộc hội thoại dài không ngay lập tức trở thành nút thắt.
Nhưng đây mới là cuộc tranh luận thực sự:
Liệu điều này có đủ cho tương lai của các hệ thống AI như OpenGradient Chat (https://chat.opengradient.ai)?
Hay chúng ta chỉ đang trì hoãn nút thắt tiếp theo?
Bởi vì việc mở rộng tính toán đã được xác minh với $OPG không chỉ là vấn đề hiệu suất nữa… mà còn là vấn đề kiến trúc.
Vậy bạn nghĩ sao:
👉 Tối ưu hóa bộ nhớ có phải là tương lai thực sự của việc mở rộng AI, hay chỉ là một giải pháp tạm thời?
@OpenGradient
#opengradientchat
#OPG
$OPG