Đã xong việc tìm hiểu tài liệu inference của OpenGradient cho nhiệm vụ này. Có một điều không ngừng ám ảnh tôi.
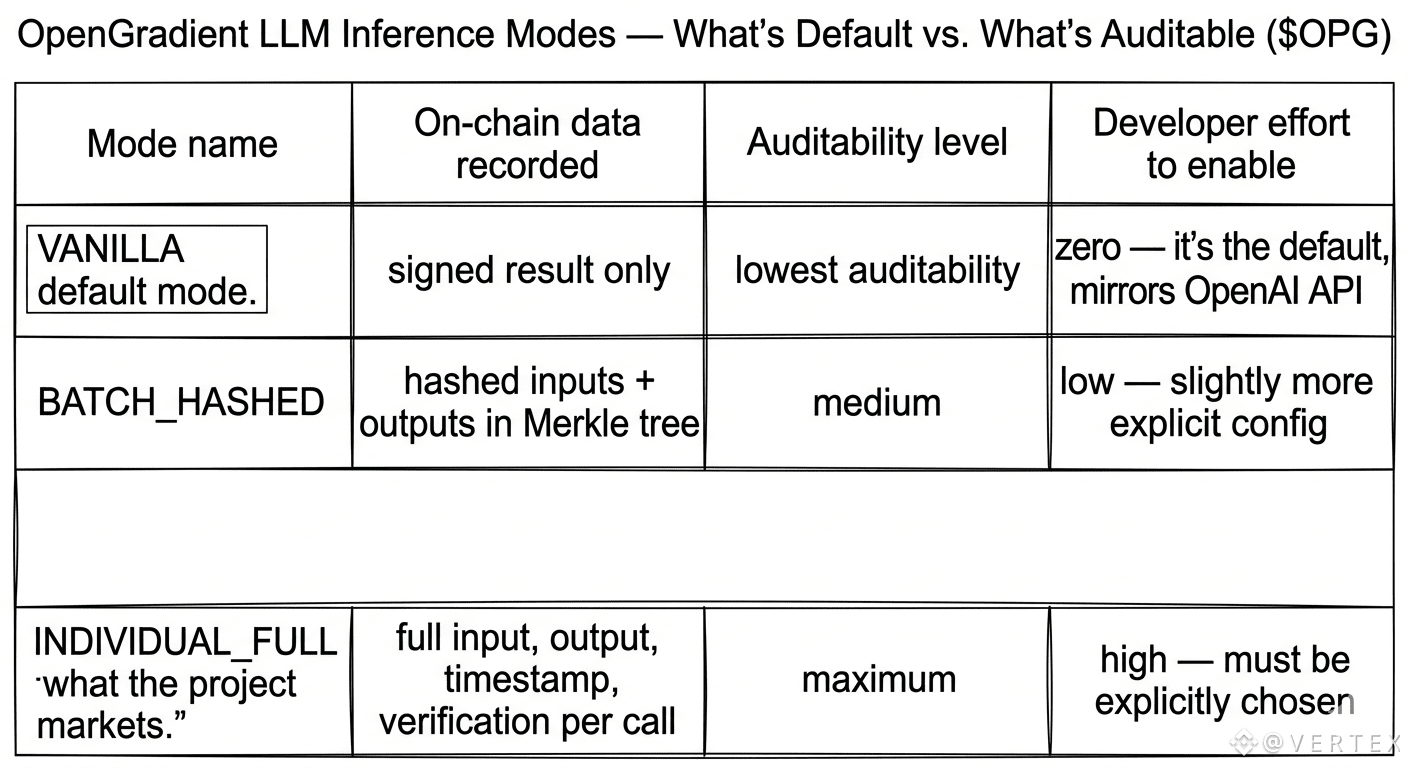
@OpenGradient $OPG #OPG đặt bản thân quanh khả năng kiểm toán — mọi cuộc gọi AI đều có thể xác minh, đầu vào và đầu ra có thể theo dõi. Nhưng khi bạn mở SDK thực tế và nhìn vào chế độ inference LLM mặc định, nó chỉ là VANILLA. Không có TEE. Không có zkML. Chỉ là một thực thi tiêu chuẩn với kết quả đã ký. Đó là chế độ mà hầu hết các nhà phát triển chọn đầu tiên, vì nó gần như phản ánh chính xác API của OpenAI và có ít chi phí nhất.
Khoan đã — vậy chế độ mặc định là con đường ít có khả năng kiểm toán nhất. BATCH_HASHED tổng hợp vào một cây Merkle và rẻ hơn. INDIVIDUAL_FULL thực sự ghi lại đầu vào, đầu ra, thời gian, và xác minh trên chuỗi cho mỗi cuộc gọi, nhưng đó là tùy chọn, không phải mặc định. Bạn phải chọn một cách có ý thức thứ mà dự án tiếp thị như giá trị cốt lõi của nó. Xung quanh việc niêm yết Upbit vào ngày 15 tháng 6, khối lượng OPG đã tăng vọt lên $357.69M — tăng 606% trong 24 giờ — trong khi token mở ở mức $0.3064 và giảm xuống $0.1815 trước khi hồi phục. Tất cả những điều ồn ào đó ở phía sàn giao dịch. Không có gì trong số đó chạm vào chế độ inference mà các nhà phát triển thực sự chọn ở cấp độ giao thức.
Tôi đã dành nhiều thời gian hơn dự kiến chỉ để đọc qua ba chế độ thanh toán đó. Cứ suy nghĩ về việc ai thực sự chọn INDIVIDUAL_FULL. Có lẽ chỉ là một phần nhỏ — các mô hình rủi ro DeFi, các tác nhân có rủi ro cao. Tất cả những người còn lại đều chọn chế độ mặc định.
Vậy OpenGradient có thể làm cho AI có khả năng kiểm toán hơn không? Có, thật sự, nếu các nhà phát triển chọn lựa. Nhưng câu hỏi là liệu có khả năng kiểm toán theo mặc định có bao giờ trở thành tiêu chuẩn, hay liệu nó sẽ vẫn là một tùy chọn mà hầu hết mọi người lặng lẽ bỏ qua.
@OpenGradient $OPG #OPG đặt bản thân quanh khả năng kiểm toán — mọi cuộc gọi AI đều có thể xác minh, đầu vào và đầu ra có thể theo dõi. Nhưng khi bạn mở SDK thực tế và nhìn vào chế độ inference LLM mặc định, nó chỉ là VANILLA. Không có TEE. Không có zkML. Chỉ là một thực thi tiêu chuẩn với kết quả đã ký. Đó là chế độ mà hầu hết các nhà phát triển chọn đầu tiên, vì nó gần như phản ánh chính xác API của OpenAI và có ít chi phí nhất.
Khoan đã — vậy chế độ mặc định là con đường ít có khả năng kiểm toán nhất. BATCH_HASHED tổng hợp vào một cây Merkle và rẻ hơn. INDIVIDUAL_FULL thực sự ghi lại đầu vào, đầu ra, thời gian, và xác minh trên chuỗi cho mỗi cuộc gọi, nhưng đó là tùy chọn, không phải mặc định. Bạn phải chọn một cách có ý thức thứ mà dự án tiếp thị như giá trị cốt lõi của nó. Xung quanh việc niêm yết Upbit vào ngày 15 tháng 6, khối lượng OPG đã tăng vọt lên $357.69M — tăng 606% trong 24 giờ — trong khi token mở ở mức $0.3064 và giảm xuống $0.1815 trước khi hồi phục. Tất cả những điều ồn ào đó ở phía sàn giao dịch. Không có gì trong số đó chạm vào chế độ inference mà các nhà phát triển thực sự chọn ở cấp độ giao thức.
Tôi đã dành nhiều thời gian hơn dự kiến chỉ để đọc qua ba chế độ thanh toán đó. Cứ suy nghĩ về việc ai thực sự chọn INDIVIDUAL_FULL. Có lẽ chỉ là một phần nhỏ — các mô hình rủi ro DeFi, các tác nhân có rủi ro cao. Tất cả những người còn lại đều chọn chế độ mặc định.
Vậy OpenGradient có thể làm cho AI có khả năng kiểm toán hơn không? Có, thật sự, nếu các nhà phát triển chọn lựa. Nhưng câu hỏi là liệu có khả năng kiểm toán theo mặc định có bao giờ trở thành tiêu chuẩn, hay liệu nó sẽ vẫn là một tùy chọn mà hầu hết mọi người lặng lẽ bỏ qua.