

Vài năm trước, tôi giả định rằng nguồn tài nguyên quan trọng nhất trong AI là sức mạnh tính toán.
Ai có sức mạnh xử lý nhiều nhất sẽ chiến thắng. Giả định đó lúc đó có vẻ hiển nhiên. Gần đây, tôi lại thấy mình chú ý đến một thứ kém thú vị hơn nhiều. Không phải trí tuệ. Cũng không phải độ chính xác.
Hoặc cụ thể hơn, điều gì xảy ra khi bộ nhớ máy móc bắt đầu hoạt động khác với bộ nhớ của con người.
Con người quên mọi thứ suốt. Chúng ta quên các cuộc trò chuyện, chi tiết, tên gọi, sai sót. Đôi khi quên là điều tốt. Toàn bộ hệ thống pháp lý được xây dựng xung quanh việc giới hạn thời gian nhất định thông tin nào đó theo sát người ta. Nhưng khi một nền kinh tế quên những thông tin quan trọng, hậu quả có thể bất ngờ trở nên đắt đỏ.
Sự khác biệt đó cứ khiến tôi băn khoăn khi nhìn vào hạ tầng AI.
Phần lớn mọi người vẫn nói về AI như thể vấn đề cốt lõi là tạo ra câu trả lời tốt hơn. Thế nhưng càng quan sát doanh nghiệp thử nghiệm với AI, tôi càng không tin rằng các câu trả lời tốt hơn thực sự là nút thắt chính. Trong nhiều trường hợp, vấn đề xuất hiện sau khi câu trả lời đã được tạo ra.
Thông tin đó đến từ đâu?
Ai là người đóng góp?
Ai có thể xác minh được không?
Và có lẽ quan trọng nhất là: nếu sáu tháng sau có chuyện gì đó đi sai, liệu có ai đó có thể lần ra được những gì đã xảy ra không?
Những câu hỏi đó nghe có vẻ nhàm chán cho tới khi tiền bạc bắt đầu liên quan.
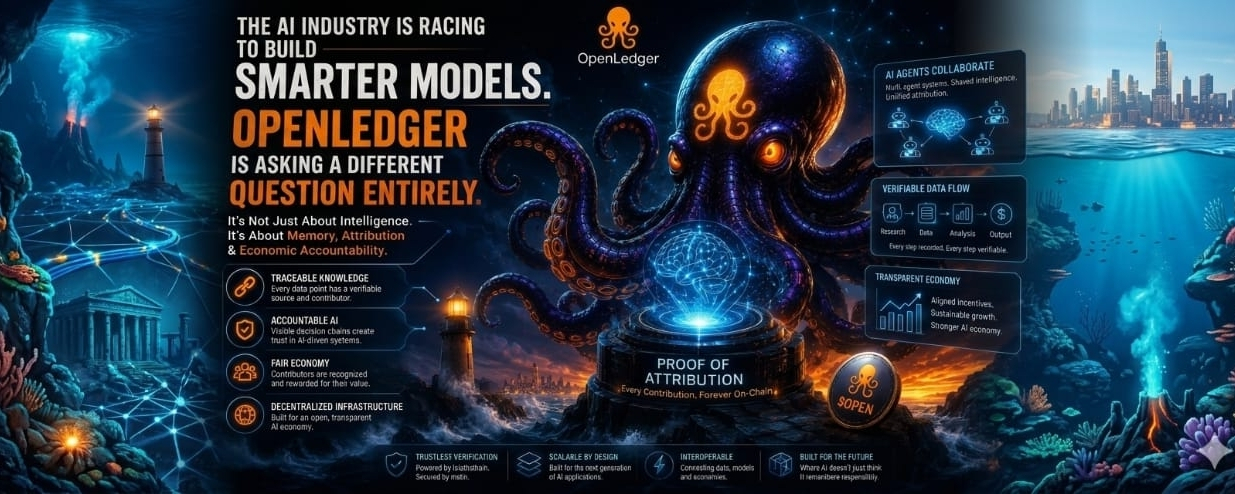
Rất nhiều dự án AI đang cạnh tranh trong cuộc đua trí tuệ. Mô hình nhanh hơn. Lập luận tốt hơn. Huấn luyện hiệu quả hơn. @Openledger >seems to be looking somewhere else. gần như nằm ngay bên dưới chính bản thân AI.
Cách tôi nhìn thì dự án đang đặt một câu hỏi kỳ lạ: nếu nguồn lực khan hiếm không phải là “trí tuệ”, mà là “tri thức có thể truy vết” thì sao?
Ban đầu, tôi nghĩ điều đó giống như một hoạt động xây dựng thương hiệu quanh quyền sở hữu dữ liệu. Tôi càng suy nghĩ thêm, càng thấy lời giải thích đó không làm mình thấy thoải mái.
Bởi vì một khi các hệ thống AI bắt đầu tương tác với nhau, chuỗi tri thức sẽ trở nên lộn xộn rất nhanh. Hãy tưởng tượng mười hệ thống AI cùng đóng góp để tạo ra một đầu ra: một hệ thống cung cấp nghiên cứu, hệ thống khác cung cấp dữ liệu thị trường, một hệ thống khác đóng góp các bản ghi lịch sử. Những hệ thống khác thêm phân tích, cơ chế lọc, hoặc xếp hạng. Cuối cùng một câu trả lời xuất hiện. Ai cũng thấy câu trả lời. Hầu như chẳng ai thấy được “con đường” dẫn tới nó. Con đường ẩn đó có thể cuối cùng lại quan trọng hơn chính đầu ra cuối cùng.
Tôi nhớ đã đọc về việc một tổ chức tài chính thử nghiệm các quy trình có hỗ trợ bởi AI. Điều khiến tôi quan tâm không phải việc mô hình có tạo ra đầu ra hữu ích hay không. Mà là câu chuyện tuân thủ diễn ra sau đó. Tổ chức đó không hỏi liệu AI có thông minh không. Họ hỏi liệu họ có thể giải thích quá trình ra quyết định cho các cơ quan quản lý nếu cần hay không. Nghe có vẻ đây là một nhóm vấn đề hoàn toàn khác.
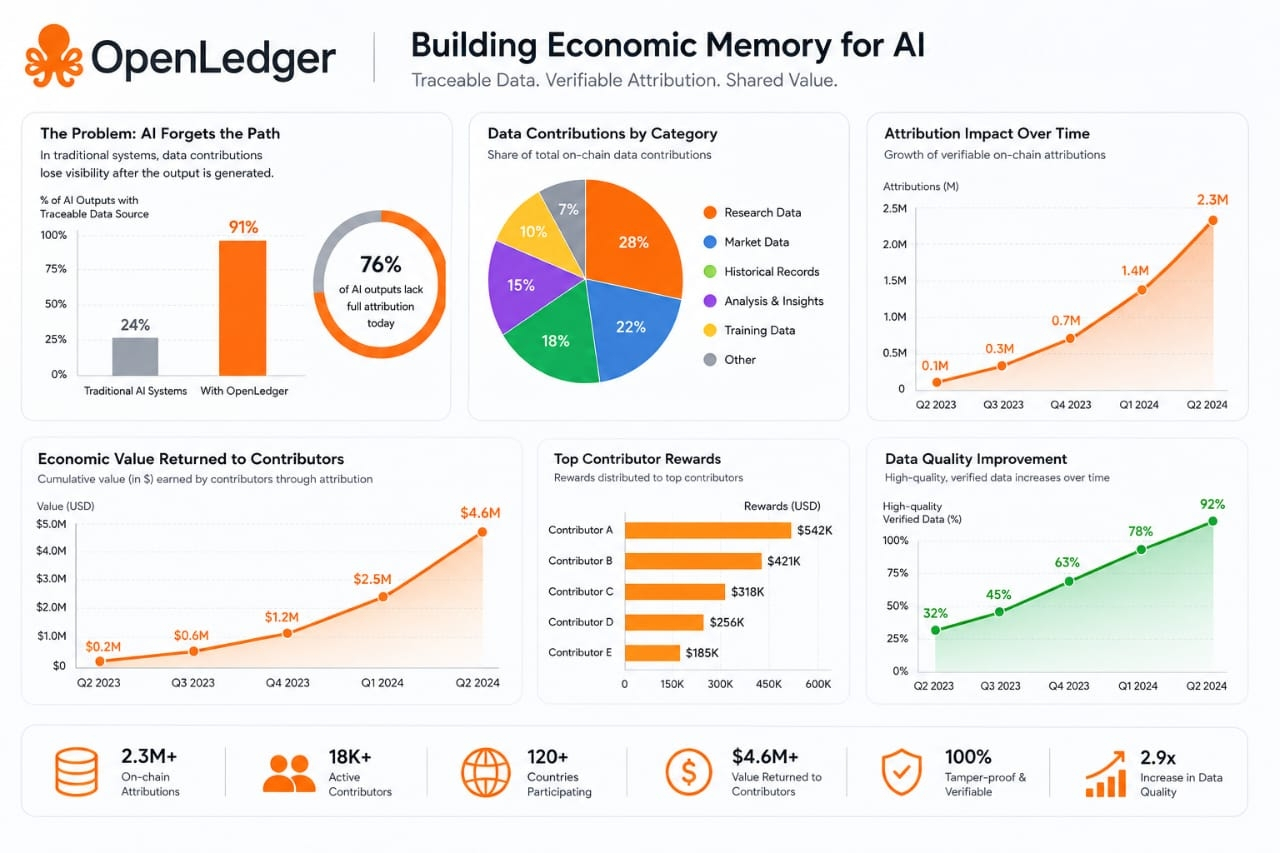
Một nền kinh tế có thể chịu đựng trí tuệ chưa hoàn hảo trong một thời gian đáng ngạc nhiên. Thứ mà nó khó chịu nhất là trách nhiệm giải trình không thể nhìn thấy.
Đó một phần là lý do OpenLedger thu hút sự chú ý của tôi.
Trong chuỗi cung ứng, hồ sơ nguồn gốc (provenance) quan trọng vì doanh nghiệp cần biết sản phẩm xuất phát từ đâu. Trong y tế, tài liệu được tạo ra vì trí nhớ không thể tự tin dựa vào chính nó. Thế nhưng phần lớn AI vẫn hoạt động như thể việc truy vết nguồn gốc là tùy chọn. Điều đó làm tôi thấy lạ. Chúng ta đang xây các hệ thống ngày càng ảnh hưởng đến các quyết định kinh tế, đồng thời lại coi “dòng dõi thông tin” như một hạ tầng thứ yếu. Có lẽ ổn khi AI vẫn là công cụ năng suất. Tôi ít chắc chắn hơn nếu AI trở thành một “người tham gia” trong hoạt động kinh tế.
Qua lăng kính đó, luận điểm của OpenLedger bắt đầu trông thú vị hơn.
Nếu các đóng góp dữ liệu vẫn có thể truy vết, thì tri thức không chỉ đơn giản “đi vào” một mô hình rồi biến mất. Các nhà đóng góp có thể vẫn được gắn kết với việc tạo ra giá trị ở phía sau. Quan trọng hơn nữa, các chuỗi ra quyết định trở nên có thể quan sát được. “Bằng chứng truy xuất nguồn gốc” là cơ chế cốt lõi: ghi lại mọi đóng góp dữ liệu dưới dạng một trạng thái thay đổi vĩnh viễn, có thể kiểm chứng, trên chuỗi khối (on-chain). Không phải trong cơ sở dữ liệu riêng tư của một công ty. Không phải trong một nhật ký có thể được sửa lại một cách lặng lẽ. Trên một sổ cái mà bản ghi phụ thuộc vào toán học, không phụ thuộc vào thiện chí của các tổ chức.
Vấn đề lớn hơn có thể là “trí nhớ kinh tế”.
Khi một hệ thống mất dần dấu vết về nguồn gốc của tri thức, nó sẽ dần mất khả năng phân biệt tín hiệu với nhiễu. Những người đóng góp chất lượng cao trở nên khó xác định hơn. Thông tin xấu và thông tin tốt bắt đầu cạnh tranh trên cùng một “mặt bằng”. Cuối cùng, động lực bắt đầu lệch hướng. Quá trình đó diễn ra chậm. Gần như vô hình. Rồi đột nhiên ai cũng nhận ra chất lượng đang đi xuống.
Tôi đã thấy các mẫu tương tự ngoài lĩnh vực AI. Thị trường tài chính thường mất nhiều năm tối ưu hiệu quả trước khi nhận ra rằng họ vô tình đã loại bỏ tính minh bạch. Các nền tảng xã hội tối ưu mức độ tương tác trước khi nhận ra họ đã làm suy yếu độ tin cậy. Hệ thống hiếm khi “vỡ” hoàn toàn cùng một lúc. Chúng trôi đi. Hạ tầng AI có thể cũng phải đối mặt với điều gì đó tương tự.
Dù vậy, tôi không nghĩ “đường đi” của OpenLedger là điều gì đó đơn giản. Có một sự đánh đổi ở đây mà chẳng ai thực sự nói tới. Ai cũng ủng hộ trách nhiệm giải trình về mặt lý thuyết. Nhưng trách nhiệm giải trình trở nên “mỏng đi” rất nhiều khi nó tạo thêm gánh nặng vận hành. Vì vậy tôi không xem OpenLedger như một lựa chọn chắc chắn sẽ thắng. Điều tôi thấy thú vị là chính hướng đi của canh bạc đó.
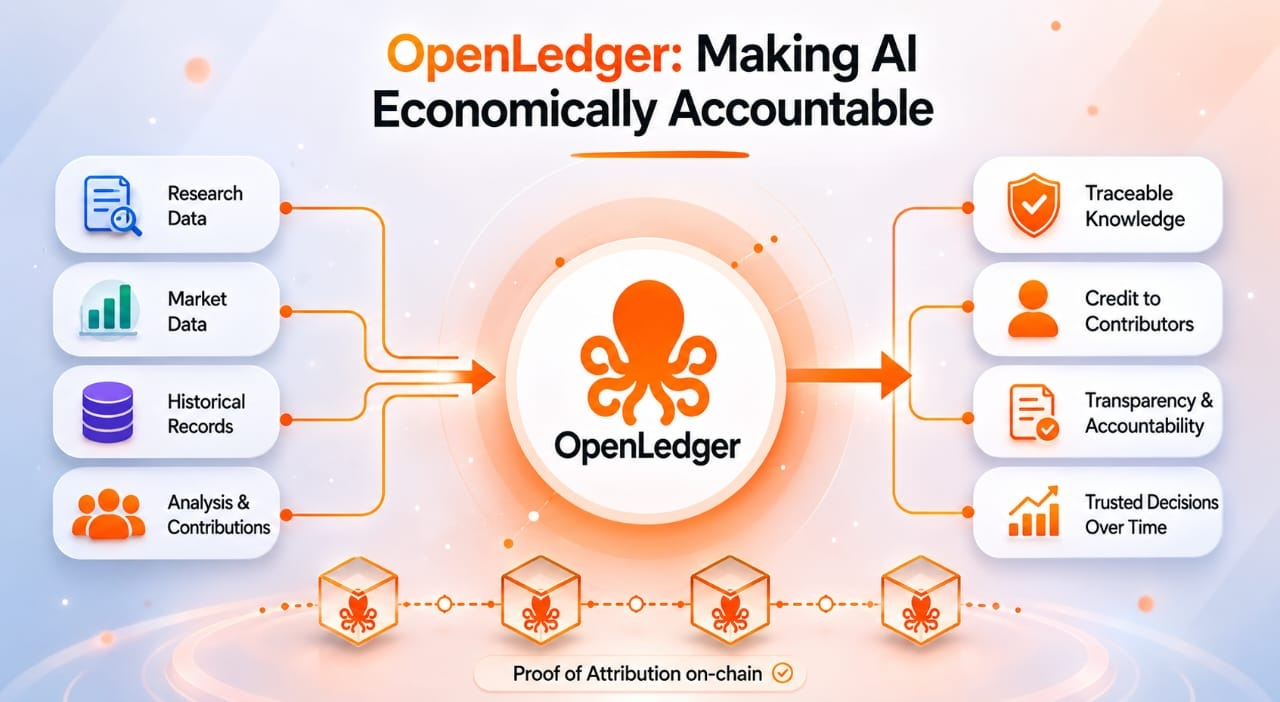
Ngành công nghiệp ám ảnh với việc làm AI thông minh hơn. OpenLedger có vẻ quan tâm nhiều hơn đến việc khiến AI phải chịu trách nhiệm về mặt kinh tế. Đó không phải là cùng một mục tiêu. Và tôi cứ tự hỏi liệu thị trường có đang tập trung vào “sự khan hiếm” sai hay không.
Chi phí tính toán ngày càng rẻ đi. Mô hình được cải thiện. Chi phí suy luận giảm. Nhưng những bản ghi được “tin cậy” lại có xu hướng kỳ lạ là ngày càng trở nên có giá trị hơn khi các hệ thống trở nên phức tạp hơn.
Có lẽ sự “quên” của AI nghe giống một bất tiện kỹ thuật ngày nay. Một lỗi sản phẩm. Thứ mà các kỹ sư rồi sẽ tìm cách giải quyết. Hoặc có thể sự quên trở thành nguồn rủi ro ẩn mà không ai nhận ra cho đến khi cả các thị trường do AI vận hành đều phụ thuộc vào việc nhớ chính xác ai đã đóng góp gì, vào lúc nào, và vì sao.
Đó là canh bạc mà OpenLedger đang thực hiện.
Tôi thấy điều đó thú vị hơn hầu hết những canh bạc đang được đưa ra
@Openledger >#OpenLedger >$OPEN
