

Càng quan sát các dự án dữ liệu phi tập trung, tôi càng cảm thấy rằng hầu hết các cuộc thảo luận đang tập trung vào cuộc cạnh tranh sai.
Mọi người thường xem đó như một cuộc đua để cung cấp dữ liệu.
Ai có thể thu thập nhiều dữ liệu nhất. Ai có thể thu hút số lượng người đóng góp lớn nhất. Ai có thể xây dựng thị trường lớn nhất.
Nhưng đó có thể chỉ là lớp bề mặt.
Dữ liệu tự thân chưa bao giờ là tài nguyên thực sự khan hiếm.
Điều khó tìm hơn là một hệ thống có khả năng biến đổi dữ liệu thô thành trí tuệ có thể xác minh, liên tục cải tiến và liên tục tạo ra giá trị.
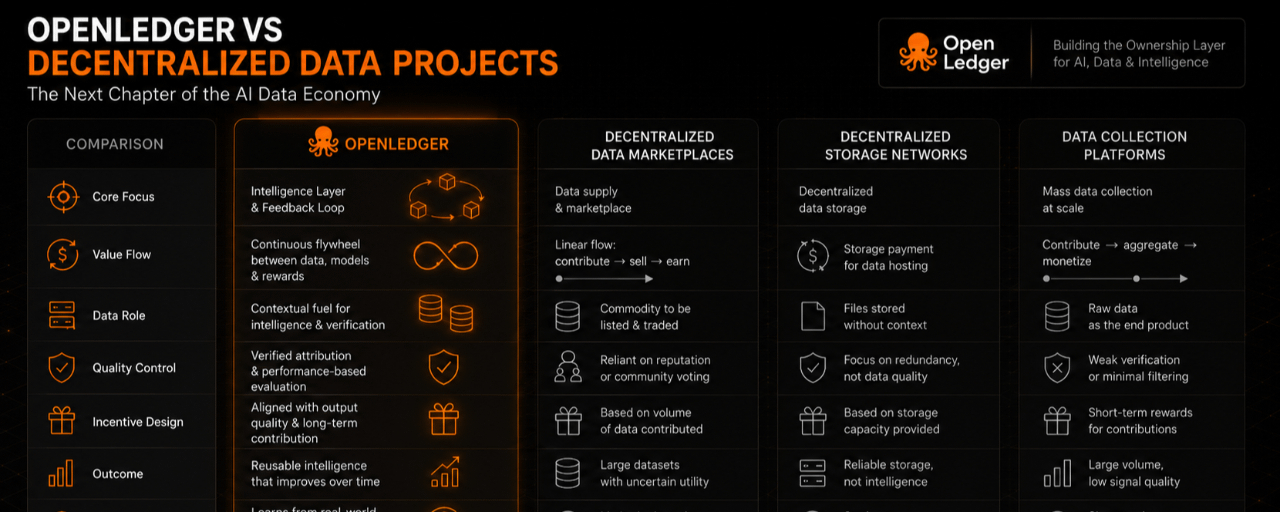
Đó là lý do tại sao tôi thấy OpenLedger đặc biệt thú vị khi so sánh với nhiều sáng kiến dữ liệu phi tập trung đã xuất hiện trong vài năm qua.
Hầu hết các dự án hoạt động dựa trên giả định rằng nếu đủ dữ liệu có thể được thu thập, phần còn lại của hệ sinh thái sẽ tự nhiên phát triển xung quanh nó.
Về lý thuyết, điều đó có lý.
Trong thực tế, tuy nhiên, dữ liệu hiếm khi là thành phần bị thiếu.
Những thách thức thực sự là ngữ cảnh, đánh giá chất lượng và hiểu biết về những tập dữ liệu nào thực sự tạo ra kết quả tốt hơn những tập dữ liệu khác.
Quan trọng hơn, nhiều hệ thống vẫn gặp khó khăn trong việc kết nối những người đóng góp với giá trị mà dữ liệu của họ giúp tạo ra.
Từ quan điểm của tôi, OpenLedger dường như tiếp cận thách thức này theo cách khác.
Thay vì chỉ tập trung vào việc xây dựng một kho thông tin khổng lồ, mục tiêu dường như là tạo ra một vòng phản hồi nơi dữ liệu, các mô hình AI và các động lực kinh tế liên tục củng cố lẫn nhau.
Nhìn thoáng qua, có thể nghe như một sự khác biệt thiết kế nhỏ.
Trên thực tế, nó tạo ra những động lực hành vi hoàn toàn khác biệt.
Bởi vì mọi người không chỉ phản ứng với công nghệ.
Họ phản ứng với các động lực.
Nhiều dự án dữ liệu phi tập trung khuyến khích người dùng đóng góp dữ liệu trước và sau đó cố gắng khám phá cách để khai thác giá trị từ nó.
Một số cách tiếp cận mới hơn, bao gồm OpenLedger, dường như đảo ngược quá trình đó.
Giá trị được tạo ra từ các đầu ra trở thành điểm khởi đầu, trong khi dữ liệu đóng vai trò là một thành phần trong chu trình tạo ra giá trị lớn hơn.
Những gì trông giống như một quyết định sản phẩm có thể thực sự phản ánh một sự chuyển dịch rộng hơn trong cách thị trường nghĩ về AI.
Làn sóng đầu tiên đã ám ảnh với các mô hình.
Làn sóng tiếp theo trở nên ám ảnh với dữ liệu.
Giờ đây, sự chú ý dường như đang chuyển sang một câu hỏi khác:
Làm thế nào để chúng ta xây dựng hệ thống liên tục học hỏi từ các tương tác trong thế giới thực thay vì chỉ đơn thuần tích lũy các tập dữ liệu lớn hơn?
Bởi vì dữ liệu không phải là tĩnh.
Nó phản ánh hành vi của con người.
Và hành vi của con người thay đổi liên tục.
Những gì rất phù hợp hôm nay có thể trở nên lỗi thời trong vài tháng khi mọi người thay đổi cách họ tìm kiếm, giao tiếp và đưa ra quyết định.
Một mô hình được đào tạo trên thực tế của ngày hôm qua có thể không được tối ưu hóa cho ngày mai.
Có lẽ đó là lý do tại sao tôi vẫn chú ý đến các dự án như OpenLedger.
Không phải vì họ đã hoàn toàn giải quyết thách thức dữ liệu phi tập trung.
Mà vì họ đang khám phá một câu hỏi nền tảng hơn.
Nếu một nền kinh tế điều khiển bởi AI cuối cùng xuất hiện, thì giá trị thực sự sẽ nằm ở đâu?
Trong việc sở hữu dữ liệu?
Trong việc sở hữu các mô hình?
Hoặc trong việc sở hữu vòng phản hồi liên tục kết nối cả hai?
Tôi không nghĩ thị trường đã đạt được câu trả lời rõ ràng nào.
Nhưng ngày càng có cảm giác rằng cuộc cạnh tranh lớn tiếp theo sẽ không phải là về ai sở hữu nhiều dữ liệu nhất.
Điều này sẽ phụ thuộc vào ai có thể xây dựng hệ thống giữ cho dữ liệu có giá trị khi thế giới - và hành vi con người - tiếp tục phát triển.