

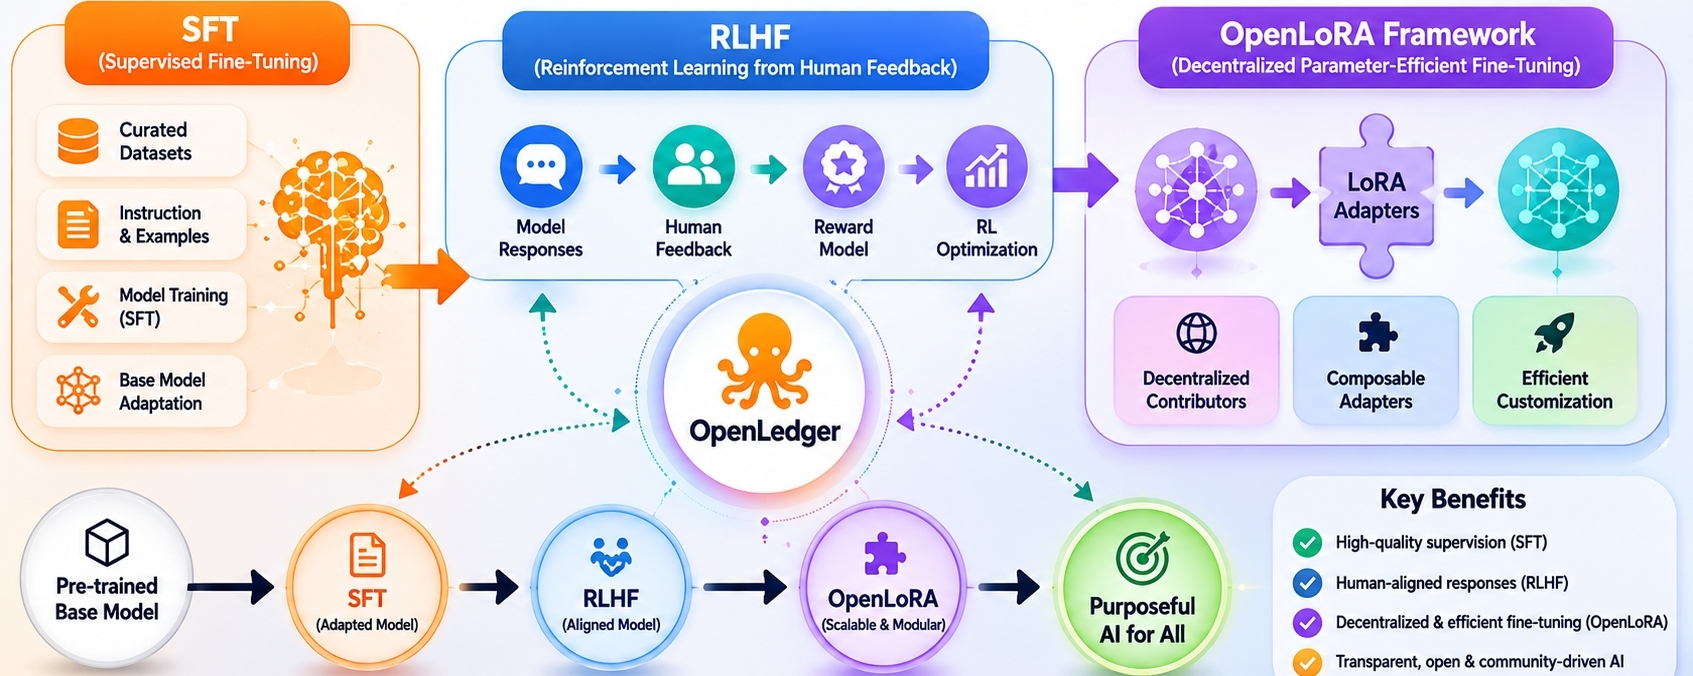
Điều đã giữ cho tôi quay lại với OpenLedger không phải là chất lượng mô hình. Đó là câu hỏi về nơi ma sát định hướng thực sự tồn tại một khi một hệ thống vượt ra ngoài việc đào tạo một mô hình đơn lẻ và bắt đầu phối hợp giữa các người đóng góp, xác thực, bộ dữ liệu và vòng phản hồi ở quy mô lớn.
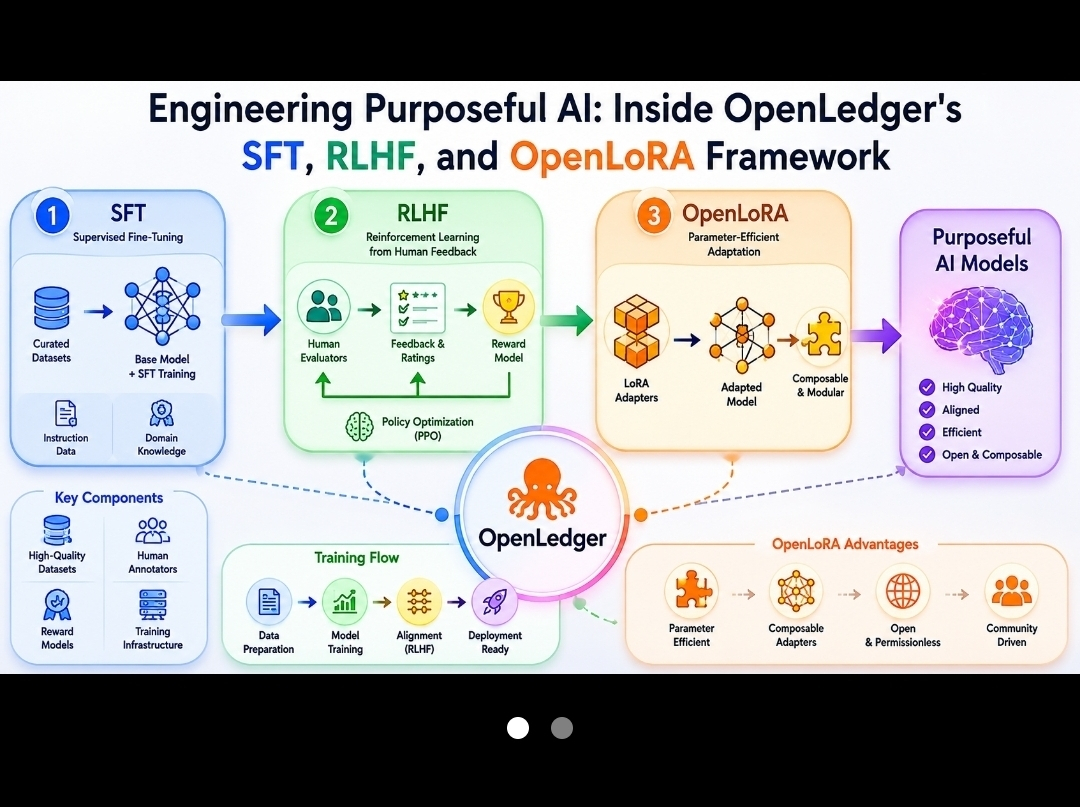
Bên trong OpenLedger, vấn đề thú vị không phải là liệu SFT, RLHF, hay OpenLoRA hoạt động độc lập. Hầu hết mọi người đã chấp nhận rằng chúng làm. Câu hỏi khó hơn là điều gì xảy ra khi những cơ chế này trở thành một phần của môi trường sản xuất chung nơi nhiều tác nhân liên tục định hình hành vi của mô hình.
Đó là nơi căng thẳng vận hành bắt đầu.
Một mô hình có thể trông đáng tin cậy trong quá trình đánh giá nhưng vẫn trở nên bất ổn một cách đáng ngạc nhiên khi các con đường tinh chỉnh tăng lên. Mỗi bộ dữ liệu mới đều mang theo những sở thích. Mỗi người đóng góp đều đưa ra những giả định. Mỗi tối ưu hóa đều âm thầm đẩy mô hình về một phiên bản khác của tính hữu dụng.
Thách thức không phải là tạo ra trí tuệ.
Thách thức là bảo tồn ý định trong khi trí tuệ đang được điều chỉnh.
Tôi cứ nhận thấy điều này khi xem xét cách OpenLedger kết hợp tinh chỉnh có giám sát, học tăng cường từ phản hồi của con người, và thích ứng mô-đun thông qua OpenLoRA. Trên giấy tờ, những thành phần này có vẻ bổ sung cho nhau. Trong thực tế, chúng tạo ra những áp lực cạnh tranh mà phải được quản lý ở đâu đó.
Lấy SFT trước.
Hầu hết mọi người nghĩ rằng tinh chỉnh có giám sát là giai đoạn đơn giản. Các ví dụ được chọn vào. Hành vi tốt hơn xuất hiện. Thực tế thì phức tạp hơn. Khi nhiều người đóng góp bắt đầu cung cấp dữ liệu đào tạo, vấn đề chuyển từ chất lượng sang tính nhất quán.
Hãy tưởng tượng hai người đóng góp giải quyết cùng một nhiệm vụ hỗ trợ khách hàng. Một người thưởng cho sự ngắn gọn. Một người khác thưởng cho các giải thích chi tiết.
Không bộ dữ liệu nào là sai.
Nhưng khi cả hai vào quy trình đào tạo, mô hình bắt đầu học các định nghĩa mâu thuẫn về thành công.
Chế độ thất bại là tinh vi. Các đầu ra vẫn giữ đúng kỹ thuật trong khi trở nên không thể đoán trước về mặt vận hành.
Một người dùng hỏi cùng một câu hỏi hai lần và nhận được các phong cách phản hồi khác nhau một cách rõ rệt.
Không có gì xuất hiện bị hỏng.
Tuy nhiên, niềm tin bắt đầu suy giảm.
Đây là nơi mà sự nhấn mạnh của OpenLedger vào việc quy trách nhiệm trở nên thú vị hơn việc đào tạo bản thân. Nếu một sự chuyển dịch hành vi cụ thể xuất hiện sau khi các bộ dữ liệu nhất định được giới thiệu, việc truy nguyên ảnh hưởng trở nên khả thi hơn là suy đoán.
Rủi ro đang được giảm là không phải ảo tưởng.
Đó là sự mơ hồ về nơi mà sự trôi dạt hành vi xuất phát.
Nghe có vẻ nhỏ cho đến khi việc gỡ lỗi bắt đầu.
Nếu không có việc quy trách nhiệm, mỗi phản hồi mô hình không mong đợi đều trở thành một câu chuyện điều tra.
Với việc quy trách nhiệm, việc điều tra trở nên hẹp hơn và rẻ hơn.
Tuy nhiên, việc quy trách nhiệm tự nó tạo ra chi phí riêng. Những người đóng góp trở thành người tham gia có thể thấy được trong hành vi của mô hình. Tính minh bạch tạo ra trách nhiệm, nhưng nó cũng tạo ra sự do dự. Một số người đóng góp trở nên bảo thủ hơn vì ảnh hưởng của họ có thể được đo lường.
Sự đánh đổi đó cảm thấy thật.
Tính khả thi tốt hơn thường có nghĩa là thử nghiệm chậm hơn.
Sau đó RLHF xuất hiện và mọi thứ trở nên kém sạch sẽ hơn.
Phản hồi của con người thường được trình bày như là lớp định hướng. Giai đoạn mà các mô hình học những gì mọi người thực sự ưa thích.
Tôi không hoàn toàn bị thuyết phục rằng nó đơn giản như vậy.
Phản hồi của con người thường nắm bắt sự hài lòng ngay lập tức một cách hiệu quả hơn so với tính hữu dụng lâu dài.
Sự phân biệt đó có ý nghĩa.
Hãy xem xét một kịch bản nơi hai phản hồi trả lời cùng một câu hỏi.
Sự tự tin trở thành một lối tắt.
Theo thời gian, áp lực tối ưu hóa có thể đẩy các mô hình về những phản hồi cảm thấy tốt hơn trước khi chúng trở nên chân thực hơn.
OpenLedger không thể hoàn toàn loại bỏ căng thẳng đó vì không có khung nào có thể. Những gì nó có thể làm là phơi bày nhiều hơn về quy trình định hướng thay vì che giấu nó sau một quy trình tập trung.
Điều đó tạo ra một bài kiểm tra thú vị.
Nếu hai nhóm phản hồi không ngừng bất đồng về đầu ra ưa thích, sở thích của ai nên chiếm ưu thế?
Không có câu trả lời rõ ràng.
Tôi nghi ngờ nhiều người cho rằng phân quyền tự động giải quyết vấn đề này.
Tôi không chắc nó có.
Nó đơn giản chỉ làm cho sự bất đồng trở nên rõ ràng.
Và tính minh bạch khác với việc giải quyết.
Một ví dụ cơ học minh họa điều này rõ ràng.
Giả sử một mô hình nhận được 1.000 sự kiện phản hồi về các tác vụ lý luận tài chính.
Bảy trăm thưởng cho các phản hồi ngắn gọn.
Ba trăm thưởng cho phân tích rủi ro chi tiết.
Con đường tối ưu hóa phụ thuộc hoàn toàn vào cách các tín hiệu đó được trọng số.
Cỗ máy kỹ thuật ít quan trọng hơn so với những giả định về quản trị được nhúng bên trong nó.
Cuối cùng ai đó quyết định "tốt hơn" có nghĩa là gì.
Ngay cả khi quyết định đó xuất hiện tập thể.
Phần mà tôi quan tâm nhất là OpenLoRA vì đây là nơi ma sát định hướng trở nên hữu hình.
Tinh chỉnh truyền thống thường hành xử như việc thay thế các bộ phận của một động cơ trong khi nó đang chạy. Mỗi sửa đổi đều mang theo khả năng xảy ra hậu quả không mong muốn ở nơi khác.
OpenLoRA thay đổi đơn vị thích ứng.
Thay vì liên tục điều chỉnh các mô hình nền lớn, những người đóng góp có thể xây dựng các thích ứng chuyên biệt vẫn giữ được tính mô-đun hơn.
Nghe có vẻ như một sự cải thiện thuần túy cho đến khi thực tế vận hành xuất hiện.
Một hệ thống mô-đun giảm một loại thất bại trong khi tạo ra một loại khác.
Bây giờ thách thức trở thành việc lựa chọn.
Thích ứng nào nên được sử dụng?
Phiên bản nào nên được ưu tiên?
Sự ma sát không biến mất.
Nó di chuyển.
Tôi nghĩ rằng động lực đó là một trong những động lực ít được đánh giá cao nhất trong cơ sở hạ tầng AI.
Các hệ thống hiếm khi loại bỏ được sự phức tạp.
Họ chuyển nó.
OpenLoRA có vẻ như chuyển độ phức tạp ra khỏi việc đào tạo lại mô hình và hướng tới phối hợp mô hình.
Điều đó thường là một giao dịch tốt.
Nhưng nó vẫn là một giao dịch.
Hãy tưởng tượng hai LoRAs đặc thù theo miền.
Một cái chuyên về lý luận pháp lý.
Một cái khác chuyên về hỗ trợ khách hàng.
Cả hai cùng hoạt động tốt.
Một quy trình làm việc hỗn hợp đột nhiên yêu cầu quyết định về định tuyến, ưu tiên, tương thích và đánh giá.
Lớp mô hình trở nên dễ cập nhật hơn.
Lớp phối hợp trở nên khó quản lý hơn.
Bạn muốn gánh vác gánh nặng nào?
Tôi thực sự nghĩ rằng những người hợp lý có thể có câu trả lời khác nhau.
Điều này cũng giải thích tại sao lớp kinh tế của OpenLedger cuối cùng trở nên có liên quan.
Không ngay lập tức.
Không phải như một sự suy đoán.
Như một cơ sở hạ tầng.
Khi việc quy trách nhiệm, phản hồi, và thích ứng trở thành các hoạt động có thể đo lường, động lực không thể tránh khỏi xuất hiện trong cuộc trò chuyện. Những người đóng góp cần lý do để duy trì các bộ dữ liệu. Những người xác thực cần lý do để đánh giá chất lượng. Những người cung cấp phản hồi cần lý do để tham gia một cách trung thực.
Cuối cùng vai trò của token OPEN xuất hiện gần như là điều cần thiết vì sự phối hợp mà không có động lực có xu hướng suy giảm dưới quy mô.
Câu hỏi thú vị không phải là liệu có tồn tại các động lực hay không.
Câu hỏi thú vị là liệu các động lực có tiếp tục thưởng cho tính hữu dụng sau khi sự phát triển xuất hiện.
Lịch sử cho thấy đây là nơi mà nhiều hệ thống gặp khó khăn.
Điều giữ cho tôi quay lại với OpenLedger không phải là lời hứa về phát triển AI mở. Rất nhiều dự án hứa hẹn sự cởi mở.
Đó là sự sẵn lòng phơi bày nơi mà chi phí định hướng thực sự tích lũy.
Không phải trong kiến trúc mô hình.
Không trong điểm số chuẩn.
Trong không gian hỗn độn giữa các người đóng góp cố gắng định hình cùng một trí tuệ theo những mục tiêu hơi khác nhau.
Có thể thử thách thực sự lại đơn giản một cách bất ngờ.
Nếu hai người đóng góp có kỹ năng tương đương đào tạo hệ thống theo các định nghĩa chất lượng khác nhau, khung có thể tiết lộ rằng mâu thuẫn trước khi người dùng trải nghiệm hậu quả không?
Và nếu nó có thể, liệu sự minh bạch đó có cải thiện kết quả hay chỉ đơn giản là làm cho sự bất đồng dễ thấy hơn?
Tôi không nghĩ rằng câu trả lời đã được giải quyết.
Càng nhìn vào SFT, RLHF, và OpenLoRA cùng nhau, chúng càng ít cảm thấy giống như các kỹ thuật tối ưu hóa và càng nhiều cảm thấy giống như các cơ chế thương lượng.
Một cuộc thương lượng giữa các bộ dữ liệu.
Một cuộc thương lượng giữa các sở thích.
Một cuộc thương lượng giữa sự cởi mở và tính nhất quán.
Hầu hết các hệ thống AI ẩn những cuộc đàm phán đó sau giao diện.
OpenLedger dường như quyết tâm đưa chúng ra ánh sáng.
Cho dù điều đó cuối cùng có tạo ra trí tuệ tốt hơn hay chỉ đơn giản là nhiều ma sát hơn có thể thấy vẫn là điều tôi thấy mình đang thử nghiệm.
