Gần đây tôi đã xem qua kiến trúc của openledger, chủ yếu là hệ thống phân bổ và các khuyến khích cho người đóng góp.
Hầu hết mọi người nghĩ openledger chỉ là một token AI cộng với crypto khác, nhưng thật sự phần thú vị hơn là nỗ lực xây dựng hạ tầng phối hợp xung quanh dữ liệu AI.
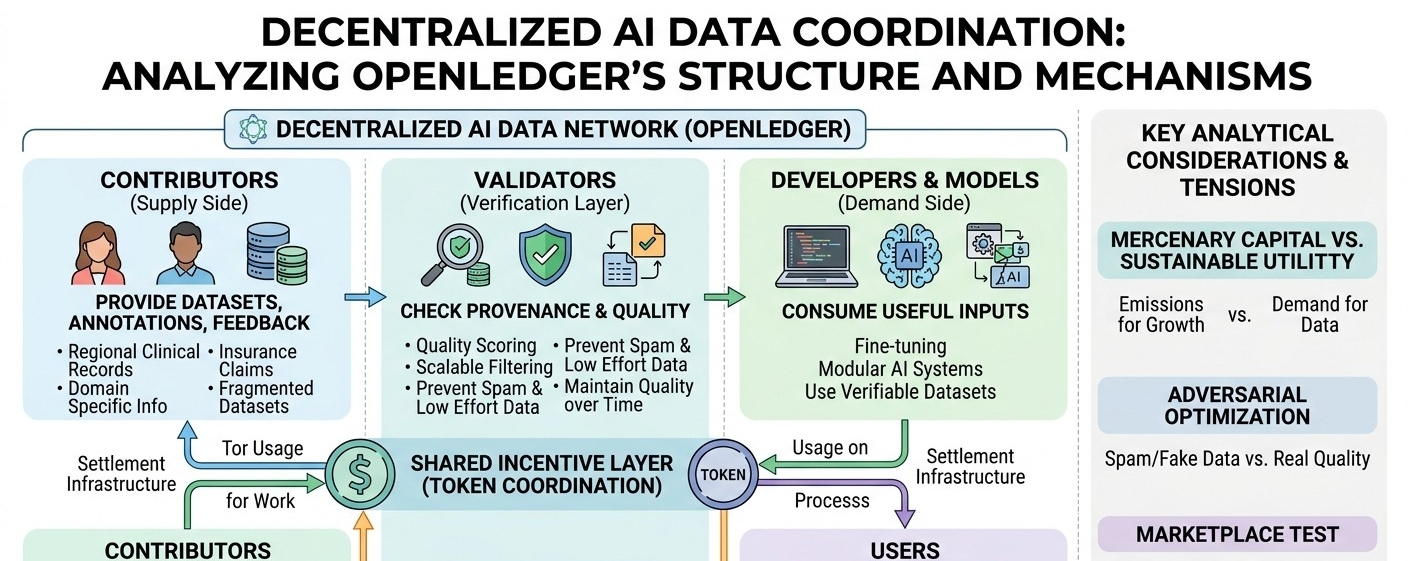
Điều khiến tôi chú ý là cách mà mạng lưới cố gắng kết nối những người đóng góp, validator, nhà phát triển và người dùng thông qua một lớp khuyến khích chung.
Những người đóng góp cung cấp bộ dữ liệu, chú thích, vòng phản hồi hoặc thông tin cụ thể theo miền.
các validator kiểm tra nguồn gốc và chất lượng
các nhà phát triển tiêu thụ đầu vào hữu ích cho các mô hình
người dùng tạo ra nhu cầu thông qua các ứng dụng hoặc suy diễn
về lý thuyết, token phối hợp giá trị trên tất cả chúng
hệ thống đóng góp phi tập trung thực sự có lý trong một số lĩnh vực
một mô hình chăm sóc sức khỏe được huấn luyện trên các hồ sơ lâm sàng vùng hoặc chú thích yêu cầu bảo hiểm có thể cần các tập dữ liệu phân mảnh mà các hệ thống tập trung không luôn ưu tiên thu thập
openledger dường như được thiết kế xoay quanh giả định đó
tương lai của các hệ thống AI trở nên mô-đun hơn và phối hợp bên ngoài thay vì hoàn toàn tích hợp theo chiều dọc
sau đó là lớp gán nhãn mà thật lòng mà nói, cảm thấy như phần khó khăn nhất của toàn bộ kiến trúc
nếu các người đóng góp được thưởng dựa trên sự hữu ích ở hạ nguồn, làm thế nào giao thức biết dữ liệu nào thực sự quan trọng
và đây là phần mà tôi cứ nghĩ mãi
mô hình AI hấp thụ các mẫu từ đầu vào hỗn hợp
một tập dữ liệu nhỏ nhưng chất lượng cao có thể quan trọng hơn hàng triệu ví dụ chung chung
vì vậy, gán nhãn trở nên xác suất rất nhanh chóng
có thể điều đó là chấp nhận được
các người đóng góp có lẽ không cần độ chính xác hoàn hảo
họ chỉ cần một hệ thống mà cảm thấy công bằng đủ và khó bị thao túng
nhưng một khi phần thưởng token trở nên có ý nghĩa, mọi người tối ưu hóa xung quanh bất kỳ chỉ số nào mà giao thức đo lường
đó là nơi mà sự căng thẳng về ưu đãi xuất hiện
nếu khí thải thống trị trước khi nhu cầu thực sự tồn tại, các người đóng góp có thể tải lên các tập dữ liệu trùng lặp, filler tổng hợp, chú thích ít nỗ lực hoặc tương tác spam chỉ vì hệ thống thưởng cho phép điều đó
vì vậy, lớp xác minh quan trọng như chính lớp đóng góp
openledger cần theo dõi nguồn gốc, điểm chất lượng và lọc có khả năng mở rộng mà không trôi dạt vào việc điều chỉnh tập trung
quá ít lọc và mạng trở nên ồn ào
quá nhiều lọc và tiền đề phi tập trung sẽ yếu đi
bên thị trường có lẽ là bài kiểm tra thực sự dài hạn
về lý tưởng, các nhà phát triển trả tiền cho các tập dữ liệu đã được xác minh hoặc quyền truy cập mô hình, người dùng tạo ra nhu cầu suy diễn và các người đóng góp kiếm tiền từ việc sử dụng mạng thực tế thay vì chỉ từ khí thải
trong phiên bản đó, token trở thành hạ tầng thanh toán thay vì chỉ là nhiên liệu ưu đãi
nhưng toàn bộ kiến trúc phụ thuộc vào nhu cầu AI trong tương lai trở nên phân mảnh đủ để cần loại lớp phối hợp này
nếu các nền tảng lớn tiếp tục kiểm soát việc đào tạo, triển khai và phản hồi người dùng nội bộ, các thị trường dữ liệu AI phi tập trung có thể vẫn tương đối hẹp
đang theo dõi
phí sử dụng thực tế so với khí thải
chất lượng của các tập dữ liệu đóng góp theo thời gian
nhu cầu của các nhà phát triển về dữ liệu bên ngoài có thể gán nhãn
cách mà các tranh chấp gán nhãn mở rộng với sự tham gia
chưa có kết luận rõ ràng
openledger có thể đang xây dựng một lớp phối hợp bền vững cho các hệ thống AI phân tán
hoặc có thể đang thử nghiệm xem liệu các ưu đãi token có thể tạo ra một thị trường trước khi phía cầu hoàn toàn tồn tại