

Này, để mình nói cho bạn biết một điều từ đầu - khi bạn nhìn vào những loại hệ thống này, bạn nghĩ ngay "tất cả đều được kiểm soát, quy tắc nghiêm ngặt, hạn chế..." Nhưng nếu bạn nhìn sâu hơn, bạn sẽ hiểu rằng ở đây không phải là hỗn loạn, mà là một nỗ lực tạo ra một cấu trúc có chủ đích - đúng vậy.
Nếu mình nói thật từ đáy lòng.... Cách mà mình đọc @OpenLedger tài liệu, trong một câu - không chỉ là một AI hay một nền tảng dữ liệu, mà là một thí nghiệm về toàn bộ ý tưởng về cách dữ liệu có thể trở thành một "tài sản sinh lời". Bây giờ hãy phân tích điều này vì nếu bạn gộp tất cả lại, nó sẽ không nằm gọn trong đầu bạn - hoàn toàn không thể.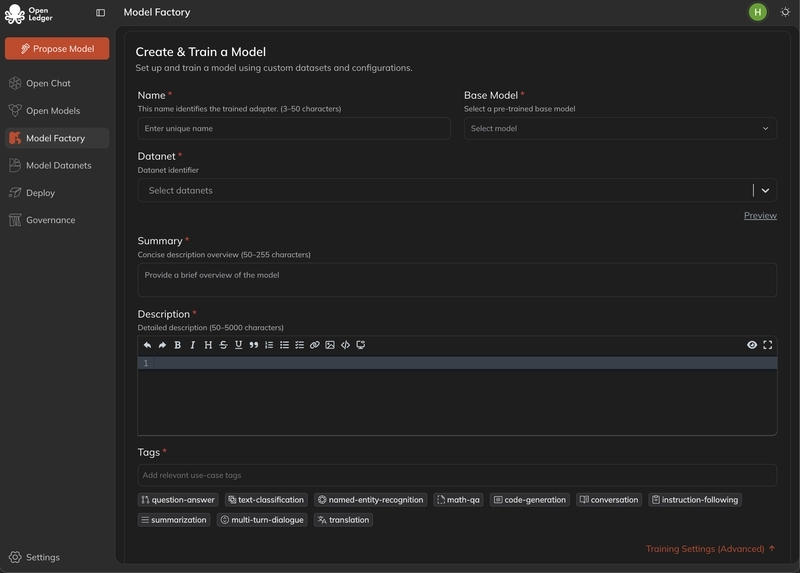
Đầu tiên là lớp Đóng góp của Datanets.
Điều thú vị nhất ở đây chính là các ràng buộc. Văn bản, hình ảnh, âm thanh — bạn không thể trộn mọi thứ với nhau. Nghe hơi lạ, vì khi nói về Web3 thì thường người ta nghĩ đến mọi thứ không cần xin phép. Nhưng ở đây lại ngược lại — định dạng nghiêm ngặt, xác thực nghiêm ngặt. Giới hạn 10 MB mỗi ngày, 20 tệp — nhìn thì có vẻ nhỏ, nhưng thực chất đó không phải là kiểm soát spam, mà là một nỗ lực để giữ đúng tỷ lệ tín hiệu trên nhiễu. Vì nếu không giới hạn, ai cũng sẽ đóng góp, nhưng sẽ khó tìm ra giá trị.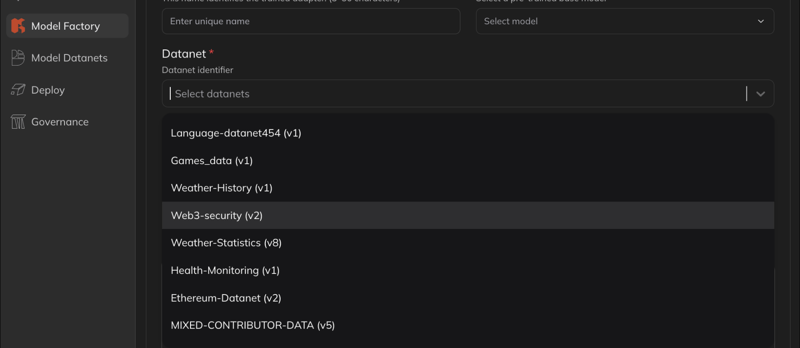
Một điều khác trông cũng hơi buồn cười — hệ thống bảng xếp hạng.
Bạn có thể đang nghĩ: "mình upload càng nhiều thì mình sẽ càng cao" — nhưng không, hoàn toàn không phải vậy. Ở đây, không phải số lượng quan trọng, mà là tỷ lệ chấp nhận. Ý mình là, nếu bạn đưa 10 dữ liệu sai, cái ego của bạn có thể thấy vui, nhưng hệ thống sẽ chẳng quan tâm đến bạn. Nghe hơi phũ, nhưng công bằng. Và phần thú vị là các tệp bị từ chối không làm giảm thứ hạng. Đây là một thiết kế kỳ lạ nhưng lành mạnh một cách đáng ngạc nhiên. Vì ở đây khuyến khích thử nghiệm, chứ không khuyến khích đóng góp xuất phát từ nỗi sợ.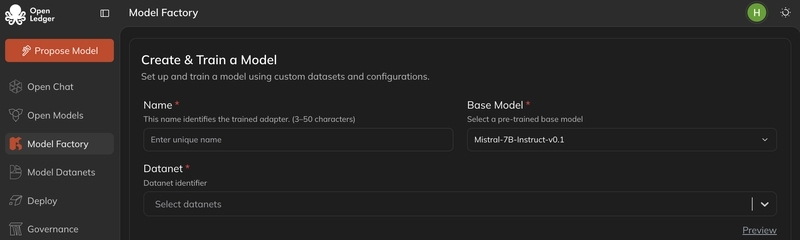
Vậy là đến cơ chế của ModelFactory.
Đây thực sự là phần nghiêm túc nhất của OpenLedger. Nó thay đổi hoàn toàn bầu không khí ở đây. Họ đang cố gắng biến việc tinh chỉnh LLM thành một quy trình làm việc được dẫn dắt bằng giao diện, thay vì chỉ giữ nó như một công cụ nghiên cứu. Điều đó có nghĩa là bạn không cần phải là một chiến binh dùng terminal. Tỷ lệ học, kích thước batch, số epoch — tất cả đều có thể được điều chỉnh trực quan. Nhìn thoáng qua thì có vẻ — ổn, thân thiện cho người mới, nhưng thật ra đằng sau đó còn một ý tưởng sâu hơn — dân chủ hóa phát triển AI mà không mất quyền kiểm soát.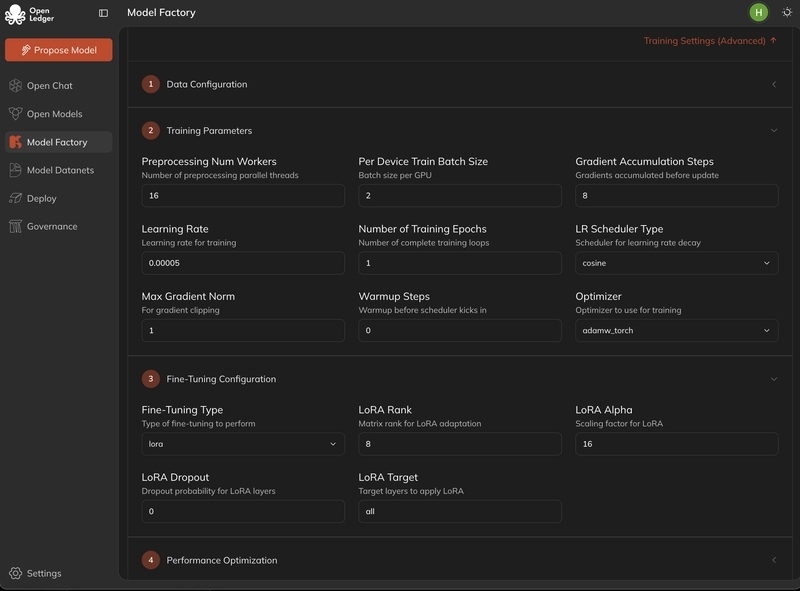
Hỗ trợ cho LoRA và QLoRA là một hướng đi thực tế ở đây. Bởi vì việc tinh chỉnh đầy đủ trong thực tế hôm nay rất tốn kém. Vậy nên họ đang đi theo lối điều chỉnh nhẹ. Bảng điều khiển thời gian thực và tương tác sau khi huấn luyện — thứ này khá thú vị, vì họ muốn biến việc huấn luyện mô hình thành một vòng lặp liên tục mà không để lại điểm kết thúc. Điều đó có nghĩa là huấn luyện ⇨ kiểm thử ⇨ tương tác ⇨ tinh chỉnh lại.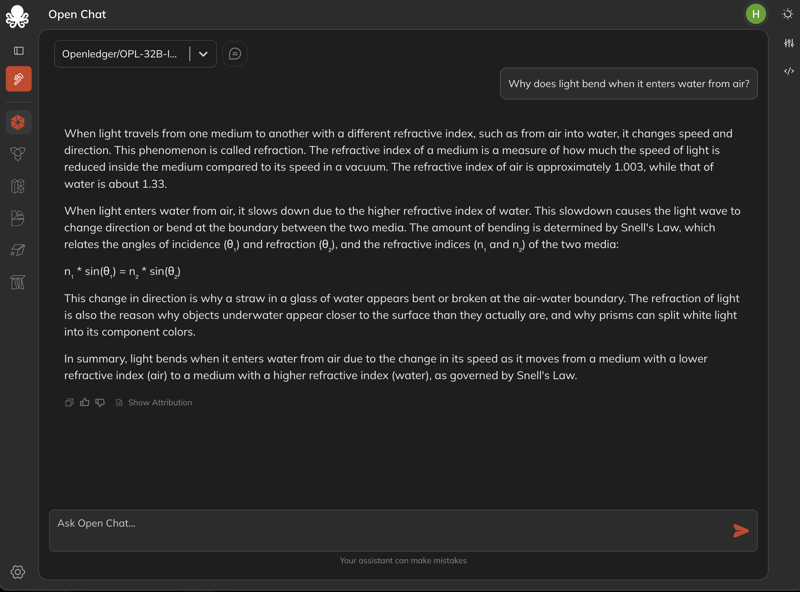
Bây giờ hãy nói về các LLM được hỗ trợ.
Deepseek, Mistral, Qwen, loạt LLaMA — tất cả các hệ sinh thái mã nguồn mở lớn đều có mặt ở đây. Thậm chí tới cả GPT-2, BLOOM, ChatGLM cũng được hỗ trợ. Ban đầu có thể bạn nghĩ rằng họ đưa hết tất cả, nhưng thật ra đó là chiến lược phủ sóng hệ sinh thái. Bởi vì nếu bạn chỉ giữ các mô hình thuộc nhóm tinh hoa, thì bạn sẽ bị giới hạn. Còn hỗ trợ rộng đồng nghĩa với không gian thử nghiệm lớn.
Giờ để mình kể bạn nghe một phần hơi buồn cười
Một hình ảnh hiện lên trong đầu khi mình thấy cả hệ thống này — như một căn bếp rất kỷ luật, nơi không ai được phép ném nguyên liệu một cách ngẫu nhiên. Nhưng khi việc nấu nướng kết thúc, mọi người đều có thể nếm thử và đánh giá. Điều đó có nghĩa là bạn không thể tồn tại ở đây chỉ bằng những rung cảm tốt đẹp, ngay cả khi bạn muốn.
Phần cuối cùng trong Hướng dẫn của Agent thực ra là phần bị đánh giá thấp nhất.
Bởi vì ở đây có nói rằng, với các truy vấn sâu, có thể lấy được câu trả lời động bằng cách sử dụng URL của GitBook. Về cơ bản, nó không phải là những tài liệu tĩnh, mà là một hệ thống kiến thức có thể truy vấn được.
Giờ nếu nghĩ về điều này một cách tổng quát, có một điều trở nên rõ ràng..... @OpenLedger Sự thật nằm giữa hai lực căng: một bên là phi tập trung + đóng góp mở, bên kia là xác thực nghiêm ngặt + cấu trúc được kiểm soát. Không dễ để giữ cân bằng cả hai thứ đó cùng lúc. Nhưng nếu cân bằng đúng, thì nó có thể tạo ra một nền kinh tế dữ liệu thực sự thay vì nhiễu. Và để nói thật, đây là chỗ câu chuyện trở nên thú vị — dữ liệu thực sự sẽ là một tài sản của tương lai, hay chúng ta chỉ đang cố gắng giải quyết một bài toán xác thực cũ với một cái tên mới?
Mình không chắc liệu bây giờ có câu trả lời cuối cùng hay không. Nhưng như một lớp thí nghiệm, thì cũng không nên bỏ qua... Nhưng thực sự🚀