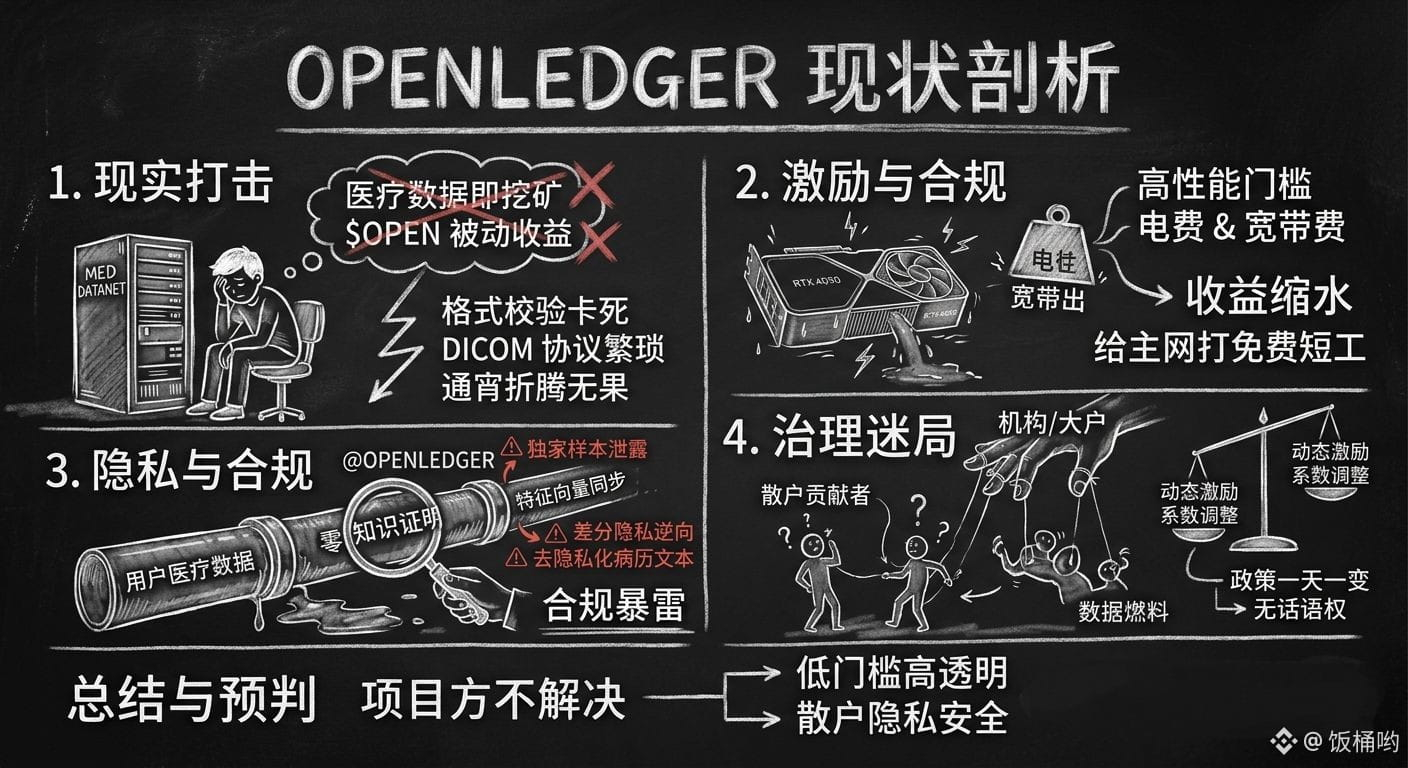
Mấy hôm trước thấy trên quảng trường ai cũng bàn về nền tảng chú thích hình ảnh y tế AI @OpenLedger , mình hơi bốc đồng nên đã tải bộ dữ liệu cắt lát bệnh lý da mà studio tích lũy lên Med DataNet. Kết quả là mất cả một đêm để vật lộn, bị kẹt ở bước kiểm tra định dạng, bị cái bộ giao thức chuyển đổi DICOM phức tạp và logic căn chỉnh nhãn làm cho gần như phát điên.
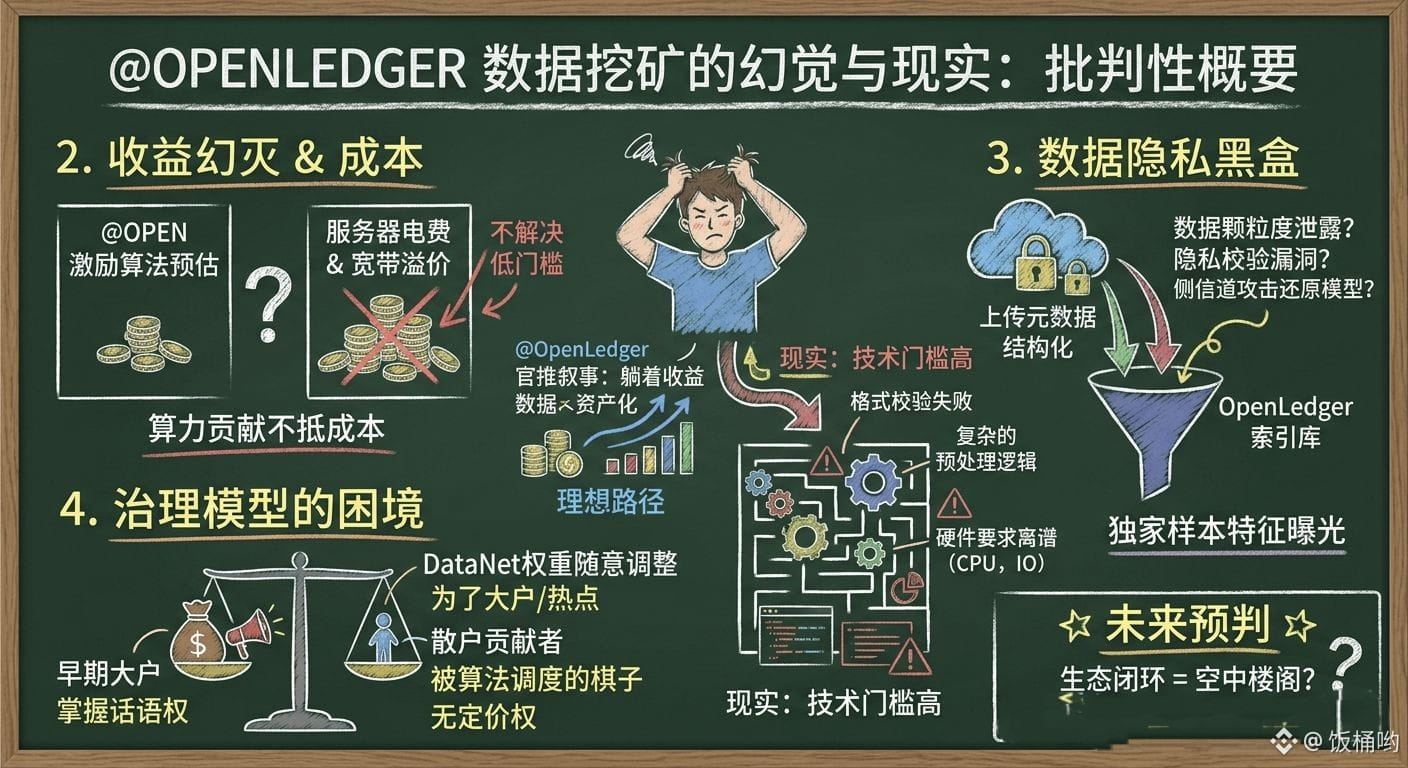
Mình thừa nhận trước đó bị cái câu chuyện lớn lao về dữ liệu y tế và khai thác từ họ làm cho máu nóng, tưởng tượng chỉ cần đẩy tài sản tích trữ lên là có thể ngồi hưởng lợi nhuận thụ động $OPEN . Nhưng khi thực sự đi triển khai nút xác thực, thực tế đã cho mình một cái tát. Trong tài liệu chính thức họ gọi đây là xây dựng cộng đồng với ngưỡng thấp, nhưng thực tế yêu cầu về băng thông và dung lượng bộ nhớ quá cao. Mình đã dùng chiếc workstation 4090 max cấu hình của mình chạy suốt ba ngày, theo công thức khuyến khích mới nhất của họ tính toán, trừ đi phí điện chạy hết công suất và phí băng thông thương mại, số $OPEN mình nhận được chỉ đủ mua một cốc cà phê, thực sự chỉ là làm việc ngắn hạn miễn phí cho mạng chính.
Cái khiến mình sợ hơn cả việc lợi nhuận giảm sút là cái hố đen không đáy về quyền sở hữu dữ liệu và tính tuân thủ. @OpenLedger cứ gặp ai cũng khoe khoang về công nghệ chứng minh không biết và mã hóa đồng nhất của họ, nói rằng có thể làm cho dữ liệu có thể sử dụng nhưng không thể thấy. Nhưng trong thực tế, để có được trọng số khuyến khích cao, bạn phải đóng gói và đồng bộ các vector đặc trưng dữ liệu và văn bản hồ sơ bệnh án đã được phi riêng tư. Dữ liệu y tế dù nói miệng là lưu trữ phi tập trung và ẩn danh, nhưng ai có thể đảm bảo các nút định tuyến ở tầng truy vấn sẽ không bị hacker đảo ngược thông qua riêng tư vi phân? Một khi xảy ra rò rỉ mẫu độc quyền, người chịu trách nhiệm sẽ không phải chúng ta, những thợ mỏ số cung cấp dữ liệu sao? #OpenLedger
Còn tệ hơn nữa là bầu không khí quản trị cộng đồng của $OPEN bây giờ, chính sách thay đổi từng ngày, chúng ta, những nhà đầu tư nhỏ lẻ, không có quyền được biết, nói gì đến quyền phát ngôn, nói thẳng ra là bị nhà cái thu hoạch liên tục. Giờ mình đã hoàn toàn hết hy vọng, @OpenLedger thực sự có đang làm cách mạng cách phân phối tư liệu sản xuất AI hay chỉ lợi dụng vỏ bọc AI phi tập trung để vẽ ra những giấc mơ mới, không cần phải tranh cãi. Nói thẳng ra, nếu đội ngũ dự án không coi trọng sự an toàn riêng tư và tính minh bạch lợi nhuận của nhà đầu tư nhỏ lẻ, chỉ dựa vào vài cá mập trong cộng đồng để thao túng, thì cái câu chuyện Web3+AI này cuối cùng chỉ là một giấc mơ hảo huyền.
Mình thừa nhận trước đó bị cái câu chuyện lớn lao về dữ liệu y tế và khai thác từ họ làm cho máu nóng, tưởng tượng chỉ cần đẩy tài sản tích trữ lên là có thể ngồi hưởng lợi nhuận thụ động $OPEN . Nhưng khi thực sự đi triển khai nút xác thực, thực tế đã cho mình một cái tát. Trong tài liệu chính thức họ gọi đây là xây dựng cộng đồng với ngưỡng thấp, nhưng thực tế yêu cầu về băng thông và dung lượng bộ nhớ quá cao. Mình đã dùng chiếc workstation 4090 max cấu hình của mình chạy suốt ba ngày, theo công thức khuyến khích mới nhất của họ tính toán, trừ đi phí điện chạy hết công suất và phí băng thông thương mại, số $OPEN mình nhận được chỉ đủ mua một cốc cà phê, thực sự chỉ là làm việc ngắn hạn miễn phí cho mạng chính.
Cái khiến mình sợ hơn cả việc lợi nhuận giảm sút là cái hố đen không đáy về quyền sở hữu dữ liệu và tính tuân thủ. @OpenLedger cứ gặp ai cũng khoe khoang về công nghệ chứng minh không biết và mã hóa đồng nhất của họ, nói rằng có thể làm cho dữ liệu có thể sử dụng nhưng không thể thấy. Nhưng trong thực tế, để có được trọng số khuyến khích cao, bạn phải đóng gói và đồng bộ các vector đặc trưng dữ liệu và văn bản hồ sơ bệnh án đã được phi riêng tư. Dữ liệu y tế dù nói miệng là lưu trữ phi tập trung và ẩn danh, nhưng ai có thể đảm bảo các nút định tuyến ở tầng truy vấn sẽ không bị hacker đảo ngược thông qua riêng tư vi phân? Một khi xảy ra rò rỉ mẫu độc quyền, người chịu trách nhiệm sẽ không phải chúng ta, những thợ mỏ số cung cấp dữ liệu sao? #OpenLedger
Còn tệ hơn nữa là bầu không khí quản trị cộng đồng của $OPEN bây giờ, chính sách thay đổi từng ngày, chúng ta, những nhà đầu tư nhỏ lẻ, không có quyền được biết, nói gì đến quyền phát ngôn, nói thẳng ra là bị nhà cái thu hoạch liên tục. Giờ mình đã hoàn toàn hết hy vọng, @OpenLedger thực sự có đang làm cách mạng cách phân phối tư liệu sản xuất AI hay chỉ lợi dụng vỏ bọc AI phi tập trung để vẽ ra những giấc mơ mới, không cần phải tranh cãi. Nói thẳng ra, nếu đội ngũ dự án không coi trọng sự an toàn riêng tư và tính minh bạch lợi nhuận của nhà đầu tư nhỏ lẻ, chỉ dựa vào vài cá mập trong cộng đồng để thao túng, thì cái câu chuyện Web3+AI này cuối cùng chỉ là một giấc mơ hảo huyền.