


Việc chuyển lời nhắc bằng văn bản thành câu chuyện trực quan có sức thuyết phục đã được xác định là một thách thức quan trọng trong lĩnh vực tạo văn bản thành video, nơi có nhiều mô hình đang xuất hiện. Nhiệm vụ này, khác với cách làm phim truyền thống, đòi hỏi một loạt khả năng khác, tương tự như chỉ đạo và việc thành thạo Tạo đối tượng video (VOG) có thể là một thách thức khá lớn. Ngoài ra, khả năng quan sát nhạy bén bản thân nó cũng là một hình thức nghệ thuật.
Để giải quyết vấn đề này, VideoDirectorGPT mang đến một cách tiếp cận sáng tạo để tạo ra các video nhiều cảnh chính xác và nhất quán, đồng thời hợp lý hóa quy trình. Về cốt lõi, VideoDirectorGPT sử dụng phương pháp hai giai đoạn kết hợp sức mạnh của Mô hình ngôn ngữ lớn (LLM) với nghệ thuật lên lịch video.
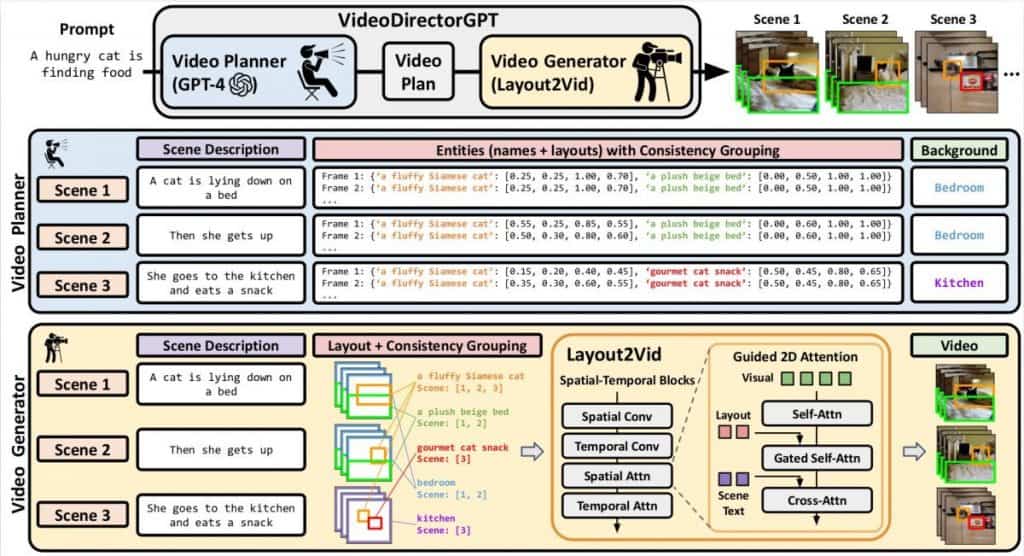
Lập lịch có hướng dẫn của LLM Trong giai đoạn đầu tiên, VideoDirectorGPT sử dụng LLM làm công cụ lập lịch video. LLM đóng vai trò là bậc thầy kể chuyện, tạo ra câu chuyện bao quát cho video nhiều cảnh. Bản tường thuật này bao gồm các mô tả văn bản ở cấp độ cảnh, danh sách chi tiết các đối tượng và hình nền trong mỗi cảnh, bố cục đối tượng theo từng khung hình chính xác với các hộp giới hạn và các nhóm mạch lạc thông minh cho các đối tượng và hình nền.
Layout2Vid Video GenerationSau khi LLM xây dựng kế hoạch video một cách tỉ mỉ, đã đến lúc đưa nó vào hoạt động. Đây là lúc Layout2Vid, mô-đun tạo video phát huy tác dụng. Mở rộng trên bản thiết kế được tạo ở giai đoạn đầu, Layout2Vid sử dụng các phần nhúng hình ảnh và văn bản giống hệt nhau để mô tả các đối tượng và hình nền trong kế hoạch video. Nhưng phần đáng chú ý — nó cung cấp khả năng kiểm soát không gian đối với bố cục đối tượng thông qua cơ chế chú ý 2D tinh vi được tích hợp vào đơn vị chú ý không gian.
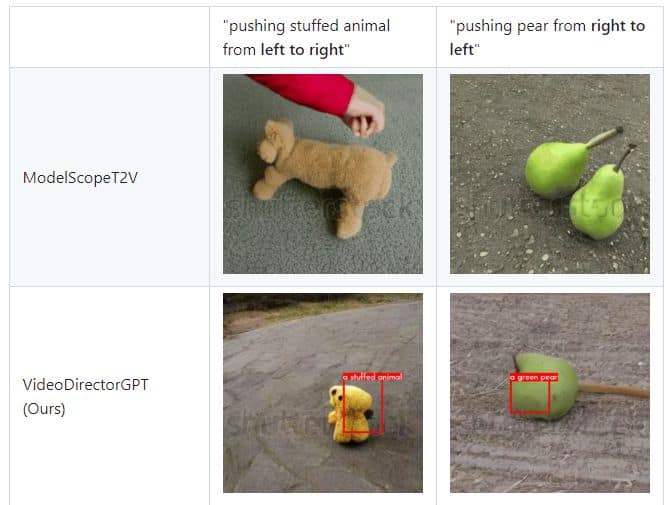 Mô hình VideoDirectorGPT có thể tạo ra một kế hoạch video kỹ lưỡng với các vị trí hộp giới hạn đối tượng chính xác (được phủ), một người nhất quán trong suốt các cảnh và lời nhắc văn bản gốc được mở rộng hợp lý để hiển thị quy trình. Bánh caraway và melba đào là những món ăn duy nhất mà ModelScopeT2V tạo ra và chúng khác nhau tùy theo từng cảnh.
Kết quả là một video được dàn dựng liền mạch, tuân thủ các mô tả văn bản ban đầu, chuyển chúng thành các chuỗi hình ảnh động. Đó là sự kết hợp giữa xây dựng câu chuyện do AI điều khiển và kết xuất video tỉ mỉ, đảm bảo rằng nội dung được tạo ra phù hợp chính xác với tầm nhìn của người sáng tạo.
Vào tháng 8, Yandex đã giới thiệu một tính năng mới có tên Master kiệt, cho phép người dùng tạo các video ngắn có thời lượng tối đa 4 giây với tốc độ khung hình 24 khung hình mỗi giây. Công nghệ này sử dụng phương pháp khuếch tán theo tầng để tạo các khung hình video tiếp theo, tạo ra hình ảnh phù hợp với mô tả của người dùng. Kiệt tác cung cấp khả năng truy cập và sự đơn giản, khiến nó trở thành một lựa chọn hấp dẫn cho người mới và người dùng ở mọi cấp độ kỹ năng. Ý nghĩa rộng hơn của công nghệ vượt ra ngoài phạm vi thể hiện sáng tạo và có thể xác định lại việc tạo và tiêu thụ nội dung số.
Ngoài ra, đầu năm nay, Runway đã phát hành Gen-2, một mô hình chuyển văn bản thành video có thể tạo video mới từ đầu bằng cách sử dụng lời nhắc văn bản, một cải tiến đáng kể so với phiên bản trước. Tính năng này giúp tiết kiệm thời gian và công sức bằng cách tạo video không yêu cầu kỹ năng chỉnh sửa nâng cao. Ngoài ra, Gen-2 có thể chuyển đổi hình ảnh được tải lên thành video clip ngắn có chất lượng cao hơn đối thủ. Công nghệ này được kỳ vọng sẽ cải thiện việc tạo và chia sẻ nội dung trên các nền tảng truyền thông xã hội, có khả năng mang lại lợi ích cho các nền tảng như Facebook và TikTok.
Đọc thêm các chủ đề liên quan:
50 lời nhắc AI chuyển văn bản thành video hay nhất: Hoạt hình hình ảnh dễ dàng
Hơn 10 công cụ tạo AI chuyển văn bản thành video tốt nhất: Mạnh mẽ và miễn phí
Bài đăng VideoDirectorGPT: Giám đốc được hỗ trợ bởi AI đang định hình lại quá trình sản xuất chuyển văn bản thành video xuất hiện đầu tiên trên Metaverse Post.