


Основні висновки
Binance використовує управління потужністю для незапланованих скачків трафіку, спричинених високою волатильністю, забезпечуючи адекватну своєчасну інфраструктуру та обчислювальні ресурси для потреб бізнесу.
Навантажувальні тести Binance проводяться у робочому середовищі (а не в проміжному середовищі), щоб отримати точні контрольні показники обслуговування. Цей метод допомагає підтвердити, що наш розподіл ресурсів достатній для обслуговування визначеного навантаження.
Інфраструктура Binance працює з великими обсягами трафіку, і підтримка служби, на яку користувачі можуть покластися, вимагає належного керування потужністю та автоматичного тестування навантаження.

Чому Binance потрібен спеціалізований процес керування потужністю?
Керування потужністю є основою стабільності системи. Це передбачає використання додатків та інфраструктурних ресурсів правильного розміру з поточними та майбутніми потребами бізнесу за правильною ціною. Щоб допомогти досягти цієї мети, ми створюємо інструменти керування потужністю та конвеєри, щоб уникнути перевантаження та допомогти компаніям забезпечити безперебійну роботу користувачів.
Криптовалютні ринки часто стикаються з більш регулярними періодами волатильності, ніж традиційні фінансові ринки. Це означає, що система Binance повинна час від часу витримувати такий сплеск трафіку, коли користувачі реагують на рух ринку. Завдяки належному управлінню пропускною здатністю ми підтримуємо потужність, достатню для загального бізнес-попиту та сценаріїв різкого трафіку. Саме цей ключовий момент робить процеси управління потенціалом Binance унікальними та складними.
Давайте розглянемо фактори, які часто перешкоджають процесу та призводять до повільної або недоступної служби. По-перше, ми маємо перевантаження, зазвичай викликане раптовим збільшенням трафіку. Наприклад, це може бути результатом маркетингової події, push-повідомлення або навіть DDoS-атаки (розподілена відмова в обслуговуванні).
Стрибковий трафік і недостатня ємність впливають на функціональність системи, як:
Сервіс бере на себе все більше роботи.
Час відповіді збільшується настільки, що на жоден запит не можна відповісти протягом часу очікування клієнта. Це погіршення зазвичай відбувається через перенасиченість ресурсів (ЦП, пам’ять, ввід-вивід, мережа тощо) або тривалі паузи GC у самій службі чи її залежностях.
У результаті сервіс не зможе оперативно обробляти запити.
Порушення процесу
Тепер, коли ми обговорили загальний принцип управління потужністю, давайте подивимося, як Binance застосовує це у своєму бізнесі. Ось короткий огляд архітектури нашої системи керування потужністю з деякими ключовими робочими процесами.
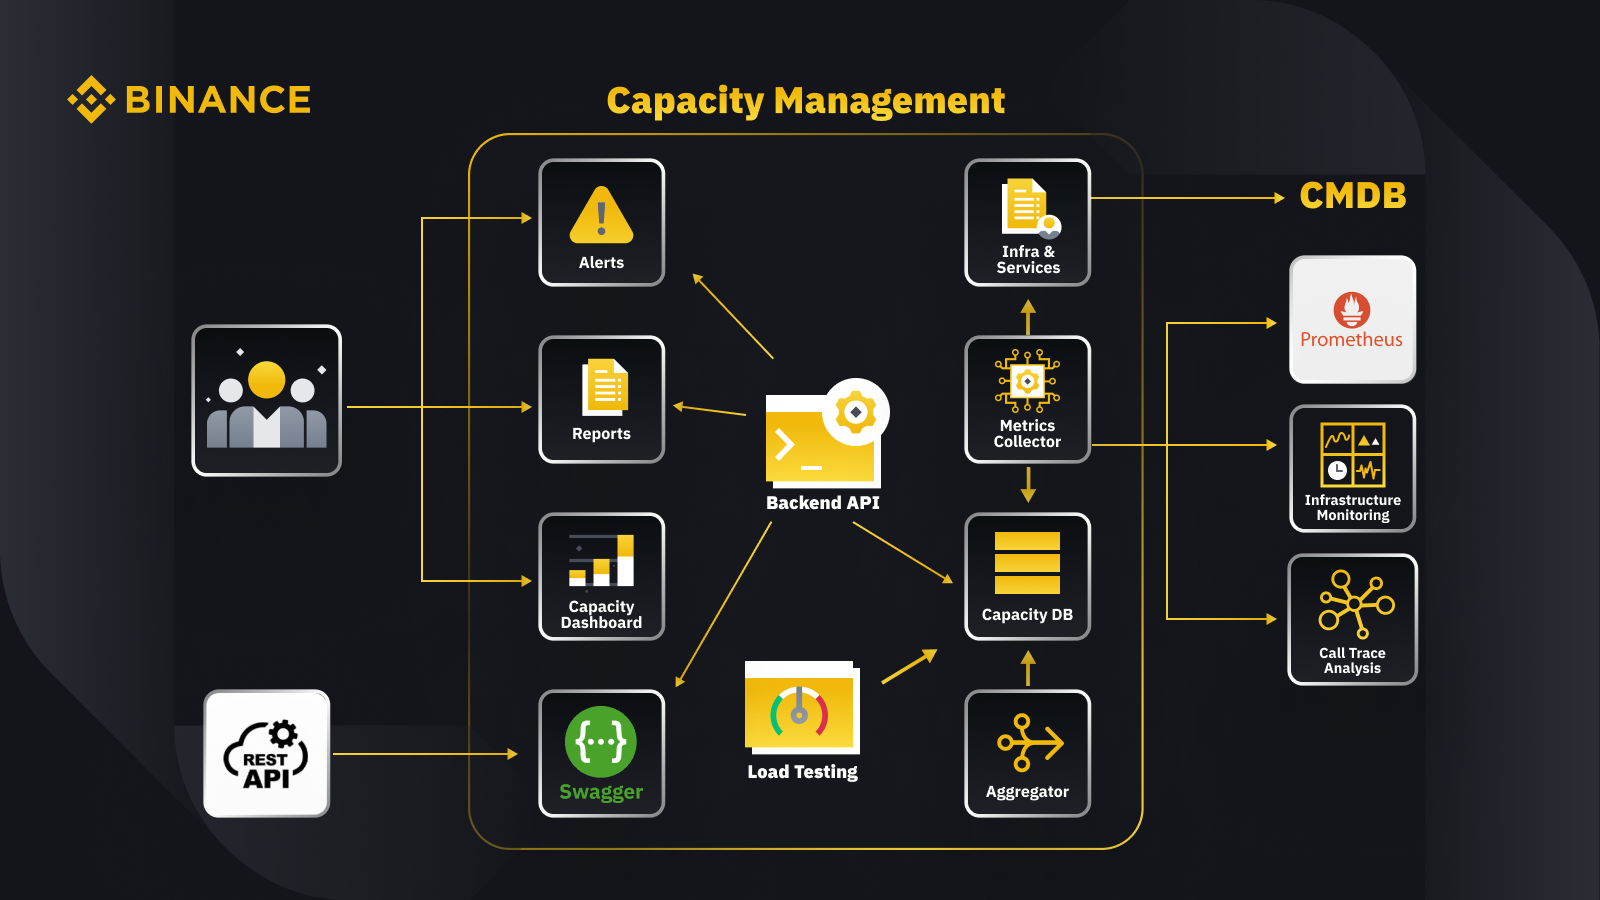
Отримавши дані з бази даних керування конфігураціями (CMDB), ми генеруємо конфігурації інфраструктури та служб. Елементи в цих конфігураціях є об’єктами керування потужністю.
Колекціонер метрик отримує показники потужності з Prometheus для даних бізнес-рівня та сервісного рівня, моніторингу інфраструктури для метрик рівня ресурсів і системи аналізу трасування викликів для інформації трасування. Колекціонер метрик зберігає дані в базі даних ємності (CDB).
Система навантажувального тестування виконує стрес-тести служб і зберігає порівняльні дані в CDB.
Агрегатор отримує дані про ємність із CDB і агрегує їх для щоденних і найвищих (ATH) параметрів. Після агрегування він записує агреговані дані назад у CDB.
Обробляючи дані з CDB, внутрішній API надає інтерфейси для інформаційної панелі потужності, сповіщень і звітів, а також решту API і пов’язані дані про потужність для інтеграції.
Зацікавлені сторони отримують уявлення про потужність за допомогою інформаційної панелі потужності, сповіщень і звітів. Вони також можуть використовувати інші пов’язані системи, включно з моніторингом отримання даних про пропускну здатність служб за допомогою rest API, наданого системою керування потужністю за допомогою Swagger.
Стратегія
Наша стратегія управління потужністю та планування базується на обробці, орієнтованій на пік. Обробка, керована піком, — це робоче навантаження, яке відчувають ресурси служби (веб-сервери, бази даних тощо) під час пікового використання.
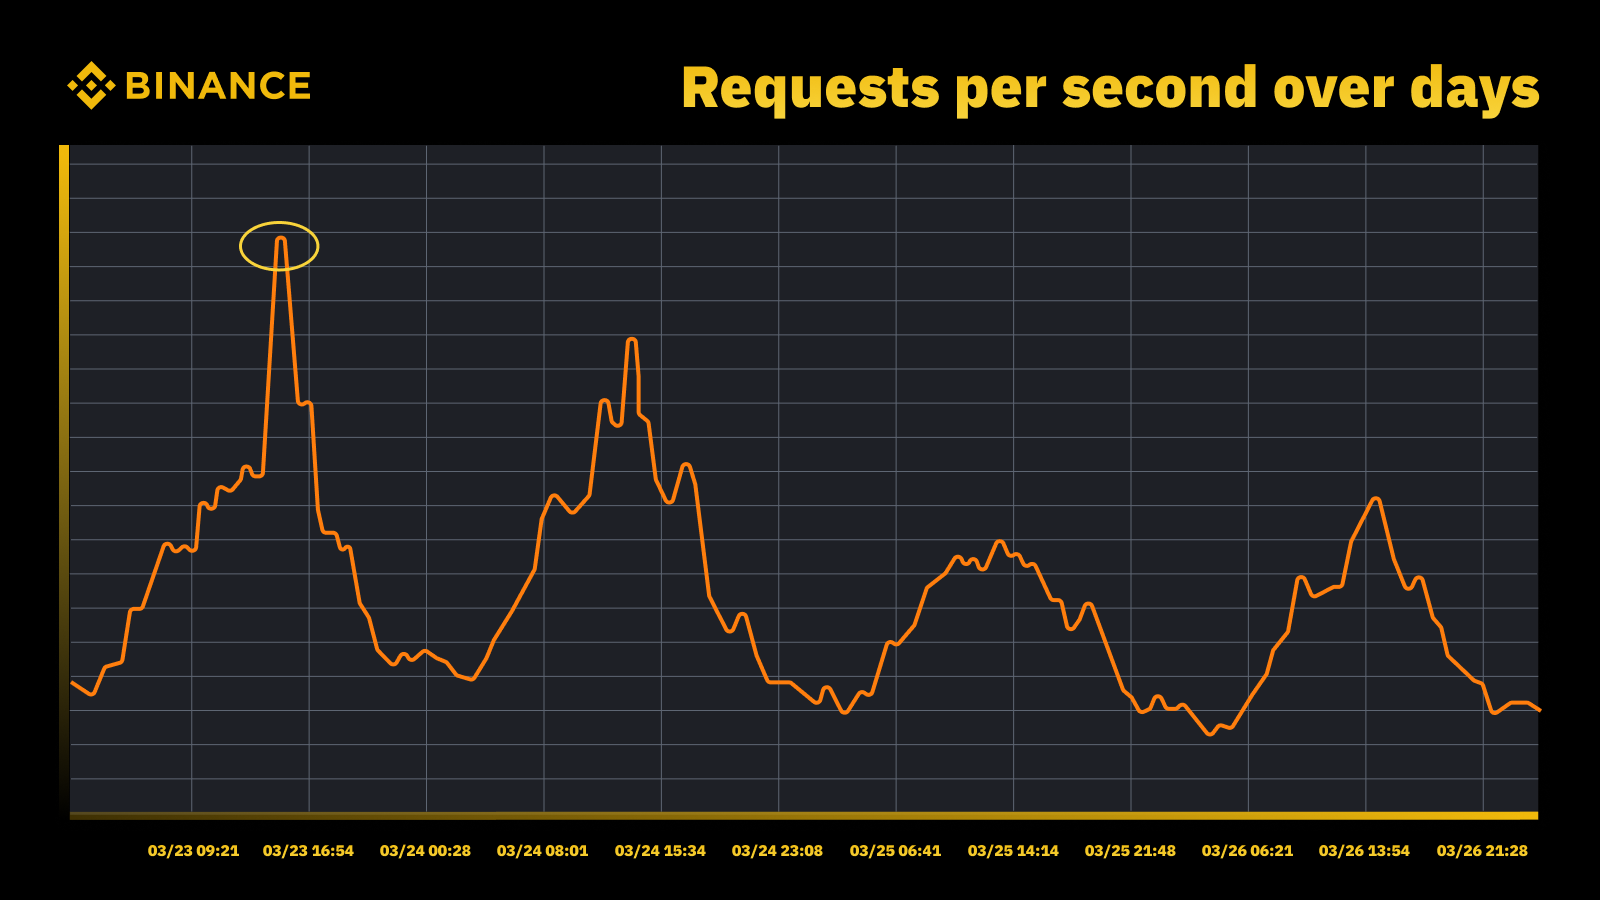
Трафік зріс, коли ФРС підвищила ставку в березні 2023 року
Ми аналізуємо періодичні піки та використовуємо їх для керування траєкторією потужності. Як і з будь-яким ресурсом, орієнтованим на пік, ми хочемо з’ясувати, коли відбуваються піки, а потім дослідити, що насправді відбувається під час цих циклів.
Ще одна важлива річ, яку ми враховуємо разом із запобіганням перевантаженню, — це автомасштабування. Автомасштабування справляється з перевантаженням, динамічно збільшуючи ємність із збільшенням кількості екземплярів служби. Потім надлишковий трафік розподіляється, і трафік, який обробляє один екземпляр служби (або залежності), залишається керованим.
Автомасштабування має своє місце, але не справляється лише з перевантаженнями. Зазвичай він не може достатньо швидко реагувати на раптове збільшення трафіку й найкраще працює, лише коли відбувається поступове збільшення.
Вимірювання
Вимірювання відіграє вирішальну роль у роботі Binance з управління потенціалом, і збір даних є нашим першим кроком вимірювання. На основі стандартів бібліотеки інфраструктури інформаційних технологій (ITIL) ми збираємо дані для вимірювання в підпроцесах управління потужністю, а саме:
Ресурс – споживання ресурсів ІТ-інфраструктури, обумовлене використанням програми/сервісу. Зосереджено на внутрішніх показниках продуктивності фізичних і віртуальних обчислювальних ресурсів, включаючи центральний процесор сервера, пам’ять, дискове сховище, пропускну здатність мережі тощо.
Сервіс. Показники продуктивності на рівні додатка, угоди про рівень обслуговування, затримки та пропускної здатності, які є результатом бізнес-діяльності. Зосереджується на зовнішніх показниках ефективності, заснованих на тому, як користувачі сприймають службу, включаючи затримку служби, пропускну здатність, піки тощо.
Бізнес. Збирає дані, які вимірюють бізнес-діяльність, яку обробляє цільова програма, включаючи замовлення, реєстрацію користувачів, платежі тощо.
Управління потужністю, засноване лише на використанні ресурсів інфраструктури, призведе до неточного планування. Це пояснюється тим, що він може не відображати фактичні обсяги бізнесу та пропускну спроможність нашої інфраструктури.
Заплановані події є чудовим місцем для подальшого обговорення цього питання. Візьміть участь у Watch Web Summit 2022 на Binance Live, щоб поділитися до 15 000 BUSD у кампанії Crypto Box Rewards. Крім базових показників рівня ресурсів і послуг, нам також потрібно було враховувати обсяги бізнесу. Тут ми планували потужність на основі таких бізнес-метрик, як орієнтовна кількість глядачів прямого ефіру, максимальна кількість запитів на Crypto Box, наскрізна затримка та інші фактори.
Після збору даних наші процеси керування потужністю агрегують і узагальнюють численні точки даних, зібрані щодо конкретного драйвера потужності. Сукупне значення метрики — це єдине значення, яке можна використовувати для оповіщення про ємність, звітування та інших функцій, пов’язаних із ємністю.
Ми можемо застосувати кілька методів агрегації даних до періодичних точок даних, як-от сума, середнє значення, медіана, мінімум, максимум, процентиль і абсолютний максимум (ATH).

Обраний нами метод визначає наші результати процесу управління потужністю та результативні рішення. Ми вибираємо різні методи на основі різних сценаріїв. Наприклад, ми використовуємо максимальний метод для критично важливих служб і пов’язаних точок даних. Щоб зафіксувати найбільший трафік, ми використовуємо метод ATH.
Для різних випадків використання ми використовуємо різні типи деталізації для агрегації даних. У більшості випадків ми використовуємо хвилину, годину, день або ATH.
З дрібною деталізацією ми вимірюємо робоче навантаження служби для своєчасного сповіщення про перевантаження.
Ми використовуємо погодинні агреговані дані для створення щоденних даних і агрегування погодинних даних для реєстрації щоденного піку.
Зазвичай ми використовуємо щоденні дані для звітів про потужності та використовуємо дані ATH для моделювання та планування потужностей.
Одним із основних показників управління потужністю є порівняльний аналіз послуг. Це допомагає нам точно вимірювати продуктивність і потужність послуг. Ми отримуємо порівняльний тест служби за допомогою навантажувального тестування, і ми зануримося в це більш детально пізніше.
Управління потужністю на основі пріоритету
Наразі ми бачили, як ми збираємо показники ємності та агрегуємо дані з різними типами деталізації. Інша важлива сфера для обговорення – це пріоритет, який корисний у контексті попереджень і звітів про потужність. Після ранжування ІТ-активів обмежене використання інфраструктури та обчислювальних ресурсів встановлюються пріоритетними та надаються в першу чергу критичним службам і видам діяльності.
Може бути кілька способів визначення послуги та критичності запиту. Корисною довідкою є Google. У кн. Вони визначають рівні критичності як CRITICAL_PLUS, CRITICAL, SHEDDABLE_PLUS тощо. Так само ми визначаємо декілька рівнів пріоритету, наприклад P0, P1, P2 тощо.
Ми визначаємо рівні пріоритету таким чином:
P0: для найбільш важливих служб і запитів, які призведуть до серйозного, видимого для користувача впливу, якщо вони збій.
P1: Для тих послуг і запитів, які призведуть до видимого для користувача впливу, але вплив буде меншим, ніж для P0. Очікується, що послуги P0 і P1 будуть забезпечені достатньою потужністю.
P2: це пріоритет за умовчанням для пакетних і автономних завдань. Ці служби та запити можуть не мати помітного для користувача впливу, якщо вони частково недоступні.
Що таке тестування навантаження і чому ми використовуємо його у виробничому середовищі?
Навантажувальне тестування — це нефункціональний процес тестування програмного забезпечення, під час якого продуктивність програми перевіряється під певним навантаженням. Це допомагає визначити, як поводиться програма під час одночасного доступу кількох кінцевих користувачів.
У Binance ми створили рішення, яке дозволяє нам запускати навантажувальне тестування у виробництві. Як правило, навантажувальне тестування виконується в проміжному середовищі, але ми не могли використовувати цю опцію, виходячи з наших загальних цілей управління потужністю. Навантажувальне тестування у виробничому середовищі дозволило нам:
Зберіть точні показники наших послуг за реальних умов навантаження.
Підвищення довіри до системи та її надійності та продуктивності.
Визначте вузькі місця в системі до того, як вони виникнуть у виробничому середовищі.
Увімкнути постійний моніторинг виробничих середовищ.
Увімкніть проактивне керування потужністю за допомогою нормалізованих циклів тестування, які відбуваються регулярно.
Нижче ви можете побачити нашу структуру тестування навантаження з деякими ключовими висновками:

Фреймворк мікросервісу Binance має базовий рівень для підтримки маршрутизації трафіку на основі конфігурації та прапорів, що важливо для нашого підходу TIP.
Для оцінки екземпляра, який ми тестуємо, використовується автоматичний аналіз Canary (ACA). Він порівнює ключові показники, зібрані в системі моніторингу, тому ми можемо призупинити/завершити тест, якщо трапиться будь-яка несподівана проблема, щоб мінімізувати вплив на користувачів.
Під час навантажувального тестування збираються контрольні показники та показники, щоб отримати інформацію про поведінку та продуктивність програм.
API доступні для обміну цінними даними про продуктивність у різних сценаріях, наприклад, керування потужністю та забезпечення якості. Це допомагає створити відкриту екосистему.
Ми створюємо робочі процеси автоматизації, щоб оркеструвати всі кроки та контрольні точки з точки зору наскрізного тестування. Ми також забезпечуємо гнучкість інтеграції з іншими системами, такими як конвеєр CI/CD і операційний портал.
Наш підхід до тестування у виробництві (TIP).
Традиційний підхід до тестування продуктивності (виконання тестів у проміжному середовищі з імітованим або дзеркальним трафіком) дає певні переваги. Однак у нашому контексті розгортання середовища, схожого на продукцію, має більше недоліків:
Це майже подвоює витрати на інфраструктуру та зусилля з обслуговування.
Надзвичайно складно забезпечити наскрізну роботу у виробництві, особливо у великомасштабному мікросервісному середовищі в кількох бізнес-підрозділах.
Це додає більше ризиків для конфіденційності даних і безпеки, оскільки нам неминуче може знадобитися дублювати дані в проміжному виконанні.
Змодельований трафік ніколи не буде повторювати те, що насправді відбувається у виробництві. Еталонний тест, отриманий у проміжному середовищі, буде неточним і матиме меншу цінність
Тестування у виробництві, також відоме як TIP, — це методологія тестування вправо, коли новий код, функції та випуски тестуються у виробничому середовищі. Тестування навантаження у виробництві, яке ми застосували, є дуже корисним, оскільки воно допомагає нам:
Проаналізуйте стабільність і надійність системи.
Дізнайтеся про контрольні показники та вузькі місця додатків за різних рівнів трафіку, специфікацій сервера та параметрів додатків.
Маршрутизація на основі FlowFlag
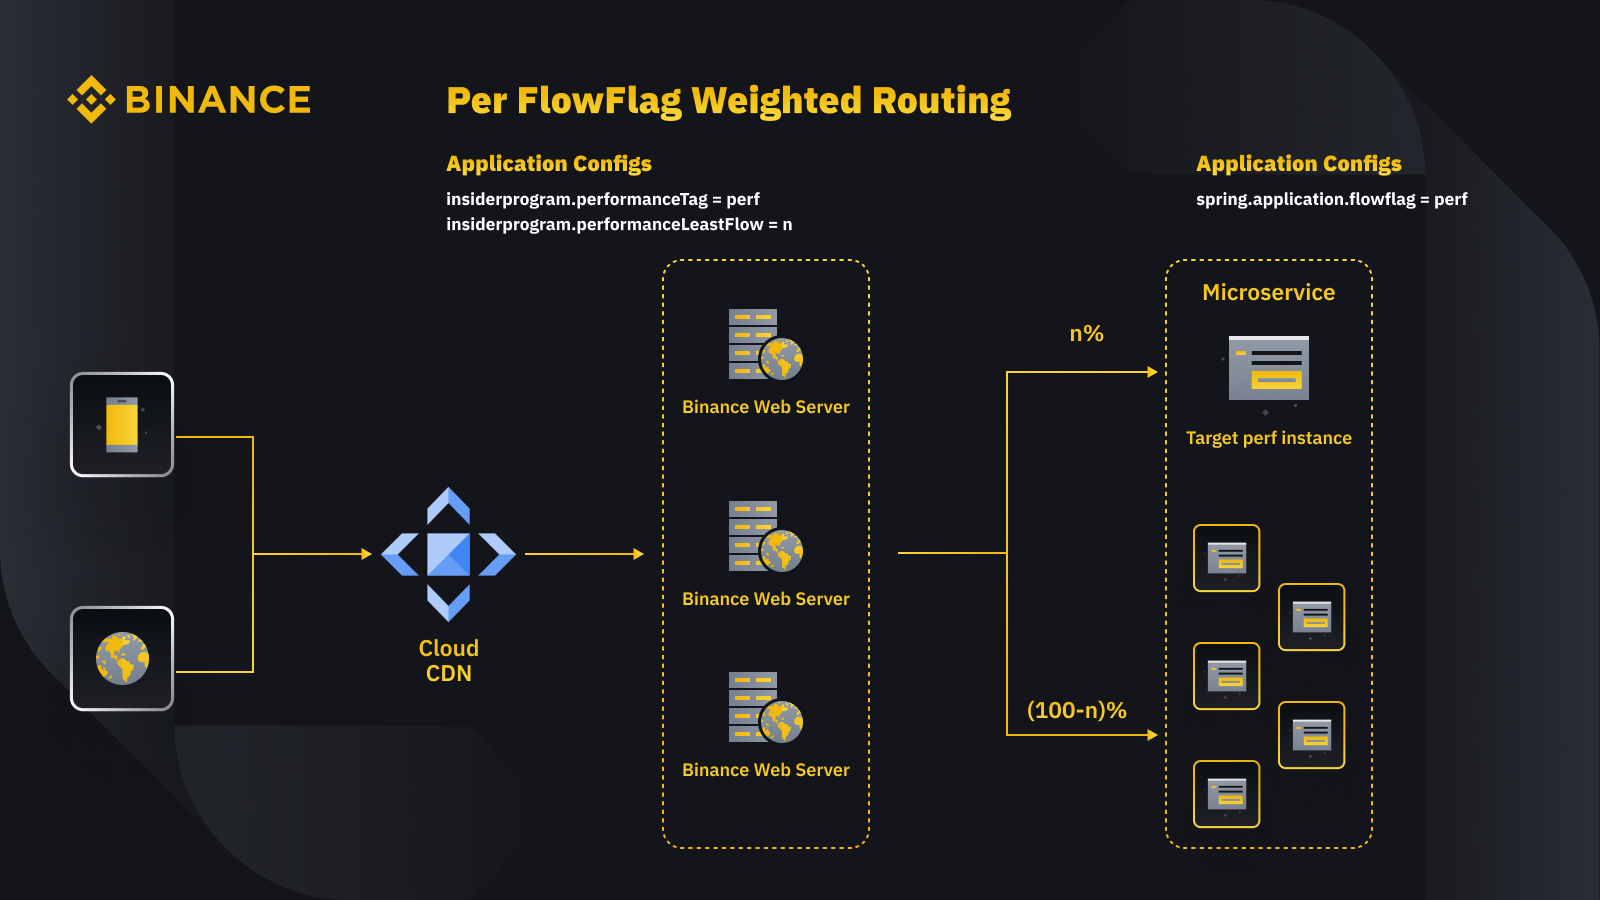
Наша маршрутизація на основі FlowFlag, вбудована в базову структуру мікросервісу, є основою для створення TIP. Це стосується окремих випадків, зокрема додатків, які використовують виявлення служби Eureka для розподілу трафіку.
Як показано на діаграмі, веб-сервер Binance як точки входу позначає деякий відсоток трафіку, як зазначено в конфігураціях, за допомогою заголовків FlowFlag, під час навантажувального тесту ми можемо вибрати один хост певної служби та позначити його як екземпляр цільової продуктивності в configs, тоді ці запити з міткою perf будуть зрештою спрямовані до екземпляра perf, коли вони досягнуть служби для обробки.
Він повністю керується конфігурацією та гарячим завантаженням, ми можемо легко регулювати відсоток робочого навантаження за допомогою автоматизації без необхідності розгортати новий випуск
Його можна широко застосовувати до більшості наших послуг, оскільки механізм є частиною шлюзу та базового пакету
Одна точка зміни також означає легкий відкат для зменшення ризиків у виробництві
Перетворюючи наше рішення на хмарне, ми також досліджуємо, як ми можемо створити подібний підхід для підтримки іншого маршрутизації трафіку, що пропонується постачальниками загальнодоступних хмар або Kubernetes.
Автоматичний аналіз Canary для мінімізації ризиків впливу на користувачів
Розгортання Canary — це стратегія розгортання, спрямована на зменшення ризику розгортання нової версії програмного забезпечення у виробництві. Зазвичай це передбачає розгортання нової версії програмного забезпечення, яка називається випуском Canary, для невеликої підмножини користувачів поряд із стабільною версією. Потім ми розподіляємо трафік між двома версіями, щоб частина вхідних запитів перенаправлялася на канарку.
Потім якість канаркової версії оцінюється за допомогою так званого канаркового аналізу. Це порівнює ключові показники, які описують поведінку старої та нової версій. У разі значного погіршення показників канарку припиняється, а весь трафік спрямовується до стабільної версії, щоб мінімізувати вплив неочікуваної поведінки.
Ми використовуємо ту саму концепцію, щоб створити наше рішення для автоматичного тестування навантаження. Рішення використовує платформу Kayenta для автоматизованого аналізу канарок (ACA) через Spinnaker, щоб забезпечити автоматизоване розгортання канарок. Наш типовий потік навантажувального тесту за цим методом виглядає так:
За допомогою робочого процесу ми поступово додаємо навантаження трафіку (наприклад, 5%, 10%, 25%, 50%) до цільового хосту, як зазначено, або доки він не досягне своєї межі.
Під кожним навантаженням аналіз канарки виконується кілька разів за допомогою Kayenta протягом деякого часу (наприклад, 5 хвилин), щоб порівняти ключові показники тестованого хоста з періодом перед завантаженням як базовим і поточним періодом після завантаження як експериментом.
Порівняння (модель конфігурації canary) зосереджується на перевірці, чи цільовий хост:
Досягає обмежень ресурсів, наприклад, використання ЦП перевищує 90%.
Має значне збільшення показників помилок, наприклад, журнали помилок, винятки HTTP або обмеження частоти відхилень.
Метрики основної програми все ще розумні, наприклад, затримка HTTP менше 2 секунд (налаштовується для кожної служби)
Для кожного аналізу Kayenta надає нам звіт із зазначенням результату, і тест припиняється одразу після невдачі.
Це виявлення помилки зазвичай займає менше 30 секунд, що значно знижує ймовірність впливу на роботу наших кінцевих користувачів.

Увімкнення Data Insights
Дуже важливо зібрати достатню інформацію про всі описані раніше процеси та виконання тестів. Кінцева мета — підвищити надійність і стійкість нашої системи, що неможливо без аналітичних даних.
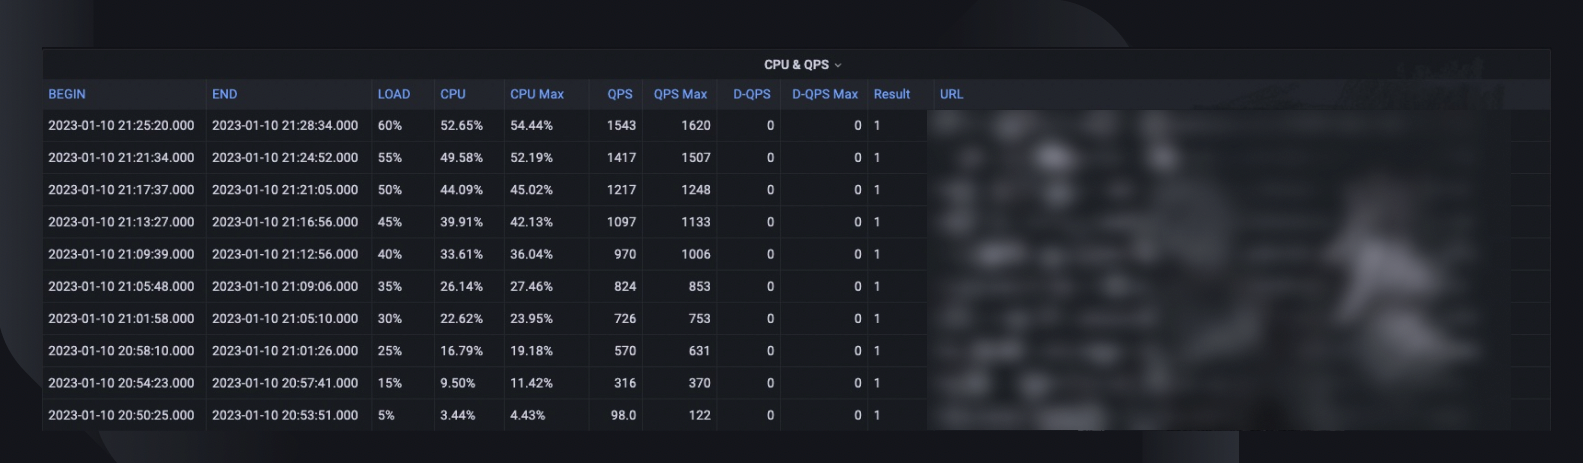
Загальний підсумок тесту фіксує відсоток максимального навантаження, який хост зміг впоратися, максимальне використання ЦП і QPS хоста. Виходячи з цього, він також оцінює кількість екземплярів, які нам, можливо, знадобиться розгорнути, щоб задовольнити наше резервування ємності, враховуючи рекордно високий рівень QPS для служб.
Інша цінна інформація для аналізу включає версію програмного забезпечення, специфікацію сервера, кількість розгорнутих і посилання на інформаційну панель монітора, де ми можемо переглянути, що сталося під час тесту.

Порівняльна крива показує, як змінилася продуктивність за останні три місяці, щоб ми могли виявити будь-які можливі проблеми, пов’язані з певним випуском програми.

Тенденції ЦП і QPS показують, як використання ЦП корелювало з обсягом запитів, який мав обробити сервер. Цей показник може допомогти оцінити запаси сервера для зростання вхідного трафіку.
Поведінка затримки API фіксує, як час відповіді змінюється в різних умовах завантаження п’яти найпопулярніших API. Потім ми можемо оптимізувати систему, якщо потрібно, на рівні окремого API.

Показники розподілу навантаження API допомагають нам зрозуміти, як склад API впливає на продуктивність служби, і дають більше інформації про сфери вдосконалення.
Нормалізація і продукція
Оскільки наша система продовжує рости та розвиватися, ми продовжуватимемо відстежувати та покращувати стабільність і надійність обслуговування. Ми продовжимо це через:
Регулярний і встановлений графік тестування навантаження для критично важливих служб.
Автоматичне тестування навантаження як частина наших конвеєрів CI/CD.
Підвищення продуктивності всього рішення для підготовки до широкомасштабного впровадження в ширшій організації.
Обмеження
Існують певні обмеження щодо поточного підходу тестування навантаження:
Маршрутизація на основі FlowFlag застосовна лише до нашої мікросервісної структури. Ми прагнемо розширити рішення для більшої кількості сценаріїв маршрутизації, використовуючи загальну функцію зваженої маршрутизації хмарних балансувальників навантаження або Kubernetes Ingress.
Оскільки ми базуємо тест на реальному трафіку користувачів у виробництві, ми не можемо виконувати тестування функцій щодо конкретних API або випадків використання. Крім того, для служб із дуже низьким обсягом значення буде обмеженим, оскільки ми не зможемо визначити їх вузьке місце.
Ми проводимо ці тести для окремих служб, а не для наскрізних ланцюжків викликів.
Тест у виробництві іноді може вплинути на реальних користувачів, якщо виникають збої. Тому ми повинні мати аналіз помилок і автоматичний відкат із повною автоматизацією.
Заключні думки
Для нас дуже важливо продумати сценарії різкого трафіку, щоб запобігти перевантаженню системи та забезпечити її безперебійну роботу. Ось чому ми розробили процеси керування потужністю та тестування навантаження, описані в цій статті. Узагальнити:
Наше управління потужністю керується піковими навантаженнями та вбудовано в кожну стадію життєвого циклу служби, запобігаючи перевантаженню такими діями, як вимірювання, налаштування пріоритетів, попередження та звіти про потужність тощо. Це, зрештою, те, що робить процеси та потреби Binance унікальними порівняно з типовою ситуацією керування потужністю .
Тест сервісу, отриманий у результаті навантажувального тестування, є центром управління потужністю та планування. Він точно визначає інфраструктурний ресурс, необхідний для підтримки поточних і майбутніх потреб бізнесу. Зрештою, це довелося виконати у виробництві за допомогою унікального рішення, створеного Binance, яке дозволило нам задовольнити наші конкретні потреби.
З огляду на все це разом, ми сподіваємося, що ви бачите, що гарне планування та ретельні рамки допомагають створити сервіс, який знають і яким насолоджуються Binancians.
Список літератури
Домінік Огбонна, A-Z of Capacity Management: Practical Guide for Implementation Enterprise IT Monitoring & Capacity Planning, Chapter 4, Chapter 6
Луїс Кесада Торрес, Даг Коліш, SRE Найкращі практики управління потужністю
Алехандро Фореро Куерво, Сара Чавіс, книга Google SRE, Розділ 21 – Обробка перевантаження
Подальше читання
(Блог) Як Binance Ledger покращує ваш досвід Binance
(Блог) Представляємо Binance Oracle VRF: наступне покоління верифікованої випадковості
(Блог) Binance приєднується до альянсу FIDO у підготовці до впровадження ключа доступу