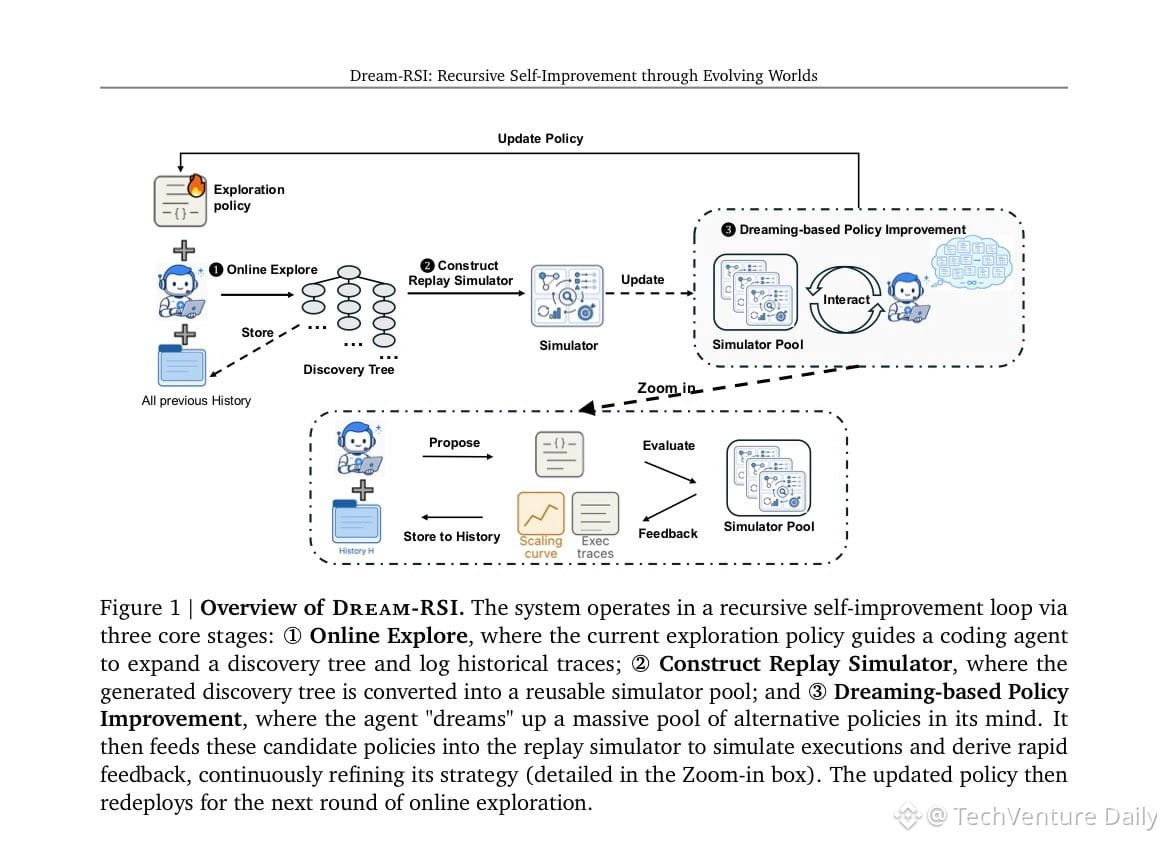
Google DeepMind только что выпустила Dream-RSI: агент, который воспроизводит собственную историю поиска, чтобы оптимизировать политику поиска, не сжигая реальные вычисления.
Ключевой трюк: каждый запуск исследования строит полное дерево того, что было опробовано, оценено и не сработало. Это дерево становится симулятором с нулевой стоимостью. Агент тестирует тысячи новых поисковых стратегий на старых деревьях, прежде чем что-либо запускать в реальном мире.
Бенчмарк для решателя Lasso: Gemini-3.1-Pro с Dream-RSI нашёл более быстрый путь-решатель за 317 вызовов. Замороженная политика требовала 550. SimpleTES — 51,200. Это до 162 раз меньше вызовов агента. Решатель обошёл scikit-learn и glmnet на удержанных данных.
Цикл:
1. Запустить исследование с текущей политикой, записать всё как дерево
2. Преобразовать завершённые деревья в симуляторы воспроизведения
3. Тестировать новые политики по пулу симуляторов с почти нулевой стоимостью
4. Развернуть победителя, который по замыслу не может работать хуже старой политики на зафиксированных мирах
5. Новые запуски добавляют новые миры в пул
Это не улучшение модели. Это улучшение мета-поиска. Агент по кодированию и оценщик остаются неизменными. Лучше становится только «дирижёр исследования» — он обучается на растущей библиотеке прошлых миров.
Оговорки: воспроизведение может оценивать только ветви, которые были реально исследованы. Тонкая история может поддерживать консервативные политики. Неметрегрессность гарантируется для прошлых деревьев, а не для будущих пространств поиска. Код пока не выпущен.
Но ход сделан аккуратно: агенты уже генерировали богатые трассы поиска и затем выбрасывали их. Dream-RSI превращает их в тренировочные полигоны. Впервые рекурсивное самосовершенствование похоже на инженерную практику в продакшене, а не на теорию.
Ключевой трюк: каждый запуск исследования строит полное дерево того, что было опробовано, оценено и не сработало. Это дерево становится симулятором с нулевой стоимостью. Агент тестирует тысячи новых поисковых стратегий на старых деревьях, прежде чем что-либо запускать в реальном мире.
Бенчмарк для решателя Lasso: Gemini-3.1-Pro с Dream-RSI нашёл более быстрый путь-решатель за 317 вызовов. Замороженная политика требовала 550. SimpleTES — 51,200. Это до 162 раз меньше вызовов агента. Решатель обошёл scikit-learn и glmnet на удержанных данных.
Цикл:
1. Запустить исследование с текущей политикой, записать всё как дерево
2. Преобразовать завершённые деревья в симуляторы воспроизведения
3. Тестировать новые политики по пулу симуляторов с почти нулевой стоимостью
4. Развернуть победителя, который по замыслу не может работать хуже старой политики на зафиксированных мирах
5. Новые запуски добавляют новые миры в пул
Это не улучшение модели. Это улучшение мета-поиска. Агент по кодированию и оценщик остаются неизменными. Лучше становится только «дирижёр исследования» — он обучается на растущей библиотеке прошлых миров.
Оговорки: воспроизведение может оценивать только ветви, которые были реально исследованы. Тонкая история может поддерживать консервативные политики. Неметрегрессность гарантируется для прошлых деревьев, а не для будущих пространств поиска. Код пока не выпущен.
Но ход сделан аккуратно: агенты уже генерировали богатые трассы поиска и затем выбрасывали их. Dream-RSI превращает их в тренировочные полигоны. Впервые рекурсивное самосовершенствование похоже на инженерную практику в продакшене, а не на теорию.