Я недавно по-новому понял(а) KGeN: возможно, дело не в том, что не хватает больше данных, а в том, что данные должны быть действительно «человеческими».
Когда я занялся(лась) исследованием KGeN, мое главное впечатление было таким: чем больше данных у ИИ, тем важнее становится вопрос, действительно ли они получены от людей.
Раньше, когда я видел(а) проекты ИИ, которые говорили о данных, я обычно не задерживался(лась) надолго. Ведь сейчас в интернете есть любые данные.
Но проблема как раз в этом.
Сейчас статей, изображений и звуков, сгенерированных ИИ, становится все больше, а роботизированные аккаунты встречаются все чаще. Если в будущем ИИ начнет в большом масштабе обучаться на контенте, который уже был сгенерирован ИИ, не появится ли замкнутый круг?
ИИ генерирует → ИИ обучается → снова генерирует → снова обучает ИИ.
Объемы будут расти, но реальный человеческий опыт, возможно, будет становиться все меньше.
Именно поэтому я начал(а) всерьез смотреть на KGeN.
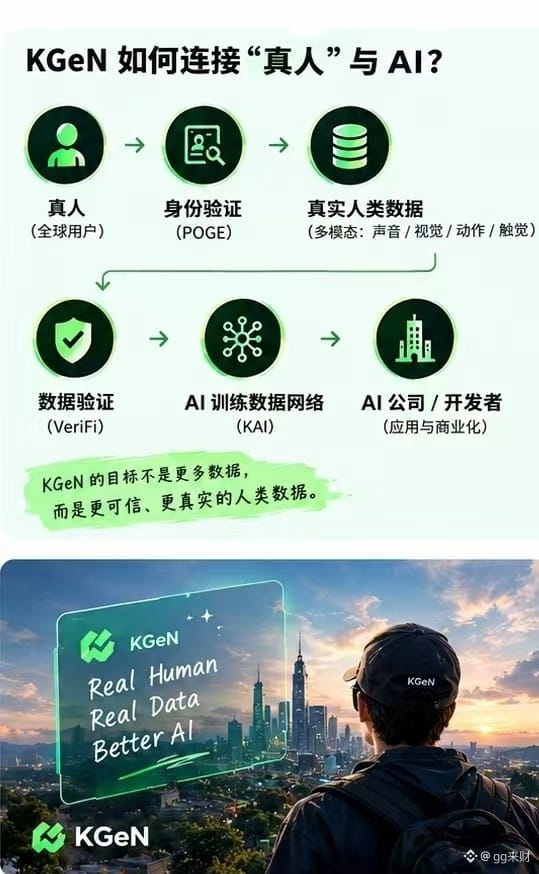
На данный момент KGeN позиционирует себя как Verified Human Network. Его ключевое направление — получение верифицированных реальных человеческих и мультимодальных данных для Physical AI и LLM. В официальных упоминаниях среди типов данных указаны голос, зрение, действия и осязание, а также охват — 60+ стран.
Я думаю, что самое важное здесь — не «горячая» концепция «ИИ», а вот что:
Если в будущем ИИ действительно должен понимать реальный мир, обязателен ли ему сначала понимать реальных людей?
Например, чтобы робот научился жить в реальной среде, одного лишь просмотра картинок из интернета явно недостаточно.
Ему нужно знать, как люди говорят, как действуют, как наблюдают за окружающей средой — и даже какие реакции люди могут проявлять в разных ситуациях.
Тогда реальные данные о людях — это уже не вопрос только объема, а вопрос источника и качества.
Подход KGeN как раз в том, чтобы связать реальных людей, верификацию, мультимодальные данные и потребности в обучении ИИ. В его продуктовой экосистеме также есть K-Quest — с помощью верифицированных людей, выполняющих задания, собираются мультимодальные данные, необходимые для Physical AI и LLM.
Конечно, я не буду сейчас утверждать, что KGeN обязательно добьется успеха.
Для меня важнее то, за чем стоит продолжать наблюдать:
Могут ли реальные пользователи стабильно расти?
Сможет ли потребность в данных продолжать генерироваться?
Смогут ли эти данные действительно использоваться компаниями ИИ?
И наконец — получится ли сформировать долгосрочный коммерческий замкнутый цикл?
Эти вопросы куда интереснее, чем просто смотреть краткосрочные цены.
Этот ответ я продолжаю отслеживать
#KGen
Когда я занялся(лась) исследованием KGeN, мое главное впечатление было таким: чем больше данных у ИИ, тем важнее становится вопрос, действительно ли они получены от людей.
Раньше, когда я видел(а) проекты ИИ, которые говорили о данных, я обычно не задерживался(лась) надолго. Ведь сейчас в интернете есть любые данные.
Но проблема как раз в этом.
Сейчас статей, изображений и звуков, сгенерированных ИИ, становится все больше, а роботизированные аккаунты встречаются все чаще. Если в будущем ИИ начнет в большом масштабе обучаться на контенте, который уже был сгенерирован ИИ, не появится ли замкнутый круг?
ИИ генерирует → ИИ обучается → снова генерирует → снова обучает ИИ.
Объемы будут расти, но реальный человеческий опыт, возможно, будет становиться все меньше.
Именно поэтому я начал(а) всерьез смотреть на KGeN.
На данный момент KGeN позиционирует себя как Verified Human Network. Его ключевое направление — получение верифицированных реальных человеческих и мультимодальных данных для Physical AI и LLM. В официальных упоминаниях среди типов данных указаны голос, зрение, действия и осязание, а также охват — 60+ стран.
Я думаю, что самое важное здесь — не «горячая» концепция «ИИ», а вот что:
Если в будущем ИИ действительно должен понимать реальный мир, обязателен ли ему сначала понимать реальных людей?
Например, чтобы робот научился жить в реальной среде, одного лишь просмотра картинок из интернета явно недостаточно.
Ему нужно знать, как люди говорят, как действуют, как наблюдают за окружающей средой — и даже какие реакции люди могут проявлять в разных ситуациях.
Тогда реальные данные о людях — это уже не вопрос только объема, а вопрос источника и качества.
Подход KGeN как раз в том, чтобы связать реальных людей, верификацию, мультимодальные данные и потребности в обучении ИИ. В его продуктовой экосистеме также есть K-Quest — с помощью верифицированных людей, выполняющих задания, собираются мультимодальные данные, необходимые для Physical AI и LLM.
Конечно, я не буду сейчас утверждать, что KGeN обязательно добьется успеха.
Для меня важнее то, за чем стоит продолжать наблюдать:
Могут ли реальные пользователи стабильно расти?
Сможет ли потребность в данных продолжать генерироваться?
Смогут ли эти данные действительно использоваться компаниями ИИ?
И наконец — получится ли сформировать долгосрочный коммерческий замкнутый цикл?
Эти вопросы куда интереснее, чем просто смотреть краткосрочные цены.
Этот ответ я продолжаю отслеживать
#KGen