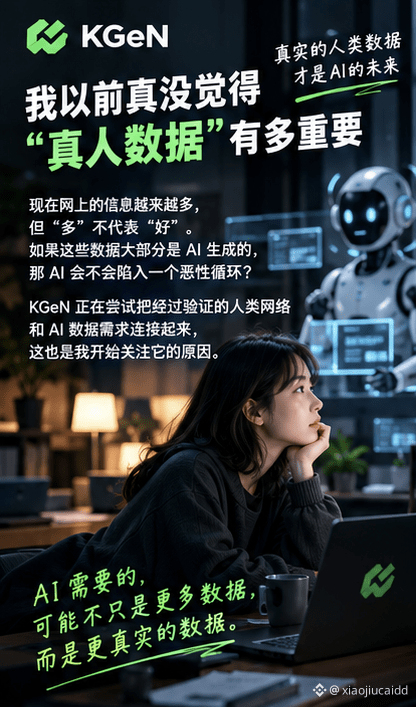
Раньше я вообще не думал, что «живые данные» так уж важны.
Когда я раньше видел проекты на базе ИИ, где говорили про данные, я в основном просто пробегал взглядом.
Объём данных, размер модели, с кем сотрудничали… в целом со временем всё казалось одинаковым.
Но недавно, посмотрев на KGeN, я внезапно заинтересовался очень простым вопросом:
Если в будущем тренировочные данные для ИИ будет всё больше генерировать сама ИИ, то кто сможет доказать, что изначально эти данные действительно были созданы людьми?
Это, на мой взгляд, довольно интересно.
Сейчас в интернете информации становится всё больше, но «больше» не означает «лучше».
Статья может быть написана ИИ, изображение — сгенерировано ИИ, а комментарий — тоже может быть массово сгенерирован ботами.
Если всё это дальше использовать для обучения следующего поколения ИИ, то в конце концов может возникнуть довольно странный цикл:
ИИ генерирует данные → ИИ учится → снова генерирует больше данных → снова обучает ИИ.
Данных становится всё больше, но реальные человеческие переживания и опыт — наоборот, становятся всё более редкими.
Именно поэтому я в последнее время начал присматриваться к KGeN.
Направление KGeN — это не просто очередная «платформа данных», а связующее звено между верифицированными человеческими сетями и потребностями ИИ в данных.
Официально сейчас акцент делается на такие направления, как Verified Human, а также мультимодальные данные Sound / Sight / Motion / Touch, плюс Physical AI и LLM.
Мне кажется, по-настоящему интересная часть этого направления — вовсе не слова «ИИ».
А вот что:
Когда ИИ станет всё больше, не превратятся ли живые люди сами по себе в дефицитный ресурс?
Я думаю, за этим вопросом стоит дальше наблюдать в контексте KGeN.
#KGEN
Когда я раньше видел проекты на базе ИИ, где говорили про данные, я в основном просто пробегал взглядом.
Объём данных, размер модели, с кем сотрудничали… в целом со временем всё казалось одинаковым.
Но недавно, посмотрев на KGeN, я внезапно заинтересовался очень простым вопросом:
Если в будущем тренировочные данные для ИИ будет всё больше генерировать сама ИИ, то кто сможет доказать, что изначально эти данные действительно были созданы людьми?
Это, на мой взгляд, довольно интересно.
Сейчас в интернете информации становится всё больше, но «больше» не означает «лучше».
Статья может быть написана ИИ, изображение — сгенерировано ИИ, а комментарий — тоже может быть массово сгенерирован ботами.
Если всё это дальше использовать для обучения следующего поколения ИИ, то в конце концов может возникнуть довольно странный цикл:
ИИ генерирует данные → ИИ учится → снова генерирует больше данных → снова обучает ИИ.
Данных становится всё больше, но реальные человеческие переживания и опыт — наоборот, становятся всё более редкими.
Именно поэтому я в последнее время начал присматриваться к KGeN.
Направление KGeN — это не просто очередная «платформа данных», а связующее звено между верифицированными человеческими сетями и потребностями ИИ в данных.
Официально сейчас акцент делается на такие направления, как Verified Human, а также мультимодальные данные Sound / Sight / Motion / Touch, плюс Physical AI и LLM.
Мне кажется, по-настоящему интересная часть этого направления — вовсе не слова «ИИ».
А вот что:
Когда ИИ станет всё больше, не превратятся ли живые люди сами по себе в дефицитный ресурс?
Я думаю, за этим вопросом стоит дальше наблюдать в контексте KGeN.
#KGEN