$ETH Виталик: Дизайн противодействующих механизмов может быть ключом к безопасности ИИ
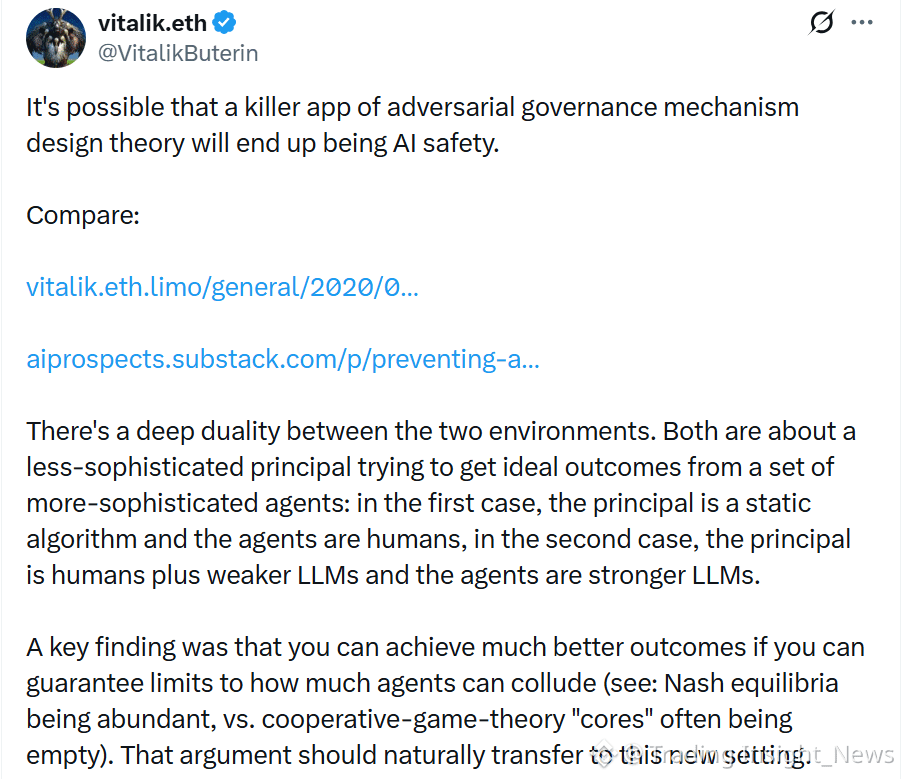
Виталик Бутерин только что провёл заметное сравнение: теория дизайна противодействующих механизмов, хорошо знакомая в криптографии, может оказаться важным применением для безопасности ИИ.
Обе области имеют глубокую бинарную структуру между принципалом и агентом:
В криптографии: принципал — это статический алгоритм (слабые возможности), агент — человек (более сильные возможности).
В ИИ: принципал — это человек и более слабая LLM, агент — более сильная LLM.
Сопутствующие исследования показывают, что если вы можете ограничить уровень сговора между агентами, вы можете добиться лучших результатов. Этот вывод может напрямую относиться к безопасности ИИ.
Это одна из самых интересных идей, которыми Виталик поделился в последнее время. Ключевая проблема безопасности ИИ такова: как люди могут управлять системой, которая умнее их?
Ответ, который криптография выучила за годы: не управляйте, доверяя — управляйте с помощью дизайна механизмов. Противодействующие механизмы, где у сторон расходящиеся стимулы и они проверяют друг друга, доказали свою эффективность в протоколах блокчейна.
Применение этой логики к ИИ — свежий подход. Вместо того чтобы пытаться «обучить» ИИ быть хорошим, мы могли бы проектировать среды, где ИИ-агенты проверяют и сдерживают друг друга.
Как вы думаете, могут ли противодействующие механизмы быть реальным решением для безопасности ИИ или же это просто теоретический подход?
Новость приведена для справки, а не как инвестиционная рекомендация. Пожалуйста, внимательно прочитайте перед тем, как принять решение.
Виталик Бутерин только что провёл заметное сравнение: теория дизайна противодействующих механизмов, хорошо знакомая в криптографии, может оказаться важным применением для безопасности ИИ.
Обе области имеют глубокую бинарную структуру между принципалом и агентом:
В криптографии: принципал — это статический алгоритм (слабые возможности), агент — человек (более сильные возможности).
В ИИ: принципал — это человек и более слабая LLM, агент — более сильная LLM.
Сопутствующие исследования показывают, что если вы можете ограничить уровень сговора между агентами, вы можете добиться лучших результатов. Этот вывод может напрямую относиться к безопасности ИИ.
Это одна из самых интересных идей, которыми Виталик поделился в последнее время. Ключевая проблема безопасности ИИ такова: как люди могут управлять системой, которая умнее их?
Ответ, который криптография выучила за годы: не управляйте, доверяя — управляйте с помощью дизайна механизмов. Противодействующие механизмы, где у сторон расходящиеся стимулы и они проверяют друг друга, доказали свою эффективность в протоколах блокчейна.
Применение этой логики к ИИ — свежий подход. Вместо того чтобы пытаться «обучить» ИИ быть хорошим, мы могли бы проектировать среды, где ИИ-агенты проверяют и сдерживают друг друга.
Как вы думаете, могут ли противодействующие механизмы быть реальным решением для безопасности ИИ или же это просто теоретический подход?
Новость приведена для справки, а не как инвестиционная рекомендация. Пожалуйста, внимательно прочитайте перед тем, как принять решение.