


Оригинальное название: (Юридический ИИ-единорог с оценкой в 11 миллиардов долларов, в который инвестировал OpenAI, начинает «обворачивать» китайские open source-модели)
Оригинальный автор: Движение Beating
20 августа компания Harvey, занимающаяся правовым ИИ и в которую инвестировал OpenAI, выпустила Tenet. Оценка этой компании, основанной в 2022 году, сейчас составляет 11 миллиардов долларов — это юридическая ИИ-компания с самой высокой оценкой в мире. Она обслуживает тысячи организаций; в списке акционеров также значатся Sequoia, a16z и GIC.
Tenet — это ее первая собственная модель; в качестве базовой основы используется Kimi K3 с открытыми в июле весами с «Тёмной стороны Луны». В настоящее время Tenet все еще находится на стадии исследовательского превью, и Harvey планирует постепенно внедрять в продукт проверенные возможности из него.
Основатель Harvey — Winston Weinberg — изначально был юристом по судебным спорам в O'Melveny & Myers, а Gabe Pereyra занимался исследованиями больших моделей в Google Brain и Meta. OpenAI довольно рано инвестировал в проект; после этого они также вместе обучили набор моделей по кейс-методу: около 10 млрд token данных по американским судебным прецедентам включили в обучение. В опубликованных OpenAI клиентских кейсах Pereyra сказал, что Harvey оценивал разные варианты, и в итоге доверял только тому решению, которое они вместе завершат как кастомное обучение.
В последние годы почти постоянно это была модель с закрытым исходным кодом — самый типичный «клиент» в сфере профессиональных сервисов — и она также могла вызывать одну из самых сильных групп закрытых моделей по всему миру. Но когда она впервые решила действительно «вписать» свои юридические задачи, критерии оценивания юристов и вычислительные мощности за два месяца в один набор весов, выбранным базовым слоем оказался открыто-весовой модель из Китая.
После публикации модели отрасль очень быстро узнает две вещи: насколько она умна и сколько продаются эти возможности. В течение нескольких часов обновляются бенчмарки, меняются позиции в Arena, и начинают распространяться различные диаграммы координат между интеллектом и ценой. Модель, обученная несколько месяцев и потребившая много вычислительных мощностей, в итоге превращается на графике лишь в точку.
Для большинства разработчиков этот подход по-прежнему работает. Предпосылка здесь в том, что когда модель передается пользователю, ее способности уже в основном сформированы. Когда доминируют закрытые API, это условие выполняется. Модельные компании делают предобучение и дообучение, а затем упаковывают способности в интерфейс. Пользовательские компании могут менять подсказки, делать поиск и собирать агентов, но изменить саму модель дальше обычно трудно.
Открытые веса разрушают это предположение. После того как предприятие получает веса, оно может продолжить подгружать в обучение свои данные и экспертные фидбеки, «принеся» в тренировку реальные задачи и стандарты оценки. Два модели, которые при публикации набрали по 90 баллов, затем при дальнейшем дообучении на той же порции данных и вычислительных мощностей: одна в итоге останавливается на 91, а другая может дойти до 97. Для компаний, которые планируют вложить несколько месяцев времени, вычислительных ресурсов и экспертных ресурсов, разница между «те же 90 при публикации» — это пропасть.
Но у этого есть предпосылка. Компания готова поставить на это несколько месяцев времени и партию вычислительных ресурсов для продолжения дообучения. И, прежде всего, ей нужна такая версия весов, которую вообще стоит дообучать. В последние годы между открытыми моделями и самыми передовыми закрытыми моделями всегда существовала дистанция. В сценариях общих ответов и повседневного написания кода разрыв был не слишком большим; однако когда вы входите в профессиональные сценарии с высокой стоимостью ошибок, этот разрыв раздувается. Право — как раз одна из тех сфер, где требования максимальные. Раньше те компании, которым удавалось по-настоящему зайти в основную бизнес-линию уровня Harvey, обычно выбирали одни из самых сильных в то время закрытых моделей. Открытые веса, конечно, легче контролировать и модифицировать, но если даже базовые профессиональные задачи не удается выполнить, то говорить о пространствах для дальнейшего обучения уже не приходится.
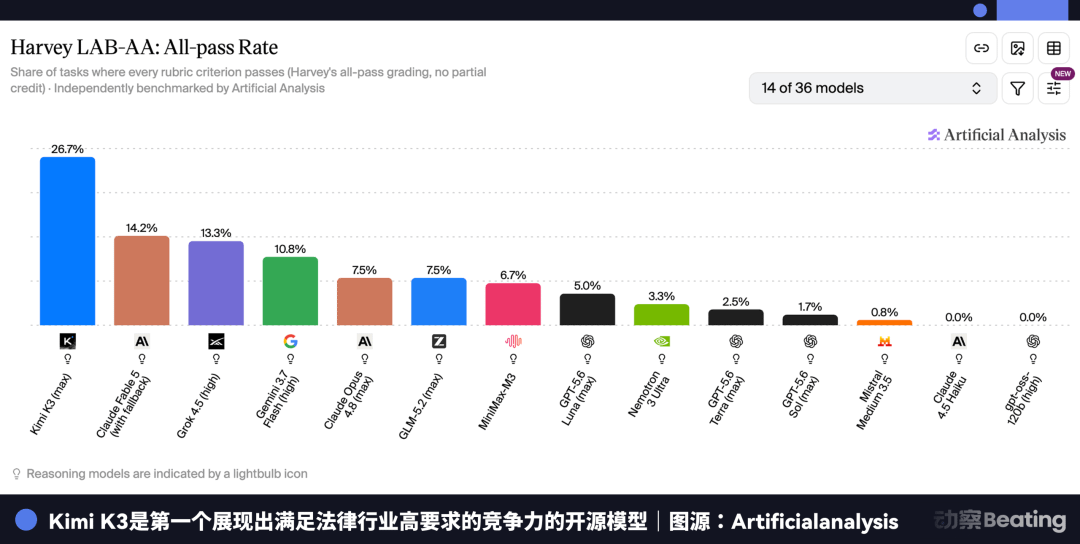
Kimi K3 впервые перешагнул тот долговременный порог, который существовал для подобных вещей. Его суммарное число параметров — 2,8 триллиона; он поддерживает контекст до 1 млн token и уже обладает достаточно хорошими базовыми возможностями для долгосрочных задач, использования инструментов и сложных рассуждений. Для Harvey открытые весовые модели впервые перестали быть просто более дешевым и с большим контролем запасным вариантом — они вошли в пространство, где их можно серьезно оценивать вместе с передовыми моделями.
И тогда они начали интересоваться вопросом, который раньше редко отдельно выносили на обсуждение: насколько легко эти веса можно продолжать дообучать.
Cursor, когда обучал Composer 2, не выбирал модели по стандартным рейтингам программных агентов. Его суждение было таким: возможности агента и способность решать долгосрочные задачи сильно меняются в процессе обучения с подкреплением, и ранжирование до старта обучения не обязательно предскажет итоговый результат. Вместо баллов из бенчмарков Cursor больше всего ценит знания модели в программировании, способность отслеживать состояние и степень «запутанности» на внутреннем кодовом репозитории, а также эффективность работы модели в своей собственной инфраструктуре. В итоге выбранным базовым слоем стал Kimi K2.5.
У Cognition за Devin — такое же мнение. После открытия весов K3 он быстро подключил модель к Devin Desktop и CLI; на своей FrontierCode 1.1 Extended K3 набирал 58,2% и имел 63,6% проходных результатов. Этот тест проверяет реальные инженерные задачи: можно ли в итоге включить код в основную ветку и достаточное ли качество — все учитывается. Cognition также отмечала, что K3 особенно хорошо показывает себя при воспроизведении багов и управлении своей средой выполнения — а именно это в долгосрочных задачах программирования чаще всего «дает сбой». Затем Cognition также сделала на этих весах последующее дообучение.
По-настоящему дефицитными являются не юридические данные
Рост Harvey очень быстрый. В марте этого года он обслуживал около 1300 организаций и более 100 тысяч юристов; спустя пять месяцев число клиентов выросло почти вдвое, охватив 70 стран. В AmLaw 100 более трех четвертей юридических фирм используют Harvey.
Суммы в проектах юридических услуг большие, а терпимость к ошибкам — очень низкая. Отчет по due diligence при M&A может потребовать найти пункты о смене контроля из сотен и тысяч документов, определить, срабатывает ли транзакция, затем выявить риски и привести обоснование в виде первоисточника. Между тем часто нужно, чтобы десятки суждений подряд оставались верными; если упустить даже одну проблему, реально влияющую на сделку, большая часть работы, сделанной правильно раньше, теряет смысл.
По мере того как юридических фирм, пользующихся сервисом, становится все больше, Harvey накопил тип данных, который базовой модели-компании трудно получить самостоятельно. Он знает, как юрист будет раскладывать работу, и знает, где партнер в итоге будет искать ошибки.
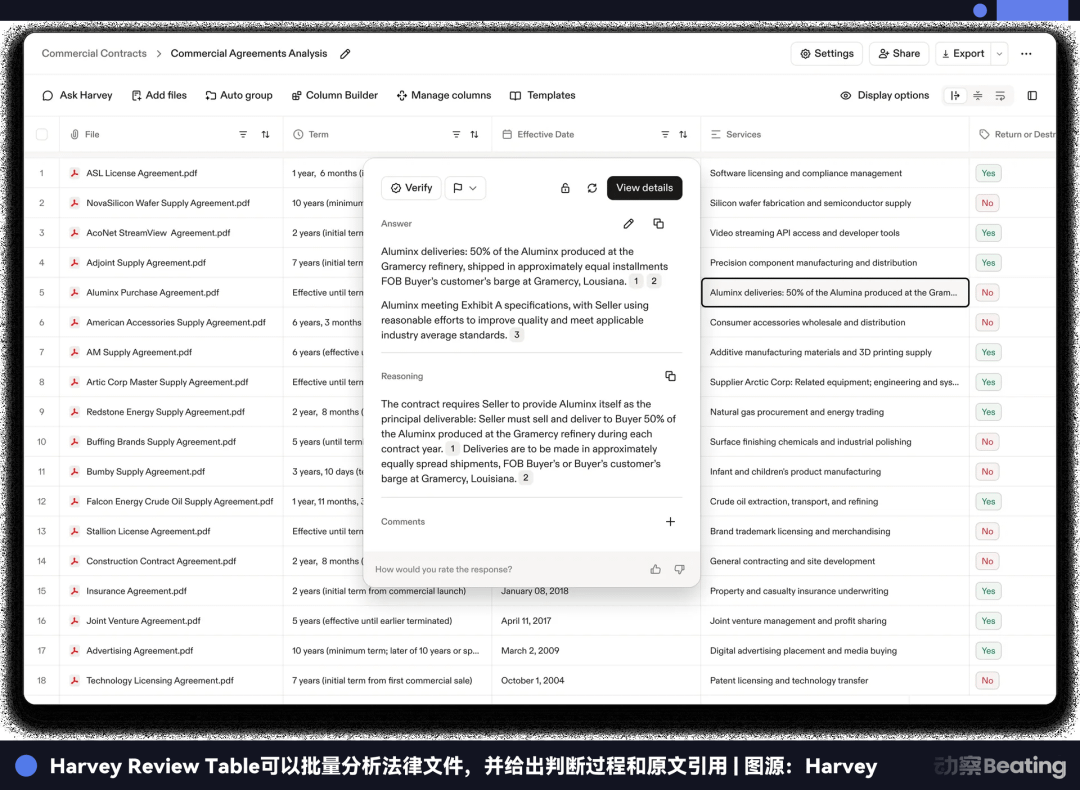
Эти практики позже превратили в Legal Agent Benchmark. Там уже есть более 1200 долгосрочных юридических задач, покрывающих 24 области адвокатской практики. В среднем описание каждой задачи — всего около 50 слов, после чего модель попадает в закрытую среду работы с клиентским делом. Соответствующие документы и большое количество нерелевантных материалов смешаны вместе: ей нужно самому искать, читать, оценивать и в итоге выдать рабочий результат, который можно проверять по пунктам.
В среднем по каждой задаче есть около 50 критериев оценки, а для сложных задач — до нескольких сотен. Есть ли все факты, можно ли обосновать вывод, корректны ли цитаты исходному тексту, разумны ли уровень риска и рекомендации — все это разбивается на оценочные пункты, которые можно определять отдельно. Одна задача может длиться дольше 1000 раундов, расходуя десятки тысяч token.
Через несколько лет работы молодые юристы постепенно понимают, о чем на самом деле переживает клиент, и запоминают, какие на первый взгляд незначительные положения нельзя упустить. Эти практики раньше было трудно полностью записать в учебники; в основном они остаются в правках партнеров, в рабочих привычках внутри команды и в документах, которые уже были переданы клиентам.
Тогда он разбил часть этого на задачи, материалы и критерии оценки. Процесс, в котором модель каждый раз выполняет работу, становится набором обратной связи, которую можно считать и сравнивать.
Подсказки и поиск подсказывают модели, куда идти; критерии оценки начинают отвечать на другой вопрос: насколько юридическая работа в действительности считается выполненной. То, что Harvey действительно накопил за последние годы, — это не только клиенты и юридические данные, но и профессиональная система оценивания, которую можно непосредственно использовать для обучения модели.
Вписать юридический опыт в веса
Те задачи и критерии оценки начинают реально попадать в обучение. Данные берутся из открытых юридических материалов, синтетических данных и данных от экспертов-людей. Практикующие юристы участвуют в конструировании задач, оценивании и в проверке синтетических данных. В общей сложности Harvey подготовил около 1750 юридических сред для задач юридических агентов.
Когда модель попадает в рабочее пространство с материалами и инструментами, ей нужно самой читать документы, вызывать инструменты и сдавать результат. Затем система проверяет всю траекторию работы по стандартам, заданным юристами: сколько конкретных требований выполнено и насколько решена юридическая проблема. Если все ключевые требования пройдены, она получает еще и дополнительное вознаграждение.
Каждый цикл обучения порождает более 10 тысяч траекторий задач. Harvey использует стратегию последовательностей групп (GSPO): то есть на одном и том же задании модель генерирует несколько подходов, а затем по различиям качества между результатами обновляются веса. Если оценки двух траекторий слишком близки, система еще раз пересчитывает оценки, чтобы снизить влияние шума в оценивании на обучение.
Весь процесс занимает около двух месяцев и использует примерно 150 карт NVIDIA B300. Предобучить передовую модель обычно требует десятки тысяч GPU-карт; вычислительные ресурсы, вложенные Harvey, — это еще один порядок величины. Harvey использует rank-64 LoRA: покрывает attention-слои Kimi K3, feed-forward сети и веса маршрутизирующих экспертов, в общей сложности затрагивая около 500 тысяч экспертных тензоров.
Длиннотраекторное обучение сталкивается еще с одной инженерной проблемой. Одна юридическая задача может длиться сотни раундов, и пока модель генерирует траектории задач, веса на стороне обучения уже обновляются. Когда тренажер возвращается и пересчитывает эту траекторию, если состояния моделей не совпадают с обеих сторон, то вероятность, соответствующая каждому шагу в тот момент, тоже изменится — и вознаграждение будет сложно точно «пришить» к исходным решениям.
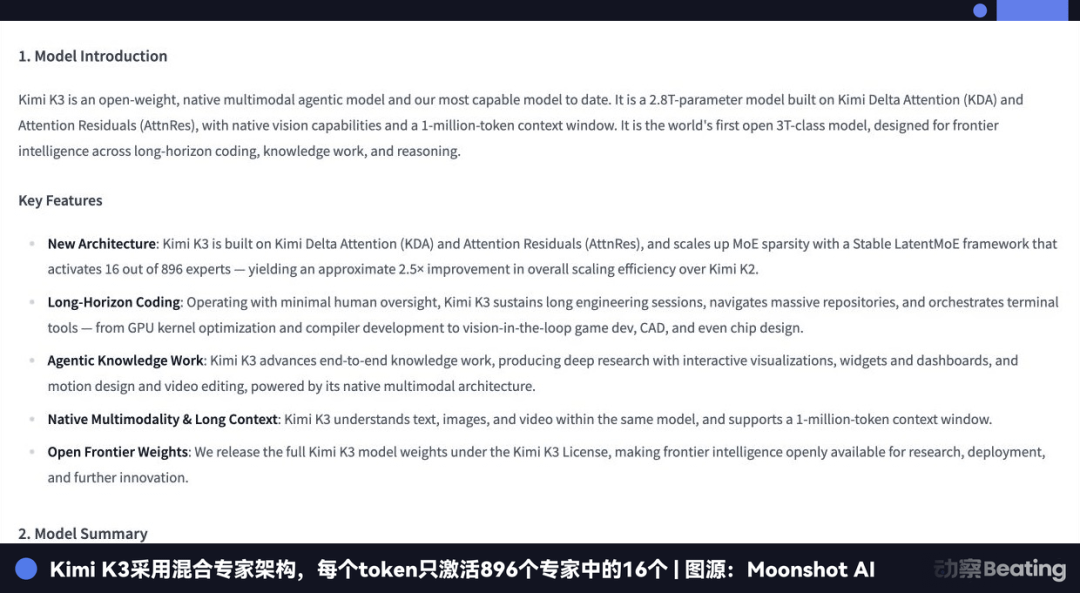
Смешанно-экспертная (MoE) архитектура Kimi K3 делает вопрос еще более сложным. Каждый token, попадая в модель, маршрутизатор выбирает 16 экспертов из 896 для участия в вычислениях. На стороне обучения и на стороне исполнения достаточно даже небольших различий в численной точности и способе батчинга — один и тот же token может быть отдан разным экспертам, и исходную траекторию тогда трудно полностью воспроизвести.
Поэтому Harvey и его поставщик сделали числовую синхронизацию тренажера и исполняющей среды на уровне ядра. После каждой очередной полной обновляющей итерации веса сразу hot-load подгружаются в среду исполнения, не нужно повторно останавливать генерацию задач. Система также записывает результаты экспертной маршрутизации, соответствующие token, чтобы при пересчете тренажером можно было как можно ближе вернуться на тот путь, который модель прошла при генерации этой траектории.
На этом этапе Tenet уже меньше похож на обычный fine-tuning, где просто добавляют юридический корпус в модель. Harvey построил процесс обучения, который можно многократно запускать. Юридические задачи постоянно поступают в среду, модель выполняет работу, юристы оценивают всю траекторию по заданным стандартам, затем веса обновляются, и новая модель снова возвращается в среду для следующей итерации задач.
Можно ли стабильно продолжать дообучение Kimi K3 — это тоже проверяется в таких циклах на практике.
После обучения это стало больше похоже на юридического агента
То, что Harvey действительно хочет улучшить, — это способность модели выполнять долгосрочные юридические работы. Он применяет очень строгий критерий all-pass: ключевые критерии оценки внутри одной задачи должны быть пройдены все. Согласно внутренним результатам, опубликованным Harvey, на сохраненном наборе LAB, не участвовавшем в обучении, Tenet полностью выполняет почти вдвое больше задач, чем исходный Kimi K3; доля all-pass выросла примерно с 11% до 19,7%, то есть добавилось около 9 процентных пунктов.
В специализированных LAB Contracts, где тестируют составление, проверку и переговоры по договорам: число выполненных задач выросло примерно на 20%, а доля all-pass достигла 11,3%, то есть примерно на 2 процентных пункта больше. По собственному рейтингу Harvey Tenet занял первое место в LAB Contracts и второе место среди полного набора LAB.
Затем он поместил Tenet в еще две внешние системы тестирования: APEX Agents Corporate Law от Mercor и Redline Bench от Crosby. Первый тест моделирует долгосрочные профессиональные задачи в рабочей среде; второй требует, чтобы модель непрерывно вносила правки в договор и затем оценивалась по стандартам, разработанным юристами.
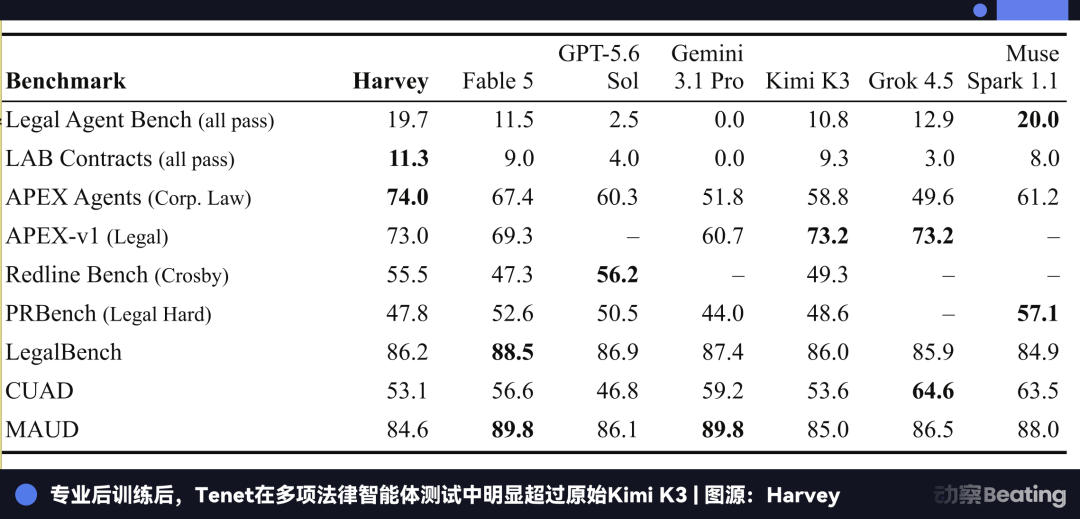
Tenet не сталкивался с обучающими данными этих двух тестов, но результаты все равно заметно выше, чем у исходного Kimi K3. Это означает, что способность, «натренированная» в среде задач Harvey, переносится на новые юридические задачи.
Но другая проблема в том, что профессиональное дообучение часто делает модель все более умелой в одной категории задач, одновременно заставляя ее терять часть исходных знаний и способности к рассуждению.
На LegalBench, CUAD и MAUD у Tenet не наблюдалось заметного отката. В сложных подзадачах Scale Professional Reasoning Benchmark балл даже немного вырос — с 36,0% до 36,8%. По крайней мере, судя по этой группе результатов, после усиления Kimi K3 в юридических задачах проблемы «забывания способностей» не проявились.
Модель вознаграждений Harvey будет смещать в сторону более коротких траекторий, когда качество результатов оказывается близким: поскольку юридический агент читает еще один файл или вызывает еще один инструмент, это увеличивает расход token и время ожидания. После обучения Tenet сокращает часть неэффективных шагов; при росте качества задачи стоимость выполнения в целом остается примерно стабильной.
На этот раз то, что изменилось больше всего, — это то, как Kimi K3 обрабатывает сложные юридические работы. Он лучше планирует шаги, вызывает инструменты и реже упускает ключевые требования в задаче.
Harvey начал применять стратегию с несколькими моделями еще в 2025 году, и в этом году она продолжается: компания продолжает подключать новые модели OpenAI и Anthropic. Tenet наконец добавил в этой системе впервые набор открытых весов, обученный и контролируемый самим Harvey.
Ему нужна такая базовая модель, которая сама по себе уже «на высоте». Юридические задачи Harvey могут обрабатывать огромные объемы документов, выполнять сотни и даже тысячи раундов подряд, и модели нужно поддерживать состояние в течение всей долгой работы. Дообучение может продолжать формировать то, как она решает юридические задачи, но трудно с нуля добавить набор способностей, которых базовая модель изначально не имела.
Еще одно условие — контроль. Harvey может через API вызывать GPT и Claude, но не может продолжить «вписывать» 1750 юридических сред задач и критерии оценки юристов в эти закрытые модели. Открытые веса дают возможность самим решать, как обучать и как проектировать вознаграждения, а также сохранять профессиональные способности, полученные после обучения, в собственных контролируемых весах.
Но даже получив веса, нужно проверить, подходит ли эта модель для дальнейшего дообучения. Можно ли стабильно прогонять обучение на длинных траекториях с подкреплением, точно ли воспроизводится маршрутизация смесью экспертов, не потеряются ли исходные знания после улучшения профессиональных навыков, можно ли удержать стоимость рассуждений в пределах, пригодных для продакшена — все это нужно действительно попробовать, чтобы узнать.
После того как Tenet отработал два месяца, Kimi K3 выдал ответы для этой итерации. Процесс обучения стабильно запускался, способность решать юридические задачи заметно выросла, признаков значимого «забывания» способностей не наблюдалось, и стоимость не вышла из-под контроля вместе с эффектом.
Для Harvey эти результаты важнее самого «наличия открытых весов». Весами можно скачать — это лишь означает, что у компании есть право продолжать обучение. Насколько способностей останется после обучения — именно это определяет, стоит ли вкладываться в дальнейшие вычислительные мощности, данные и время экспертов.
Еще один бизнес модели-компании
Харви сказал, что его цель — дать юридическим фирмам возможность обучать на открытых весах свои собственные проприетарные модели и иметь способности, сформированные после обучения. То, что передает Tenet, — не столько набор моделей, сколько набор подходов.
Раньше бизнес компаний базовых моделей в основном происходил через вызовы после публикации модели. Открытые веса принесли другой тип отношений: компания может взять готовую базовую модель и продолжить дообучение, «сохраняя» в весах свои знания отрасли, и в итоге получить набор моделей, ближе всего соответствующий ее собственному бизнесу.
Раньше подобные потребности было сложно превратить в настоящий рынок. Когда общие возможности модели недостаточно сильны, вертикальные компании, даже получив веса, не могут просто за счет дообучения восполнить долгосрочное рассуждение, вызовы инструментов и обработку сложных задач. Обучать же с нуля слишком дорого, и большинству компаний это просто не нужно.
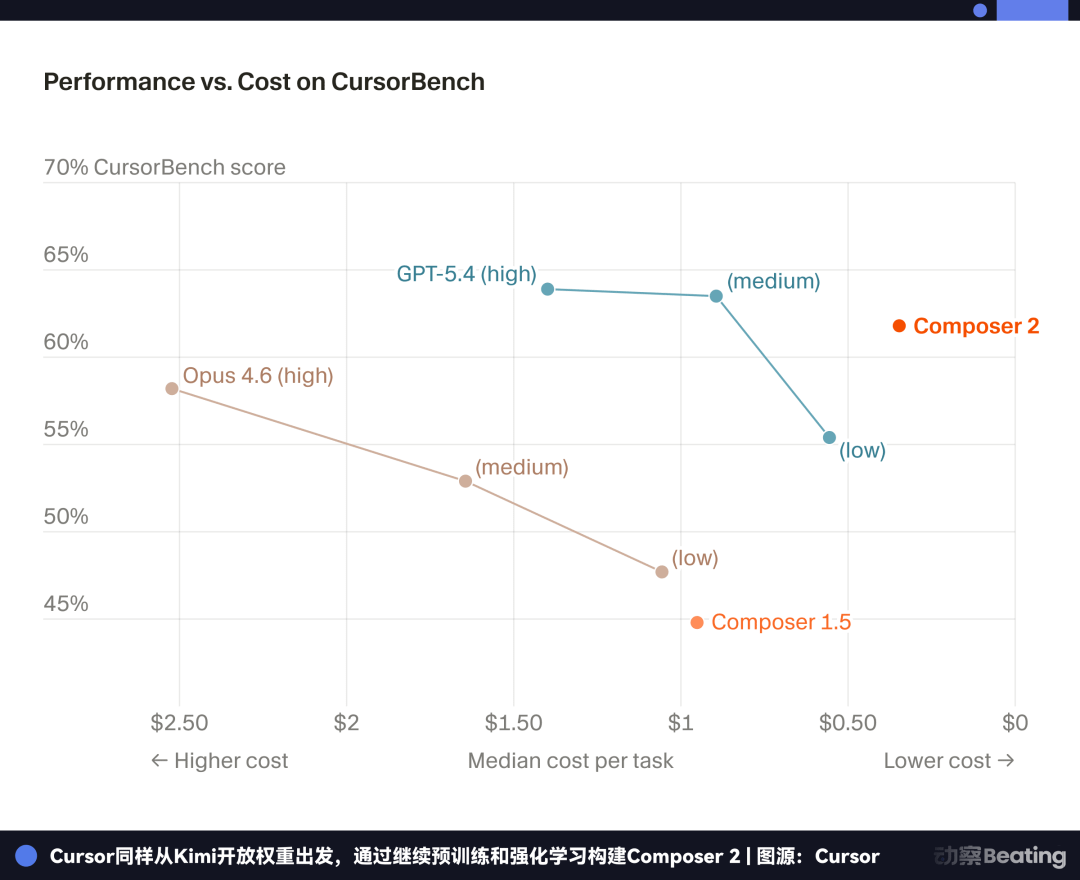
Cursor обучил в программировании Composer 2, а Cognition продолжил дообучение на той же паре весов модели, которую использовал Devin; затем Harvey сделал Tenet в праве. Хотя программирование и право далеки друг от друга, все равно выбрали исходить из общих способностей, уже обученных Kimi, и затем добавили внутрь свои самые знакомые профессиональные виды работ.
Tenet также делает этот вопрос более конкретным. За два месяца, примерно на 150 карточек, плюс набор критериев оценки, определяемых практикующими юристами, одна компания может довести общие веса до уровня передовых в своей отрасли. Порог по вычислительным мощностям уже снизился на порядок; более трудная часть начинает смещаться в другую сторону — и остается открытым, сможет ли кто-то четко объяснить, до какой степени профессиональная работа считается выполненной.
Разработка ПО и право — это всего лишь два уже существующих примера. У финансов, консалтинга, фармацевтики, бухгалтерии и множества других профессиональных сервисных отраслей есть свои данные, рабочие процессы и экспертные суждения. Эти отрасли сами по себе представляют рынок знаний и интеллектуального труда размером в триллионы долларов. Самые топовые компании могут и не заниматься самостоятельной дообучающей предтренировкой базовых моделей, но у них все больше возможностей продолжать дообучение на собственной модели поверх уже зрелых весов.
Если эта траектория продолжит работать, рынок для Kimi будет уже не просто ограничиваться тем, сколько людей его используют. Дальше гораздо более стоит следить за тем, сколько компаний после Harvey, Cursor и Devin выберут обучение своих моделей поверх Kimi.
Ссылка на исходный текст