


Оригинальное название: (DeepSeek выпустила модель визуального понимания, а «Большой голубой кит» и другие опоздавшие глаза наконец дождались)
Оригинальный автор: Движение Beating
21 августа 2026 года DeepSeek представила совершенно новую модель визуального понимания deepseek-v4-flash-vision-exp, а мульти модальный API официально открыт. Впервые разработчики могут напрямую отправлять изображения в официальный интерфейс DeepSeek.
Модель сохраняет контекст V4 Flash на 1 миллион токенов и максимальный вывод 384 тысячи токенов, поддерживает JSON Output, Tool Calls и Responses API, а также совместима с интерфейсом Anthropic API.
Стоимость также полностью сохранена как у V4 Flash. За 1 миллион токенов на входе при отсутствии попаданий в кэш в пиковое время — 3 юаня, в непиковое — 1,5 юаня; при попадании в кэш — соответственно 0,1 юаня и 0,05 юаня. За вывод в пиковое время — 9 юаней, в непиковое — 4,5 юаня. В Пекине с 9:00 до 12:00 и с 14:00 до 18:00 каждый день считается пиковым временем, остальные 17 часов — по льготной цене в полцены.
Картинки тоже тарифицируются по токенам. Перед входом в модель каждая картинка автоматически масштабируется в зависимости от размера: всё, что меньше примерно 384×384 пикселей, увеличивается, а большие — сжимаются до примерно 800×800 пикселей по общему количеству пикселей. Одна картинка максимум занимает 384 токена. И картинка 2000×2000, и картинка 5000×5000 в итоге могут потратить ровно одинаковое число токенов.
С учётом лимита 384 токена: в пиковые часы стоимость входных данных для изображения, когда кэш не попадался, составляет примерно 0.001152 юаня. Обработка тысячи таких изображений: стоимость самого входа с изображениями — всего около 1.152 юаня; за текст и выход модели считается отдельно.
Вместе с этим запустили ещё и Files API. Разработчики могут заранее загрузить изображения, а затем подставлять file_id в запрос. Одну и ту же картинку нужно отправить только один раз — дальше её можно многократно ссылаться в разных запросах. В одном запросе дополнительно можно положить максимум 600 изображений.
Этот API сам по себе не платный. Один файл — максимум 64 МиБ, на пользователя — до 25 ГиБ и 10 000 файлов. Файл можно настроить на срок действия от 1 часа до 30 дней; если срок действия не задан, файл можно хранить сколько угодно. Сейчас у официальной стороны также нет интерфейса для загрузки содержимого файлов. Разработчики могут загружать, запрашивать и удалять, а модель может их читать. Это скорее бесплатный фотоархив, подготовленный именно для инференса, а не обычное облачное хранилище.
Но странного на самом деле не то, что DeepSeek начинает смотреть на картинки только сегодня.
Одна временная линия
Если смотреть только на исследования, визуальная часть DeepSeek не запоздала.
Если смотреть только на продукт и API, то да — она действительно запоздала надолго.
11 марта 2024 года DeepSeek-VL сделали открытым.
Есть две версии — 1.3B и 7B. Они умеют видеть естественные изображения, веб-страницы, формулы, диаграммы и документы. К октябрю появился Janus: понимание и генерацию изображений поместили в одну и ту же автОрегрессионную рамку. 13 ноября вышел JanusFlow. В декабре DeepSeek-VL2: поменяли на архитектуру смеси экспертов, общее число параметров разбили на три категории — 3B, 16B и 27B.
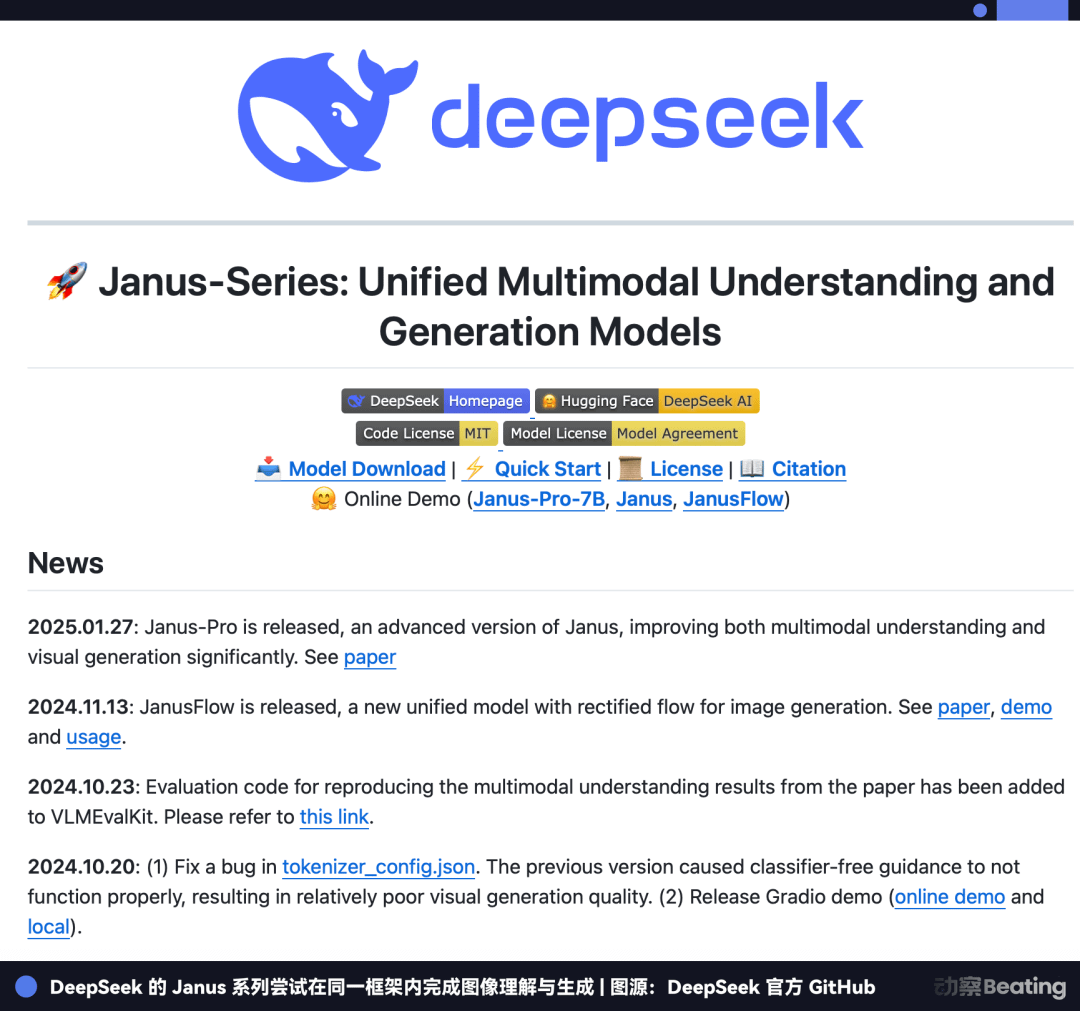
В ночь на 28 января 2025 года, накануне Праздника Весны, Janus-Pro открыли с исходниками. Официальный репозиторий указал дату по UTC — 27 января.
Версия 7B в задаче GenEval по созданию изображений по текстовым инструкциям набирает 0.80 и превосходит 0.67 у DALL-E 3, указанных в статье. У неё есть открытые веса — можно развернуть локально — и также есть публичная демо-версия.
DeepSeek не подключила это к своему облачному API.
Ещё за неделю до этого R1 вывела DeepSeek на сцену и в фокус внимания. Janus остался на GitHub и Hugging Face. Для подавляющего большинства обычных пользователей он вскоре снова исчез из поля зрения.
20 октября 2025 года DeepSeek-OCR открыли с исходниками — сжатие длинных документов с помощью визуальных токенов. 27 января 2026 года вышла OCR 2.
Начинать считать можно с DeepSeek-VL: за два года хотя бы по семи публичным записям можно отследить DeepSeek-VL, Janus, JanusFlow, VL2, Janus-Pro, OCR и OCR 2.
Визуальные исследования всё время велись и всё время выносились наружу.
Просто обычные разработчики всё время не получали тот самый вход.
А с другой стороны, к марту 2024 года интерфейсы разработчика у нескольких ключевых конкурентов уже могли принимать изображения. OpenAI в ноябре 2023 года открыла GPT-4 Turbo with Vision — изображения можно напрямую передавать в Chat Completions API; спустя месяц Google запустил Gemini Pro Vision API; в марте 2024 года Claude 3 во всей линейке добавил визуальные возможности.
25 апреля 2025 года Ли Яньхун на конференции Baidu Create сказал: «DeepSeek тоже не всемогущ». В перечне проблем, который он привёл, как раз было упомянуто и то, что модальность одна.
Его оценка такова: мультимодальность станет стандартной комплектацией базовых моделей, а рынок чисто текстовых моделей будет всё меньше.
Тогда DeepSeek уже год занималась визуальными исследованиями.
на рассвете
7–8 апреля 2026 года часть пользователей открыла DeepSeek, и в интерфейсе внезапно появились три новых входа.
«Быстро» «экспертно» «визуально».
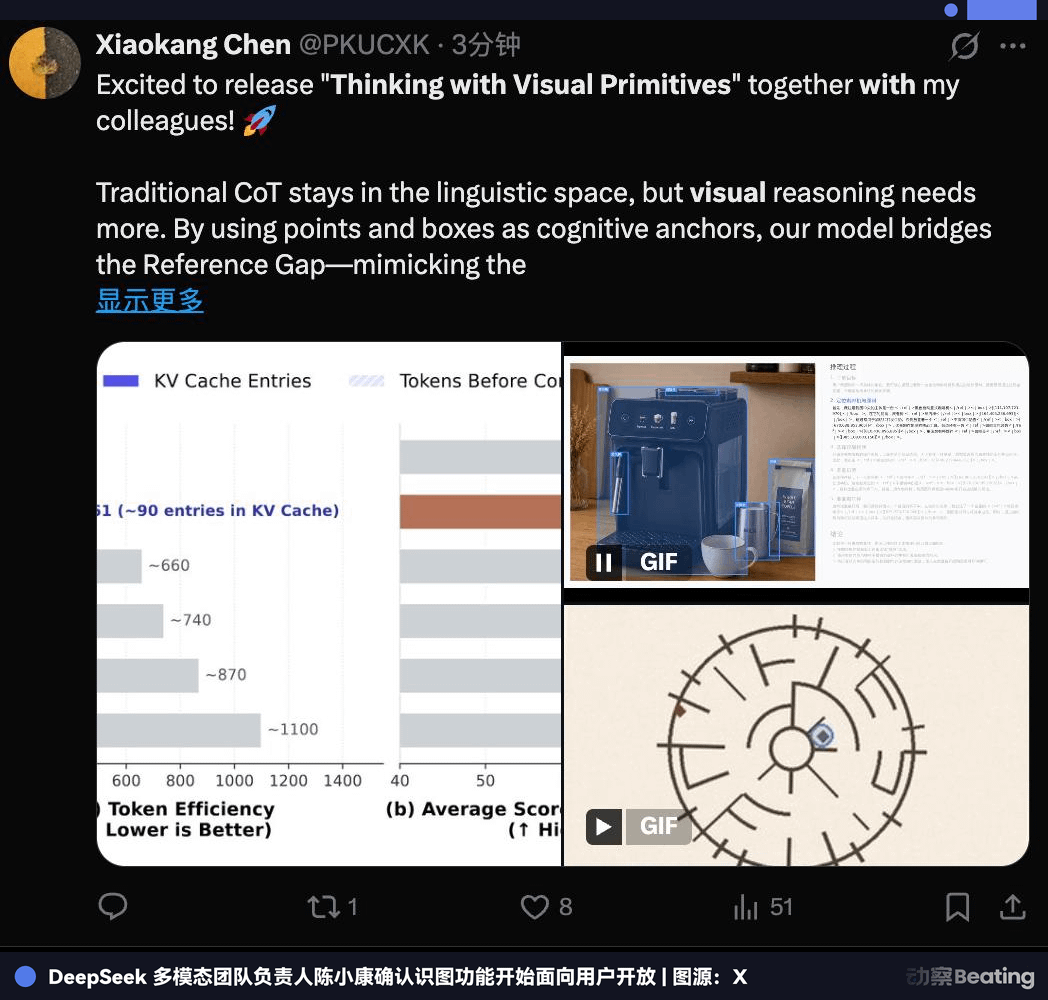
29 апреля руководитель мультимодальной команды DeepSeek Чэнь Сяокан подтвердил, что функция распознавания изображений начинает проходить серую фазу для части пользователей. Затем один из старших исследователей DeepSeek написал: «Китёнок уже видит». South China Morning Post прямо вынес эту фразу в заголовок.
Глаза DeepSeek впервые по-настоящему выглянули наружу из продуктового интерфейса.
На следующий день DeepSeek выложил (Thinking with Visual Primitives) на GitHub. Через несколько часов репозиторий и статья убрали. К 1 мая по исходному адресу уже было 404. DeepSeek не объяснила, в интернете остались только зеркала статьи и пересказы СМИ.
В статье исследуется очень конкретная проблема.
После того как модель видит очень загруженную картинку, она часто понимает, о чём говорит, но не может чётко сказать, о каком именно человеке или какой именно линии идёт речь. Команда вставила координаты точек и bounding box прямо в процесс рассуждения: модель указывает положение — и продолжает думать дальше.
Изображение 756×756 сначала проходит через визуальный энкодер, превращается в 2916 визуальных токенов-«плиток», затем с помощью пространственного сжатия 3×3 превращается в 324 токена. Разреженное внимание V4 Flash продолжает сжимать кэш, в итоге остаётся только 81 визуальная запись KV.
Команда также сгенерировала для этой методики больше 40 миллионов обучающих примеров, включая данные, специально обучающие навигации по лабиринту и отслеживанию пути.
Той проблемой, которой эта статья потратила много усилий на решение, на самом деле была «куда показывать».
Модель сначала должна увидеть, а затем понять, на что именно она смотрит. Только так она сможет продолжать рассуждение дальше.
На этот раз DeepSeek не объяснил, полностью ли Vision Exp унаследовал эту схему Visual Primitives. Но важнее другое: именно это исследование впервые вынесло наружу то, как DeepSeek понимает «визуальное рассуждение».
18 июня режим распознавания изображений на веб-страницах и в приложении официально вышел. На следующий день СМИ загрузили фото Ляна Вэньфэна для теста — DeepSeek два раза подряд принял его за Чжан Иминя. В другом диалоге он снова принял Чжан Иминя за Чэнь Тяньши, основателя Cambricon.
Он уже может читать скриншоты на английском и превращать веб-страницы в код.
Но встретившись с лицом, он даже не смог узнать собственного босса.
19 августа DeepSeek Harness оставила запись с чёткими техническими пояснениями по дате. Официальный адаптер уже умеет сериализовать последовательности изображений в image_url; в документации также указано, что каталог моделей по умолчанию пока не показывает deepseek-v4-flash-vision-exp — нужно дождаться, когда будут доступны соответствующие API-эндпоинты.
20 августа ещё и обнаружилось в личных тестах разработчиков: если передать картинку имени модели, которое ещё не было открыто, в ответ придёт ошибка 400.
21 августа это ограничение убрали. Harness добавила deepseek-v4-flash-vision-exp в каталог моделей по умолчанию, а соответствующий объединённый коммит сразу содержал строку «publish the vision model». Затем одновременно DeepSeek официально объявил о выходе Vision Exp в документации API и в аккаунте в WeChat.
Две линии наконец встретились.
Agent
На записи расшифровки с инвесторской встречи в мае этого года Лян Вэньфэн разложил маршрут AGI в своём понимании по нескольким ступеням: языковые модели, цепочки мышления, Agent, непрерывное обучение, самопереразвитие и дальше — воплощённый интеллект.
Мультимодальность он поставил в место «компонента», почти как поиск.
Когда речь заходит о генерации видео, в транскрипте есть фраза:
В бизнесе это выгодное дело. Но к интеллекту это не имеет почти никакого отношения.
Его оценка: связь между генерацией видео, world model на текущей стадии и верхним пределом интеллекта не настолько уж велика. Здесь важнее прямо сейчас — обучение ИИ и, после обучения, непрерывное обучение.
Отличие мультимодальности в том, что, хотя её тоже разместили в позиции «компонента», DeepSeek прямо говорила, что это будет именно тот компонент, который они обязательно сделают. Тогда Лян Вэньфэн ещё упоминал, что V4 и последующие версии будут поддерживать нативную мультимодальность.
В маршруте DeepSeek у визуальной части всегда было место, просто она не стояла так рано.
Когда маршрут дошёл до третьего шага — Agent — всё начало выглядеть иначе.
DeepSeek не публиковала, что на этот раз визуальный API запустили «только ради Agent». Но если поставить вместе оценку Ляна Вэньфэна о маршруте и сегодняшнее объявление о релизе, эти две линии всё труднее полностью разделять.
Agent должен читать экран, смотреть на диаграммы и обрабатывать скриншоты, которые инструменты «кидают» обратно. Он не может навсегда жить в чистом тексте. Те визуальные способности, которые уже делали два года, наконец добрались от статьи, репозитория и страницы тестов — до API.
Три примера, которые сегодня DeepSeek показал для Vision Exp, тоже не являются традиционным «посмотри на картинку и расскажи»: один Agent делает PPT для премиального клиента о поездке в Тибет на машине; другой заново проектирует официальный сайт DeepSeek Harness; и ещё один пример — по визуальным требованиям делает front-end demo с динамическими эффектами.
Им всем нужно, чтобы модель снова и снова обрабатывала визуальную информацию в задачах с длинным процессом.
Дизайн API тоже движется в этом направлении. Responses API тоже принимает input_image: браузерный Agent, получив скриншот страницы, может заново отправить его в следующий раунд рассуждения. Code Agent может проверить результаты рендера; диаграммы, сканы и даже интерфейсы программ тоже могут напрямую стать контекстом.
Files API решает ещё одну задачу: одну и ту же картинку не нужно повторно загружать в каждом раунде запроса. Файл можно надолго оставить там, а Agent каждый раз повторно передаёт только file_id. В одном запросе максимум ещё можно отправить до 600 изображений. При использовании внешней ссылки или Base64 верхний предел для одной картинки — 32 МиБ; после обращения через Files API можно поднять до 64 МиБ.
Это уже не похоже на то, чтобы добавить в чат кнопку «загрузить изображение».
Скорее похоже, что она просто настраивает инфраструктуру, необходимую Agent для использования зрения.
Сравнения четырех мультимодальных Agent, опубликованные DeepSeek, тоже редко проверяют традиционное в самом широком смысле «смотри на картинку и рассказывай».
ApexBench фокусируется на задачах с длинным циклом в сферах инвестиционного банкинга, консалтинга и права. Agents' Last Exam — на реальных работах из 55 профессиональных областей. Chartography специально проверяет кривые Kaplan–Meier, свечи K-line, изолинии, диаграммы Санки и диаграммы Портера. ZeroBench использует 100 искусственно спроектированных сложных задач, чтобы тестировать многошаговое визуальное рассуждение.
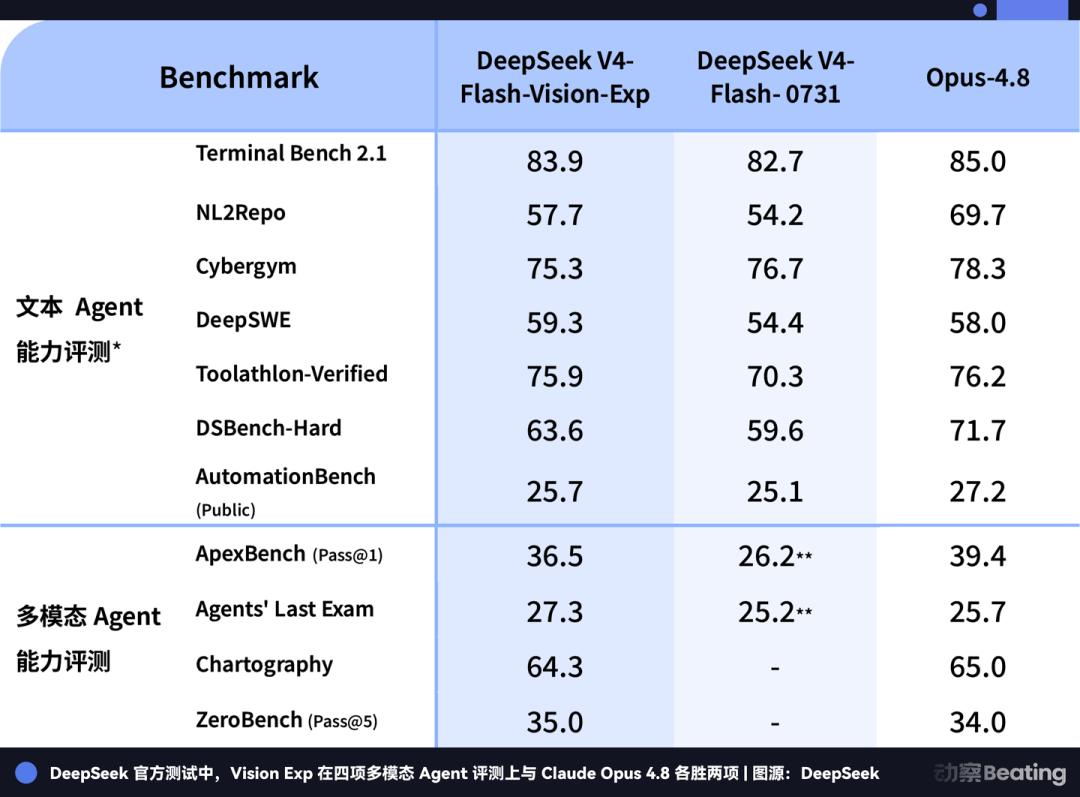
Vision Exp против Claude Opus 4.8 — две победы и два поражения.
Agents' Last Exam: 27.3 против 25.7. ZeroBench: 35.0 против 34.0. ApexBench: 36.5 против 39.4. Chartography: 64.3 против 65.0. Во всех четырёх случаях разрыв не превышает 3 балла.
Самое интересное: добавление зрения не привело к заметному падению исходных способностей текстового Agent.
Если сравнить по пунктам с чисто текстовым V4 Flash, опубликованным 31 июля, то на сайте сразу были представлены пять текстовых бенчмарков для Agent — все они выросли.
Terminal Bench 2.1 вырос с 82.7 до 83.9; NL2Repo — с 54.2 до 57.7; DeepSWE — с 54.4 до 59.3; DSBench-Hard — с 59.6 до 63.6; AutomationBench — с 25.1 до 25.7. У DeepSWE значение 59.3 тоже выше 58.0 у Opus 4.8 на картинке.
Но эти цифры происходят из собственных тестов DeepSeek. Официально указано, что в публичных Code Agent текстовых задачах модели серии DeepSeek используют DeepSeek Harness в минималистичном режиме, а режим инференса выставлен на max. Они лучше подходят, чтобы наблюдать изменения Vision Exp по сравнению с собственным V4 Flash, а не напрямую использоваться как отдельный рейтинг третьих сторон.
Экспериментальный суффикс exp после названия модели тоже пока не сняли.
DeepSeek явно отметила это как экспериментальную модель: версия может продолжать меняться. Сейчас интерфейс делает только понимание изображений, а выход всё ещё — текст. Генерация изображений и видео не открыта; Files API принимает только JPEG, PNG, GIF и WebP — PDF нельзя напрямую передать.
В 2024 году разработчики хотели отправить DeepSeek картинку — но официальное API тогда ещё не умело её принимать.
К 21 августа 2026 года эта картинка наконец-то попала внутрь.
Глаза у DeepSeek действительно открылись позже.
Но когда она наконец действительно откроет глаза, дорога впереди уже не позволит ей идти дальше с закрытыми.
Ссылка на оригинал