OpenGradient меня интересует, потому что он противоречит распространённой крипто-привычке: рассматривать каждый новый AI проект как тот, который должен доказать, что у него есть единственная "лучшая" модель.
Я думаю, что это упускает из виду настоящую проблему.
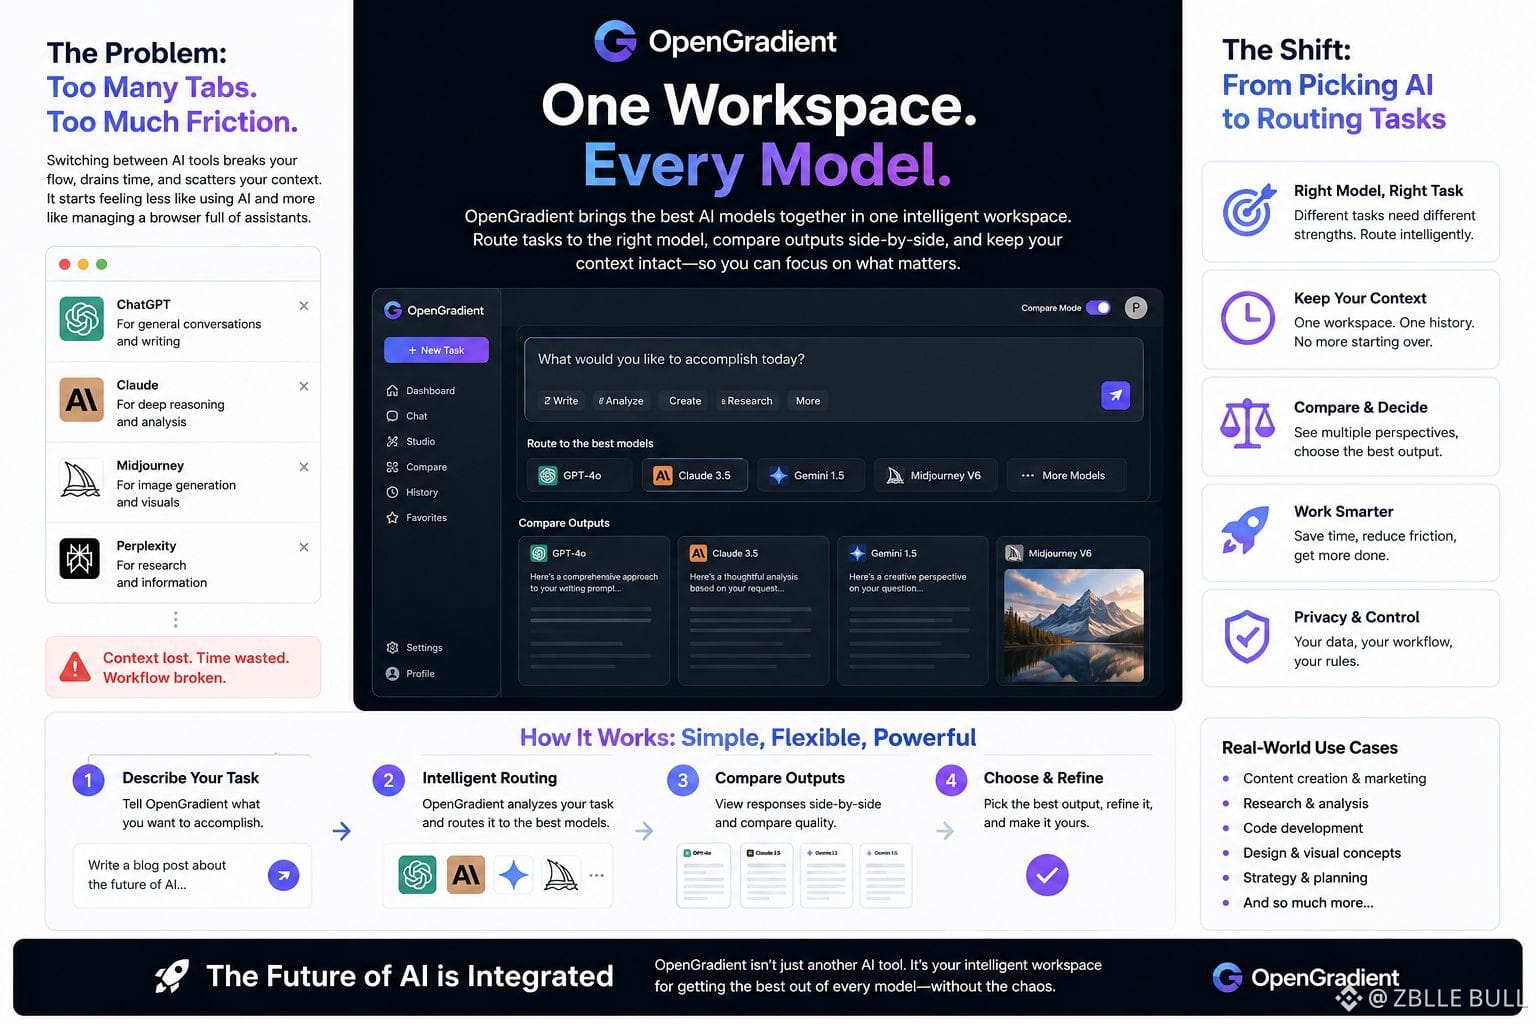
Большинство пользователей не работают в чистых категориях. Одну минуту вы разрабатываете что-то, затем проверяете логику, затем исследуете визуальную идею, затем сравниваете несколько различных выводов. Боль заключается не всегда в качестве модели. Это потеря контекста при переходе между инструментами.
Вот где фокус OpenGradient кажется более практичным. Вместо того чтобы просить пользователей выбрать одну модель и оставаться с ней, он направляет задачу к нужному виду интеллекта. Это звучит просто, но имеет значение, если AI собирается стать повседневной инфраструктурой, а не новинкой.
Сила очевидна: единое рабочее пространство может сделать многоуровневый AI проще в использовании и усвоении. Оно также создаёт пространство для лучшей масштабируемости, потому что разные модели могут выполнять разные задачи, вместо того чтобы заставлять одну систему тащить на себе всё.
Риск в том, что агрегации само по себе недостаточно. Если опыт кажется склеенным вместе, или если решения по маршрутизации неясны, пользователи могут увидеть лишь больше сложности в более красивой обёртке.
Поэтому я наблюдаю за OpenGradient не как за "AI приложением", а скорее как за попыткой сделать AI инфраструктуру удобной для использования. Вопрос в том, сможет ли это превратить выбор модели в то, о чём пользователям не придётся задумываться.
#opg @OpenGradient $OPG
Я думаю, что это упускает из виду настоящую проблему.
Большинство пользователей не работают в чистых категориях. Одну минуту вы разрабатываете что-то, затем проверяете логику, затем исследуете визуальную идею, затем сравниваете несколько различных выводов. Боль заключается не всегда в качестве модели. Это потеря контекста при переходе между инструментами.
Вот где фокус OpenGradient кажется более практичным. Вместо того чтобы просить пользователей выбрать одну модель и оставаться с ней, он направляет задачу к нужному виду интеллекта. Это звучит просто, но имеет значение, если AI собирается стать повседневной инфраструктурой, а не новинкой.
Сила очевидна: единое рабочее пространство может сделать многоуровневый AI проще в использовании и усвоении. Оно также создаёт пространство для лучшей масштабируемости, потому что разные модели могут выполнять разные задачи, вместо того чтобы заставлять одну систему тащить на себе всё.
Риск в том, что агрегации само по себе недостаточно. Если опыт кажется склеенным вместе, или если решения по маршрутизации неясны, пользователи могут увидеть лишь больше сложности в более красивой обёртке.
Поэтому я наблюдаю за OpenGradient не как за "AI приложением", а скорее как за попыткой сделать AI инфраструктуру удобной для использования. Вопрос в том, сможет ли это превратить выбор модели в то, о чём пользователям не придётся задумываться.
#opg @OpenGradient $OPG