Закончил изучение документации по инференсу OpenGradient для этой задачи. Одна вещь не давала мне покоя.
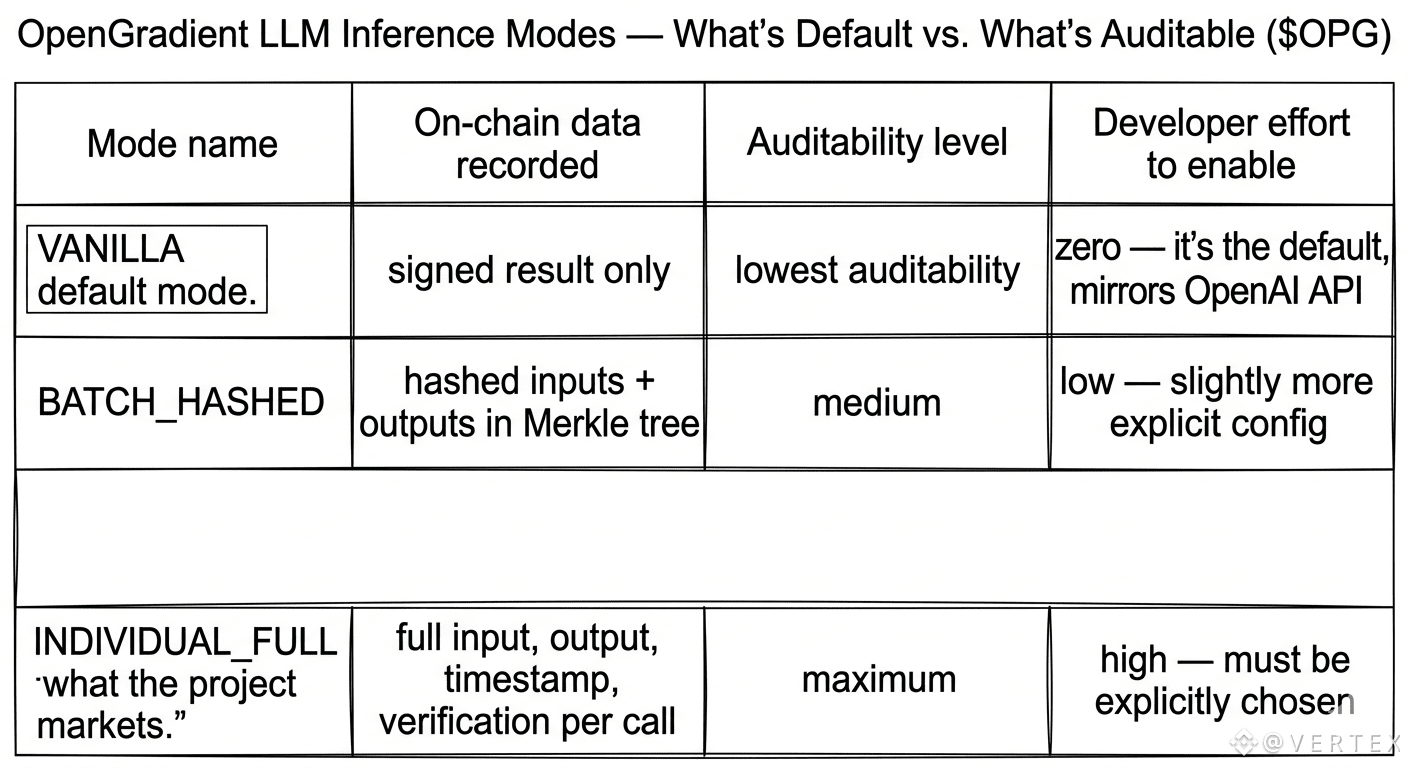
@OpenGradient $OPG #OPG позиционируется вокруг аудируемости — каждый вызов ИИ проверяемый, входные и выходные данные отслеживаемые. Но когда ты открываешь фактический SDK и смотришь на режим инференса по умолчанию, он ВАНИЛЬНЫЙ. Нет TEE. Нет zkML. Просто стандартное выполнение с подписанным результатом. Это режим, к которому большинство разработчиков обращаются в первую очередь, потому что он почти точно соответствует API OpenAI и имеет наименьшие накладные расходы.
Подожди — так что по умолчанию это наименее аудируемый путь. BATCH_HASHED агрегирует в дерево Меркла и дешевле. INDIVIDUAL_FULL фактически записывает входные данные, выходные данные, временную метку и проверку в цепочку за каждый вызов, но это по желанию, а не по умолчанию. Ты должен сознательно выбрать то, что проект рекламирует как свою основную ценность. Вокруг листинга на Upbit 15 июня объем OPG резко возрос до $357.69M — на 606% за 24 часа — в то время как токен открылся на уровне $0.3064 и упал до $0.1815, прежде чем восстановиться. Весь этот шум со стороны биржи. Ничто из этого не касается того, какой режим инференса на самом деле выбирают разработчики на уровне протокола.
Я потратил больше времени, чем ожидал, просто читая о этих трех режимах расчетов. Постоянно думал о том, кто на самом деле выбирает INDIVIDUAL_FULL. Вероятно, это узкий круг — модели рисков DeFi, агенты с высокими ставками. Все остальные берут по умолчанию.
Так может ли OpenGradient сделать ИИ более аудируемым? Да, действительно, если разработчики захотят. Но вопрос в том, станет ли аудируемость по умолчанию нормой, или это останется опцией, которую большинство людей тихо пропускает.
@OpenGradient $OPG #OPG позиционируется вокруг аудируемости — каждый вызов ИИ проверяемый, входные и выходные данные отслеживаемые. Но когда ты открываешь фактический SDK и смотришь на режим инференса по умолчанию, он ВАНИЛЬНЫЙ. Нет TEE. Нет zkML. Просто стандартное выполнение с подписанным результатом. Это режим, к которому большинство разработчиков обращаются в первую очередь, потому что он почти точно соответствует API OpenAI и имеет наименьшие накладные расходы.
Подожди — так что по умолчанию это наименее аудируемый путь. BATCH_HASHED агрегирует в дерево Меркла и дешевле. INDIVIDUAL_FULL фактически записывает входные данные, выходные данные, временную метку и проверку в цепочку за каждый вызов, но это по желанию, а не по умолчанию. Ты должен сознательно выбрать то, что проект рекламирует как свою основную ценность. Вокруг листинга на Upbit 15 июня объем OPG резко возрос до $357.69M — на 606% за 24 часа — в то время как токен открылся на уровне $0.3064 и упал до $0.1815, прежде чем восстановиться. Весь этот шум со стороны биржи. Ничто из этого не касается того, какой режим инференса на самом деле выбирают разработчики на уровне протокола.
Я потратил больше времени, чем ожидал, просто читая о этих трех режимах расчетов. Постоянно думал о том, кто на самом деле выбирает INDIVIDUAL_FULL. Вероятно, это узкий круг — модели рисков DeFi, агенты с высокими ставками. Все остальные берут по умолчанию.
Так может ли OpenGradient сделать ИИ более аудируемым? Да, действительно, если разработчики захотят. Но вопрос в том, станет ли аудируемость по умолчанию нормой, или это останется опцией, которую большинство людей тихо пропускает.