
Когда я углубляюсь в механизмы безопасности на платформе OpenLedger, меня не столько впечатляет криптоэффективность "слепого аудита" (Blind Auditing); существует множество проектов, предлагающих программные решения для блокировки доступа третьих сторон к сохраненному контенту. Однако наиболее актуальный вопрос и интеллектуальная структура Карла заключается в том, защищает ли это полное закрытие целостность знаний или создает идеальные условия для проведения манипуляций, которые невозможно отследить программно.
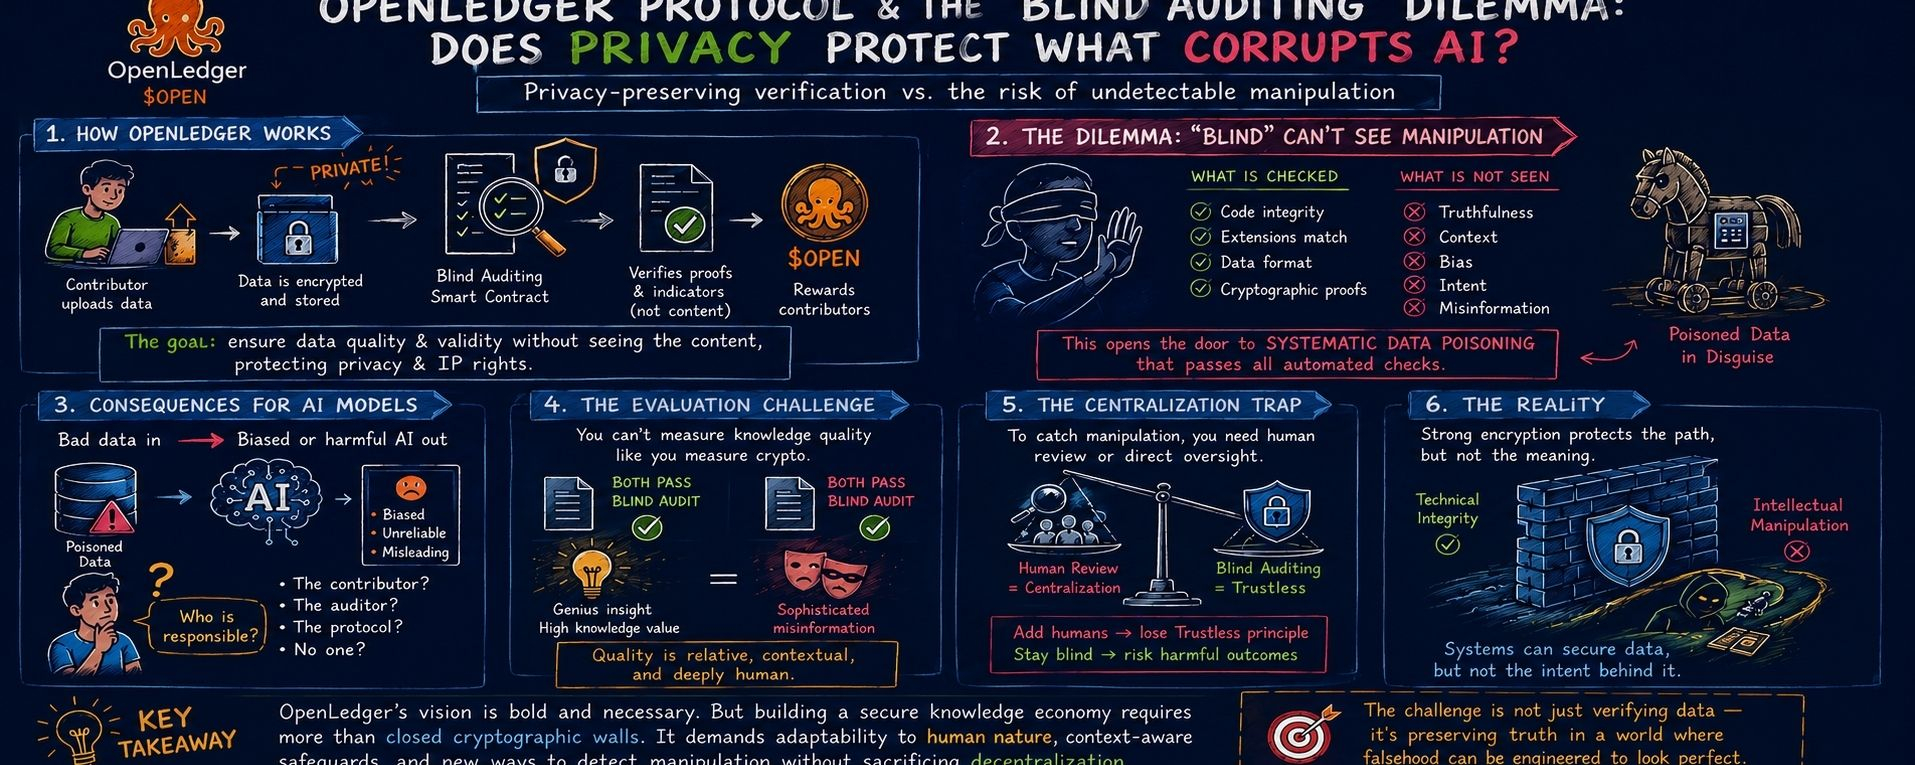
Тезис кажется идеальным с теоретической точки зрения: протокол стремится обеспечить качество и корректность данных через смарт-контракты, которые проверяют индикаторы, не соприкасаясь с самой сутью загруженного материала, чтобы сохранить конфиденциальность участников и их права собственности через $OPEN. Этот баланс выглядит логичным, но перенос механизмов криптографического шифрования в инструмент для сортировки фактов — именно там, где вызовы переплетаются и разрушается его безусловная логическая стройность.
Техническое видение сети предполагает, что изоляция данных и сокрытие их восприятия автоматически создают безопасную среду, но я вижу в этом стремлении чрезмерное упрощение уравнения, крайне сложного по своей природе. Возможность проверять целостность кода и совместимость расширений в публичной бухгалтерской книге без проверки содержательной, смысловой стороны может открыть широкую лазейку для так называемого «системного отравления данных» (Data Poisoning). Между сохранением цифровой идентичности информации и передачей умного обмана (Sophisticated misinformation) пролегает очень тонкая грань, и строгие криптографические формулы не всегда располагают достаточным осознанием того, где именно проходит эта грань.
Эта проблема укореняется при рассмотрении ответственности итоговых моделей: децентрализация и сокрытие контента создают ощущение безусловной безопасности, пока алгоритмы ИИ не начнут демонстрировать катастрофические предвзятости или вводящие в заблуждение результаты из‑за данных, структурно испорченных и переданных под прикрытием приватности. В этот момент — кто несет ответственность? Протокол, который полагается исключительно на шифрование, может столкнуться с системной неспособностью проследить корни поведенческого взлома, тогда как переход к человеческой проверке или прямому надзору немедленно вернет систему в квадрат централизации и сотрет лозунг «доверие не требуется», на котором строился проект.
Оценочная сторона контента накладывает дополнительные дилеммы: данные, предназначенные для ИИ, нельзя оценить по качеству так, как оценивают стандартизированные криптовалюты, ведь их ценность относительна и всецело зависит от контекста и человеческого смысла. Два программных файла могут пройти «слепой аудит» с одинаковым числовым результатом, но один содержит гениальный поток знаний, тогда как другой несет продуманное заблуждение, облеченное в отточенную техническую оболочку. Исходя из этого, ставка на автоматизацию качества интеллектуальных активов без понимания их природы может оказаться куда более сложной, чем это обещают технические материалы проекта.
Это противоречие не умаляет амбиций OpenLedger, а лишь показывает, что построение безопасной экономики знаний требует большего, чем глухие стены криптографии. Финальный результат будет определяться не тем, насколько плотно устроены смарт‑контракты «слепой проверки», а тем, насколько протокол способен справляться с ускользающей природой людей, которые умеют использовать организационные лазейки; программный код может гарантировать техническую целостность пути, но он бессилен перед защитой контента от систематического интеллектуального подлога.