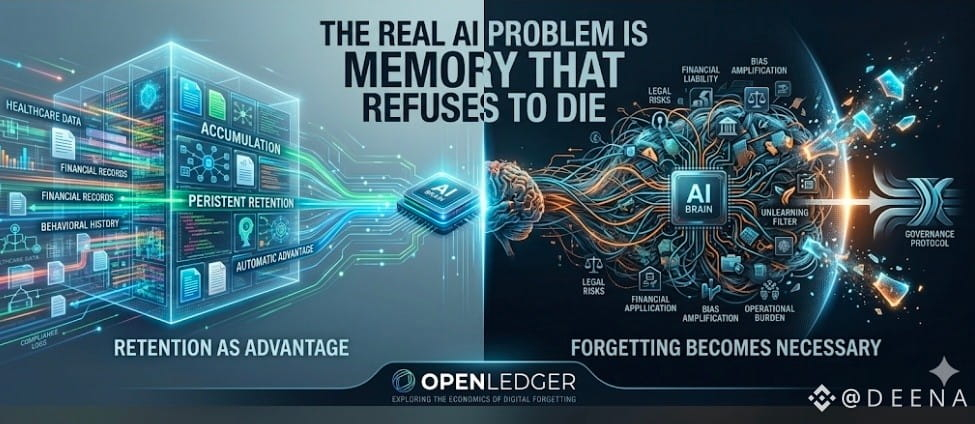
Настоящая проблема ИИ может заключаться не в интеллекте… а в памяти, которая отказывается умирать
Я постоянно возвращаюсь к одной неприятной мысли об ИИ.
Настоящая проблема может заключаться вовсе не в интеллекте. Это может быть память.
В течение многих лет технологическая отрасль рассматривала удержание как автоматическое преимущество. Храните больше данных. Отслеживайте больше поведения. Сохраняйте больше истории. Предположение было простым: больше памяти создает лучшие системы.
Но чем глубже ИИ проникает в здравоохранение, финансы, соблюдение норм, операции с клиентами и принятие решений, тем труднее игнорировать негативные последствия этой логики.
Потому что ИИ на самом деле не «забывает».
Как только информация попадает в тренировочный конвейер, слой извлечения или поведенческую систему, она распространяется по модели так, что впоследствии ее трудно изолировать. Удалить файл легко. Убрать влияние информации из самого интеллекта гораздо сложнее.
Этот сдвиг отчасти объясняет, почему OpenLedger начал казаться мне более интересным.
Сначала я видел в этом еще одну нарративную инфраструктуру ИИ, сосредоточенную на атрибуции и координации данных. Но более глубокий слой может быть совершенно иным.
Как только атрибуция становится постоянной и экономически значимой, память перестает быть бесплатной инфраструктурой. Она становится обязательством, активом и в конечном итоге проблемой управления одновременно.
И в тот момент, когда память несет юридическую, финансовую и операционную нагрузку, забывание перестает выглядеть неэффективным.
Оно начинает казаться необходимым.
#openledger @OpenLedger $OPEN
Я постоянно возвращаюсь к одной неприятной мысли об ИИ.
Настоящая проблема может заключаться вовсе не в интеллекте. Это может быть память.
В течение многих лет технологическая отрасль рассматривала удержание как автоматическое преимущество. Храните больше данных. Отслеживайте больше поведения. Сохраняйте больше истории. Предположение было простым: больше памяти создает лучшие системы.
Но чем глубже ИИ проникает в здравоохранение, финансы, соблюдение норм, операции с клиентами и принятие решений, тем труднее игнорировать негативные последствия этой логики.
Потому что ИИ на самом деле не «забывает».
Как только информация попадает в тренировочный конвейер, слой извлечения или поведенческую систему, она распространяется по модели так, что впоследствии ее трудно изолировать. Удалить файл легко. Убрать влияние информации из самого интеллекта гораздо сложнее.
Этот сдвиг отчасти объясняет, почему OpenLedger начал казаться мне более интересным.
Сначала я видел в этом еще одну нарративную инфраструктуру ИИ, сосредоточенную на атрибуции и координации данных. Но более глубокий слой может быть совершенно иным.
Как только атрибуция становится постоянной и экономически значимой, память перестает быть бесплатной инфраструктурой. Она становится обязательством, активом и в конечном итоге проблемой управления одновременно.
И в тот момент, когда память несет юридическую, финансовую и операционную нагрузку, забывание перестает выглядеть неэффективным.
Оно начинает казаться необходимым.
#openledger @OpenLedger $OPEN