
 Одна вещь, которую, я думаю, рынок все еще неправильно понимает о искусственном интеллекте, это то, что компании на самом деле не оптимизируют для интеллекта.
Они оптимизируют на выживаемость.
Звучит цинично, пока не увидишь, как на самом деле принимаются решения в области корпоративных технологий.
Советы директоров не заботятся о том, впечатляющая ли философски модель. Юридические отделы не волнует, элегантна ли архитектура. Команды по соблюдению норм не просыпаются с волнением о передовых контрольных показателях. Большинство корпораций в конечном итоге заботятся только об одном:
Может ли эта система создавать ценность, не создавая неконтролируемую экспозицию позже?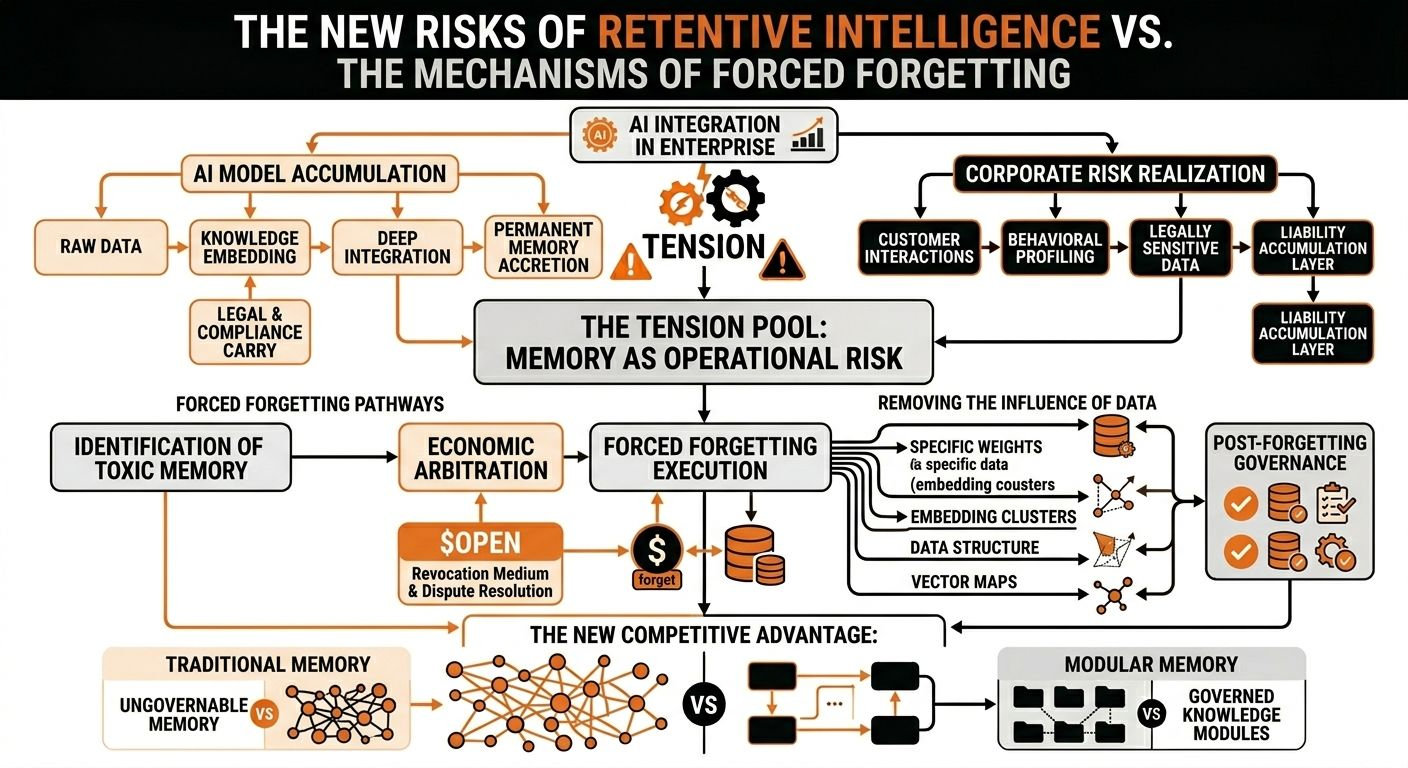
Поэтому OpenLedger для меня становится все интереснее по мере того, как я глубже думаю о том, куда движется корпоративный ИИ.
Большинство людей по-прежнему смотрят на OpenLedger через знакомую призму децентрализованного ИИ. Содействующие данными, системы атрибуции, Datanets, координация моделей, токен-инцентивы через $OPEN. Окей. На поверхности существует именно такое толкование.
Но я все больше подозреваю, что более важный слой — совсем другой.
Возможно, OpenLedger на самом деле выстраивает свою позицию вокруг будущего, где избирательное неведение станет экономически стратегическим.
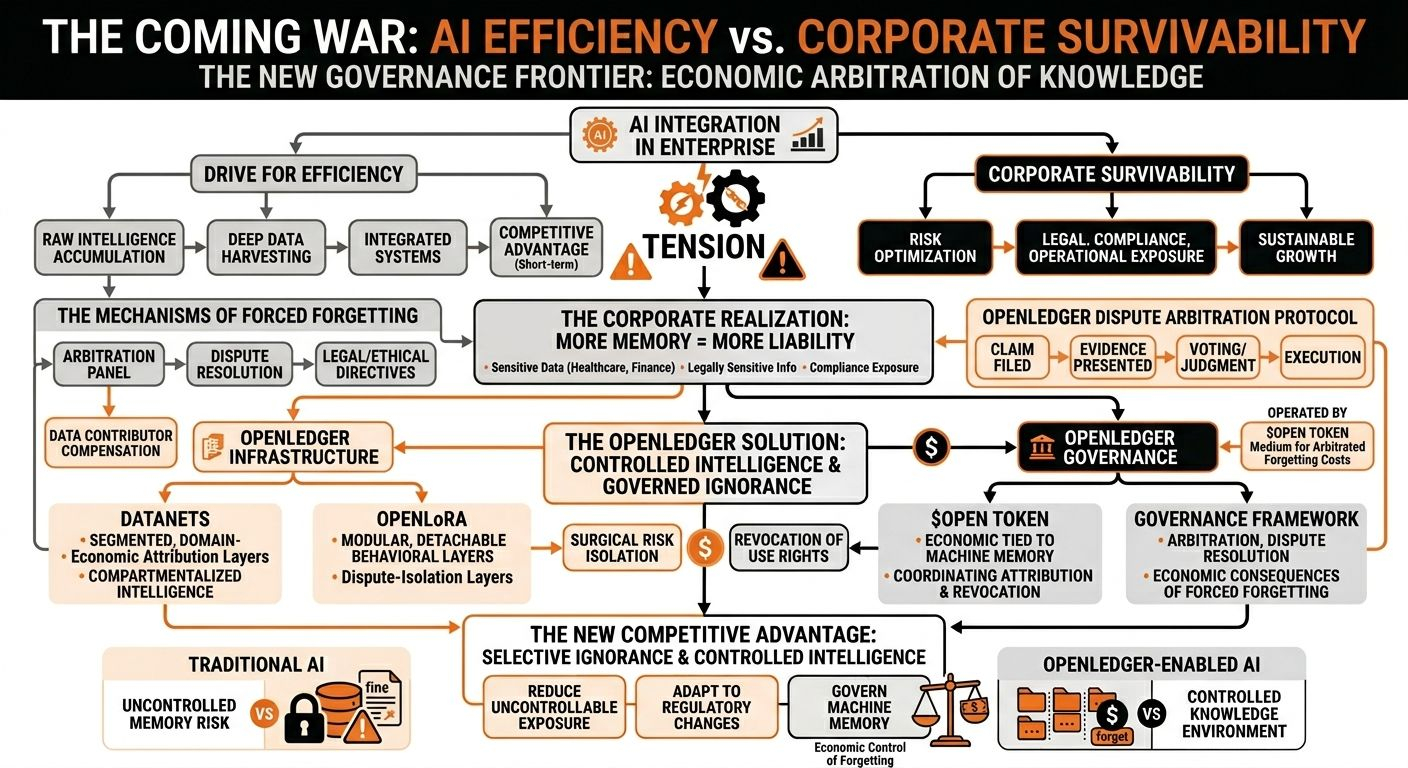
Потому что прямо сейчас рынок ИИ все еще заперт в психологии накопления. Каждая компания считает, что конкурентное преимущество возникает из удержания как можно большего объема информации. Больше взаимодействий с клиентами. Больше поведенческих паттернов. Больше исторических записей. Больше проприетарного контекста.
Предпосылка этой стратегии проста: больше памяти — значит лучше интеллект.
Но эта логика тихо ломается, как только сама память начинает генерировать юридические, операционные и финансовые риски быстрее, чем производит ценность.
И честно говоря, я думаю, что многие предприятия уже гораздо ближе к этому пониманию, чем публичный рынок.
Сейчас большинство корпоративных ИИ-систем все еще работает в относительно контролируемых средах. Внутренние копилоты. Дополнение для клиентского сервиса. Автоматизация рабочих процессов. Поддержка аналитики. Но чем глубже ИИ уходит в регулируемые отрасли и критически важную для решений инфраструктуру, тем опаснее становится удерживаемый интеллект.
Потому что корпоративная память не нейтральна.
Медицинская модель, сохраняющая чувствительный диагностический контекст, — это не просто «умно». Это означает носить ответственность. Финансовая система советов, обученная годами поведенческих данных о клиентах, — это не просто персонализация. Она накапливает экспозицию соответствия требованиям. Корпоративный агент, который впитывает внутренние коммуникации, может непреднамеренно стать постоянным архивом юридически чувствительной информации.
И по-настоящему неприятная часть вот в чем:
Большинство систем ИИ структурно неспособны корректно «забывать».
Это создает странное будущее, в котором предприятия со временем могут конкурировать меньше тем, как много знают их системы…
и к тому, насколько точно они могут контролировать, что именно эти системы допускается продолжать «знать».
Пока это различие явно недооценено по цене.
Потому что как только данные встраиваются по тонконастроенным слоям, системам поиска, векторным пространствам и даже в само поведение модели, удаление перестает работать как традиционное программное удаление. Предприятия медленно обнаруживают, что «удалить данные» и «удалить влияние данных» — это совершенно разные инженерные задачи.
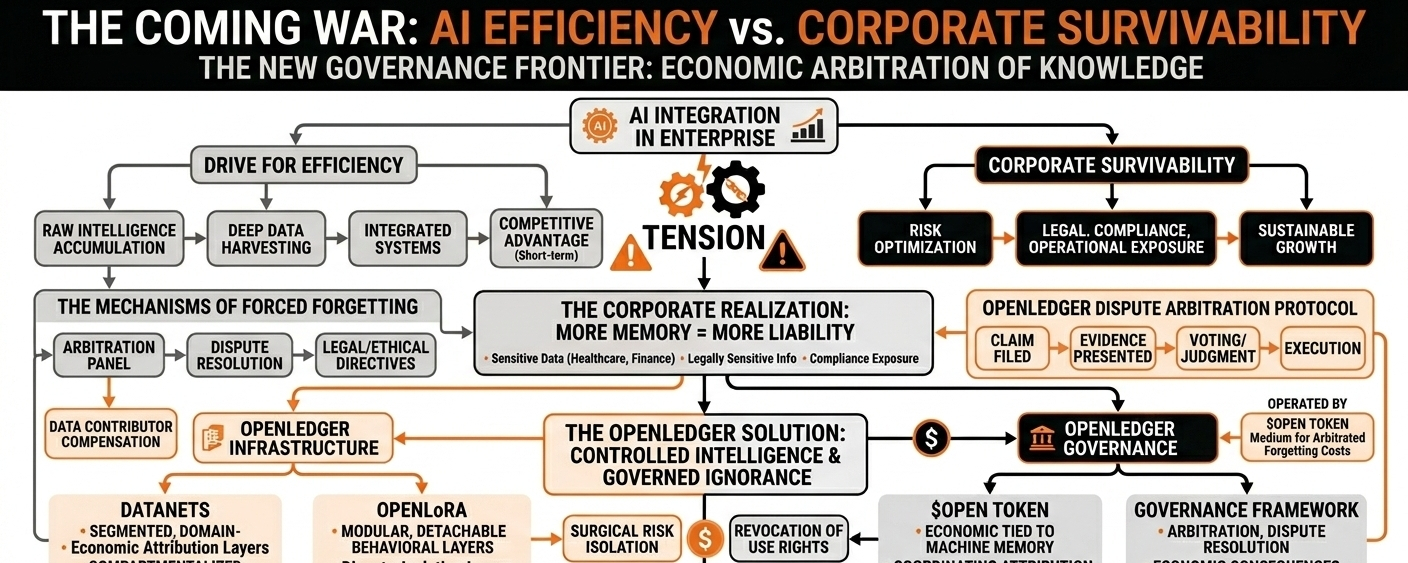
Именно здесь OpenLedger начинает выглядеть меньше как децентрализованный рынок данных и больше как инфраструктура для разграничения корпоративных рисков.
Архитектура Datanet интересна для этого самого конкретного сценария. Вместо того чтобы рассматривать интеллект как один гигантский недифференцированный пул памяти, структура подталкивает к сегментированным средам знаний, завязанным на атрибуцию и экономическую ответственность.
На первый взгляд это звучит неэффективно по сравнению с грубой централизованной аккумулирующей моделью ИИ.
В долгосрочной перспективе, возможно, это действительно станет операционно необходимым.
Потому что сегментированный интеллект проще контролировать, чем постоянную обобщенную память.
И потому OpenLoRA кажется куда более важным, чем сейчас понимает большинство. Рынок обычно описывает его как слой эффективности для дешевого развертывания облегченных адаптаций моделей. Но глубинный смысл — архитектурная гибкость.
Если интеллект можно модульно разложить, его можно и отделить.
Это меняет всю экономику рисков корпоративного ИИ.
Корпорации больше не нужно переобучать всю базовую фундаментальную систему каждый раз, когда меняется регуляторная рамка или когда набор данных становится проблемным. Отдельные поведенческие слои теоретически можно изолировать, отключать, заменять или экономически переводить в разряд устаревших/неактуальных.
Иными словами, OpenLoRA — это не просто помощь ИИ специализироваться.
Это помогает ИИ становиться избирательно одноразовым.
Позже это может оказаться невероятно ценным.
Особенно потому, что предприятия почти никогда не оптимизируют ради идеализма. Они оптимизируют ради контролируемого доступа/воздействия. Способность точечно изолировать операционные риски, не обрушивая весь стек системы, — за это корпорации исторически платят огромные премии.
И вот я снова возвращаюсь к $OPEN самому по себе.
Я думаю, большинство людей по-прежнему оценивают токен, опираясь на стандартную логику криптоинфраструктуры: больше использования, больше транзакций, больше активности экосистемы, больше спроса.
Возможно.
Но более интересная возможность в том, что $OPEN становится экономически связано с управлением машинной памятью самой по себе. Не просто облегчает потоки интеллекта, а координирует стоимость, атрибуцию, сохранение и в конечном итоге удаление слоев интеллекта, работающих поверх корпоративных систем.
Это куда более странный рынок, чем люди себе представляют.
Потому что когда память начинает нести финансовый и юридический вес, инфраструктура ИИ перестает быть чисто технической.
Это становится политикой.
Кто контролирует права на отзыв?
Кто арбитражит споры между поставщиками данных и предприятиями?
Кто решает, когда сохраненный интеллект становится небезопасным?
Кто берет на себя экономические последствия вынужденного «забывания»?
Эти конфликты не имеют простых ответов.
И честно говоря, именно поэтому эта область ощущается структурно важной.
Рынок ИИ по-прежнему ведет себя так, будто первичным дефицитным ресурсом остается «сырой» интеллект.
Я все больше думаю, что контролируемый интеллект станет дефицитнее.
Это меняет то, какие уровни инфраструктуры важнее всего.
OpenLedger вполне может потерпеть неудачу. Большинство инфраструктурных протоколов — тоже. Уже одна операционная сложность — серьезный вызов. Предприятия могут продолжать предпочитать централизованную непрозрачность просто потому, что это проще и быстрее.
Но если со временем системы ИИ станут настолько глубоко интегрированы в экономическую жизнь, что неконтролируемая память превратится в институциональный риск…
тогда компании, способные управлять неведением машин, могут стать более ценными, чем компании, которые просто строят более умные машины.
И все больше кажется, что OpenLedger — один из немногих проектов, который уже строит вокруг этого будущего напряжения, прежде чем рынок полностью его увидит.
#OpenLedger #openledger $BSB @OpenLedger
#BitcoinBreaksBelow75KAsWarshTakesFedHelm #FenwickWestSettlesFTXFor54M #SECHaltsInnovationExemption