
В качестве независимого разработчика я потратил полтора месяца на создание с нуля настольного приложения для мониторинга и умного анализа активов на двух блокчейнах под названием "Сяо Нань Web3 Сентинел". Оно поддерживает все совместимые с EVM цепочки и цепочку Solana, интегрирует интерпретацию торговых данных с использованием ИИ, многоуровневую рассылку и агрегацию данных на блокчейне, и стабильно работает уже несколько месяцев.
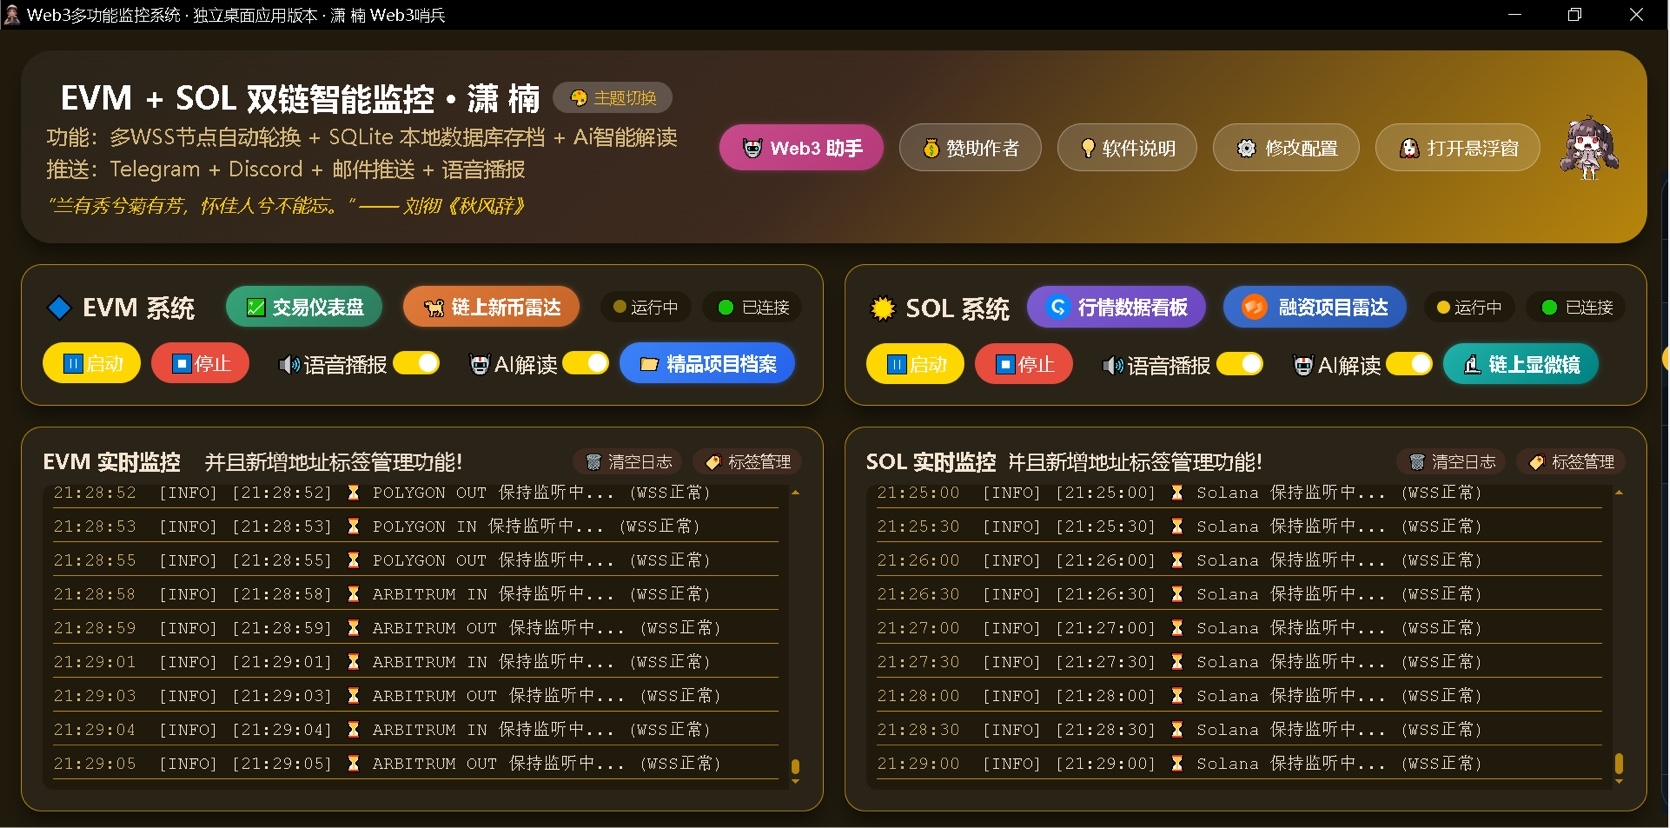
Недавно я публиковал технический обзор, но всегда чувствовал, что анализ ключевых реализаций недостаточно "утоляет жажду". Поэтому я решил написать этот глубокий технический разбор, в котором без утайки поделюсь теми дизайнерскими решениями и деталями реализации, которые скрыты в коде, с точки зрения архитектуры процессов, I/O модели, согласованности данных и инженерии ИИ. Надеюсь, что эта статья сможет предоставить полезные рекомендации разработчикам, которые также исследуют сферу Web3.
I. Архитектура процесса: почему выбран вариант «главный процесс + несколько дочерних процессов»?
Многие скрипты мониторинга на Python используют однопроцессный asyncio «всё в одну кучу», но ещё на этапе проектирования я решительно выбрал микроядровую архитектуру: «главный процесс (GUI) + отдельный дочерний процесс (EVM/SOL)».
1.1 Изоляция и стабильность превыше всего
Длинное WebSocket-соединение очень легко вызывает исключения при нестабильности сети, вплоть до того, что C-расширения внизу могут упасть по неизвестным причинам. Если смешать GUI и логику мониторинга в одном процессе, любой непойманный exception или нарушение доступа к памяти может привести к мгновенному вылету всего настольного приложения. Разнеся логику мониторинга EVM и Solana в отдельные дочерние процессы через subprocess.Popen, я добился физической изоляции: если Evm.py падает или его принудительно Kill’ят, главное окно продолжает работать нормально, иконка в трее не исчезает, а пользователь может нажать «Запуск», чтобы запустить заново.
Передача логов: главный процесс перехватывает stdout дочернего процесса через канал, использует поток forwardoutput для построчного чтения и очистки ANSI-кодов, а затем через window.evaluate_js внедряет DOM во фронтенд. В итоге логи обновляются в реальном времени, при этом поток UI остаётся лёгким.
1.2 Детали управления жизненным циклом
В core_process.py остановка дочернего процесса — это не просто terminate(). Я реализовал набор механизма «жесткой подстраховки»:
python
proc.terminate()
proc.wait(timeout=3)
if proc.poll() is None:
proc.kill()
proc.wait(timeout=2)
if proc.poll() is None:
os.system(f'taskkill /F /PID {proc.pid}')
Эта связка гарантирует, что даже если Python-интерпретатор зависнет, Windows сможет полностью очистить дерево процессов, предотвращая оставшиеся процессы, занятые порты или блокировки базы данных, из-за которых следующий запуск не удастся.
II. Модель ввода-вывода и соединения с высокой доступностью: не только asyncio
2.1 Режим смешанного мониторинга: WSS в реальном времени + компенсация через RPC
Для нативной монеты в EVM из-за отсутствия стандартного события Transfer нельзя подписаться через WSS. Я спроектировал опциональный «компенсатор» polling: каждые 60 секунд через RPC получаю eth_getBalance, сравниваю со снимком памяти и, если разница превышает 1e-18, отправляю push. Несмотря на простоту механизма, он на самом деле является последней линией обороны, когда WSS-подписка «умирает».
Для токенов и NFT система подписывается на logs и тщательно обрабатывает события ERC1155 TransferSingle и TransferBatch. Особенно для TransferBatch: поле data содержит динамический массив. Я сделал ручной разбор смещений по спецификации ABI, а не полагался на тяжёлые библиотеки — это существенно снижает затраты на парсинг.
2.2 Экспоненциальный backoff для WSS и горячая смена узлов
В продакшене публичные RPC/WSS узлы могут в любой момент ограничивать частоту или падать. Я реализовал в chain_wss_monitor_direction ротацию узлов и стратегию переподключения:
Пул узлов: в конфигурационном файле для каждой цепочки задаются несколько WSS_NODES; при запуске выбирается один — случайно или по порядку.
Алгоритм backoff: после обрыва соединения интервал повторной попытки начинается с 5 секунд, затем удваивается до 60 секунд, чтобы не устраивать DDoS-шторм повторных подключений до восстановления узла.
Адаптация под сетевую среду в Китае: система поддерживает настройку HTTP-адреса локального прокси-софта, и через библиотеку websockets_proxy перенаправляет WSS-трафик на прокси, восстанавливая стабильную связь с узлами за рубежом.
2.3 Асинхронный конвейер парсинга Solana
Скорость включения в блок у Solana очень высокая, а структура транзакций сложная. Чтобы избежать блокировки при вызовах Helius API во время приёма сообщений WSS, я спроектировал модель разъединения производитель–потребитель:
Производитель: когда WSS logsSubscribe получает подпись, она сразу отправляется в asyncio.Queue или напрямую запускается фоновая asyncio.create_task.
Потребитель: отдельная асинхронная задача отвечает за вызовы интерфейса Helius /v0/transactions, разбирая поля nativeTransfers, tokenTransfers, events.nft и т.п.
Это гарантирует, что цикл recv() для WSS-соединения никогда не будет «залипать» из-за медленного HTTP-запроса, сохраняя актуальность сообщений даже в среде с очень высоким TPS.
III. Согласованность данных: от дедупликации в памяти до ограничений SQLite
3.1 Со стороны EVM: уникальный индекс базы данных
В мониторинге EVM одну и ту же транзакцию могут обрабатывать несколько раз по разным причинам, включая переподключения WSS и компенсацию polling. Одного memory set недостаточно, особенно после перезапуска процесса. Поэтому я добавил составное уникальное ограничение для таблицы tx_history:
sql
UNIQUE(tx_hash, log_index, address)
Любая повторная вставка будет беззвучно отбрасываться механизмом SQLite через ON CONFLICT IGNORE, обеспечивая идемпотентность на уровне ядра базы данных. Для нативных переводов без log_index понижаем режим: используем tx_hash + address в качестве составного ключа.
3.2 Со стороны Solana: дедупликация подписей в пределах временного окна
У Solana транзакций нет понятия log_index, а разбор Helius может возвращать несколько записей. Я храню в памяти set недавно обработанных подписей и использую вариант идеи LimitedSizeDict: когда размер множества подписей превышает 1000, оно автоматически очищает половину (или использует OrderedDict, чтобы убрать самые старые элементы). Такое скользящее окно дедупликации даёт хороший баланс между производительностью и точностью.
IV. Инженеризация AI: устойчивость к ошибкам от нескольких провайдеров и искусство парсинга JSON
4.1 Динамическая диспетчеризация, управляемая признаками
MultiAIClient — это ядро модуля AI. Это не просто ветвление if-else, а планировщик, основанный на флагах возможностей. В конфигурационном файле определены функции, поддерживаемые каждым провайдером (например, transaction_insight, daily_report и т.д.). Когда поступает запрос на интерпретацию, система отфильтровывает список провайдеров, поддерживающих нужный признак, и отправляет запрос по приоритету. При таймауте или ошибке автоматически понижается уровень — запрос переходит к следующему провайдеру.
4.2 Защитный парсинг вывода LLM
Нестабильный вывод больших моделей в JSON — это норма. Мой обработчик намного сложнее, чем просто json.loads:
Очистка: удаление маркеров Markdown-блоков json` и。
Извлечение регуляркой: если парсинг не удался, напрямую извлекаю поле насильно регулярным выражением r'"insight"\s*:\s*"([^"]*)"'. Это последняя линия обороны.
Маппинг полей: совместимость с разными названиями ключей, включая insight / Insight / разъяснение и т.п.
Эта схема гарантирует, что даже если Moonshot или DeepSeek вернули «половину JSON», фронтенд всё равно покажет корректную интерпретацию и не упадёт с JSONDecodeError, из-за чего появится белый экран.
V. Память и производительность: LimitedSizeDict и асинхронная очередь
5.1 Словарь с настраиваемой ограниченной ёмкостью
В стандартной библиотеке Python нет встроенного LRU и нет словаря с ограниченным размером. Я реализовал LimitedSizeDict на базе collections.OrderedDict:
python
def setitem(self, key, value):
if len(self) >= self.max_size:
self.popitem(last=False) # вытеснение самого раннего добавленного элемента
super().__setitem__(key, value)
Эта простая структура данных используется для кэширования токен-данных, кэширования цен, кэширования NFT-метаданных. Она гарантирует, что при длительной работе объём памяти не раздувается линейно с ростом количества наблюдаемых адресов — память стабильно держится на очень низком уровне.
5.2 Асинхронная последовательная запись логов Solana
Подробные логи транзакций Solana нужно записывать в JSON-файл. Если несколько корутин одновременно делают json.dump, формат файла легко повреждается. Я ввёл asyncio.Queue:
Все запросы на запись логов складываются в очередь.
Единственная фоновая сопрограмма filewriter блокирующе ожидает очередь, извлекает данные и выполняет file I/O.
Это одновременно избегает сложных блокировок потоков и использует асинхронные возможности для обеспечения безопасности данных при высокой конкуренции.
VI. Двусторонняя связь между фронтендом и бэкендом: глубокая интеграция pywebview
6.1 Внедрение JS API
pywebview позволяет напрямую выставлять методы Python наружу для JavaScript во фронтенде. Мой класс Api наследуется от нескольких Mixin, и все публичные методы, начинающиеся с def, автоматически становятся членами window.pywebview.api. Это позволяет с минимальными затратами реализовать раздельную работу фронтенда и бэкенда: фронтенду нужно только заниматься UI-взаимодействием.
6.2 Отдельный экземпляр плавающего окна и коммуникация
Плавающее окно — это не дочерний DIV главного окна, а второе независимое окно, которое создаёт pywebview. Я управляю его жизненным циклом через FloatingWindowManager и использую js_api экземпляр главного процесса, чтобы внедрять в плавающее окно JS-код (evaluate_js). Так я обеспечил, что логи главного окна в реальном времени отправляются в плавающее. Эта конструкция гарантирует, что даже если плавающее окно закрыто, это не влияет на работу основной задачи мониторинга.
VII. Упаковка настольного приложения: глубокие проблемы PyInstaller и инженерные практики
Передать Python-проект конечным пользователям без технической базы, собрав его в автономный EXE — неизбежный шаг. PyInstaller кажется командой «одна команда — и готово», но в сложных проектах за этим скрывается множество деталей, которые могут довести разработчика до краха. В этом разделе я делюсь несколькими типичными «глубокими ямами» и решениями, с которыми столкнулся при упаковке «潇楠 Web3 哨兵».
7.1 Неявные импорты и --hidden-import
PyInstaller строит дерево зависимостей, анализируя инструкции import в точке входа. Однако многие библиотеки (например, pystray, websockets) используют importlib.import_module или динамическую загрузку подмодулей через import, из-за чего собранный EXE во время выполнения выбрасывает ModuleNotFoundError.
Ключ к решению этой проблемы — по информации об ошибке «в обратную сторону» определить, какой модуль отсутствует, и явно указать его в команде упаковки через --hidden-import. Например, в этом проекте функциональность иконки в трее обязательно нужно добавить:
bash
--hidden-import pystray._win32
--hidden-import pystray._util
--hidden-import win32event
--hidden-import win32api
Это требует от разработчика понимания внутренней структуры библиотек-зависимостей. Обычно нужно комбинировать чтение исходников и многократные эксперименты, чтобы полностью перечислить все неявные зависимости.
7.2 --collect-all и ловушки с файлами ресурсов
Библиотека pywebview включает не только Python-код, но и зависит от frontend HTML/JS, а также файлов runtime Edge WebView2. Встроенный в PyInstaller анализ по умолчанию не способен распознать эти некодовые ресурсы. Если ничего не сделать, после упаковки программа будет показывать белый экран, потому что не найдет index.html или webview.js.
Правильный способ — использовать --collect-all pywebview: этот параметр заставляет PyInstaller полностью скопировать в папку сборки все файлы из каталога pywebview (включая бинарники и статические ресурсы). Это стандартная операция для обработки таких «тяжёлых» GUI-библиотек.
7.3 Бинарные зависимости и сжатие UPX
Библиотеки вроде pywin32, Pillow и т.п., от которых зависит проект, содержат бинарные файлы .pyd и .dll. Они довольно объёмные и после упаковки PyInstaller не сжимаются автоматически. Подключив инструмент UPX и указав --upx-dir в команде сборки, можно добиться высокопроцентного сжатия бинарников внутри итогового EXE (обычно уменьшение на 30%-50% объёма). Учтите: крайне редко старые антивирусы могут дать ложное срабатывание на программы с UPX-обёрткой, но для технически ориентированной аудитории вероятность низкая, и это можно решить, отправив образец.
7.4 «Заморозка» путей и sys._MEIPASS
Это ключевое понятие в упаковке через PyInstaller. На этапе разработки программа получает доступ к конфигам и графическим ресурсам через file или относительные пути. После сборки в один EXE все ресурсы распаковываются во временный каталог, путь к которому хранится в переменной sys._MEIPASS.
Разработчик должен выполнить глобальную замену всей логики обращения к файлам в коде. Типовой шаблон выглядит так:
python
def get_resource_path(relative_path):
if getattr(sys, 'frozen', False):
base = sys._MEIPASS
else:
base = os.path.abspath(".")
return os.path.join(base, relative_path)
Игнорирование этой настройки приведёт к тому, что во время выполнения программа не сможет найти никаких внешних файлов — это самая частая «патологическая» проблема путей у новичков при упаковке. Мой подход — завернуть эту функцию в utils.py, чтобы весь проект использовал её единообразно, обеспечивая одинаковое поведение путей до и после упаковки.
7.5 Особая обработка дочерних процессов
В этой системе используется архитектура, при которой главный процесс запускает дочерние процессы. После упаковки скрипты дочерних процессов Evm.py и Sol.py тоже упакованы внутрь EXE. Если главный процесс всё равно попытается запустить их через python.exe Evm.py, всё завершится неудачей из‑за отсутствия файла. Моё решение — при запуске дочернего процесса в главном процессе динамически проверить, находимся ли мы в режиме упаковки, и передать корректный параметр --main-exe-dir, чтобы дочерний процесс мог найти внешний каталог, где лежит конфигурация. Детали этой логики уже описаны в главе про архитектуру процессов — здесь не повторяю.
VIII. Заключение
Оглядывая весь путь разработки — от одиночного скрипта до архитектуры с несколькими процессами; от «голого» WebSocket до пула узлов с высокой доступностью; от простого print-лога до структурированного хранения в SQLite — каждый шаг углублял понимание инженеризации. А исследование упаковочного этапа особенно наглядно показало: сделать софт просто «запускающимся» — это только первый шаг; добиться того, чтобы пользователям было легко им пользоваться, — и есть настоящая доставка.
Это не просто инструмент мониторинга — это итог моего практического опыта в таких областях, как асинхронное программирование, управление процессами, интеграция AI и разработка настольного ПО.
Если вас интересуют какие-либо технические детали из текста, добро пожаловать на мой GITHUB:
https://github.com/pingdj/Web3
Получить софт и больше технической документации. Также буду рад общению в Binance Square и обсуждению с вами технических тем.
Об авторе: Сяо Нань, full-stack & Web3 независимый разработчик; фокус на Python настольных приложениях, анализе данных блокчейна и инженерной реализации AI.
