
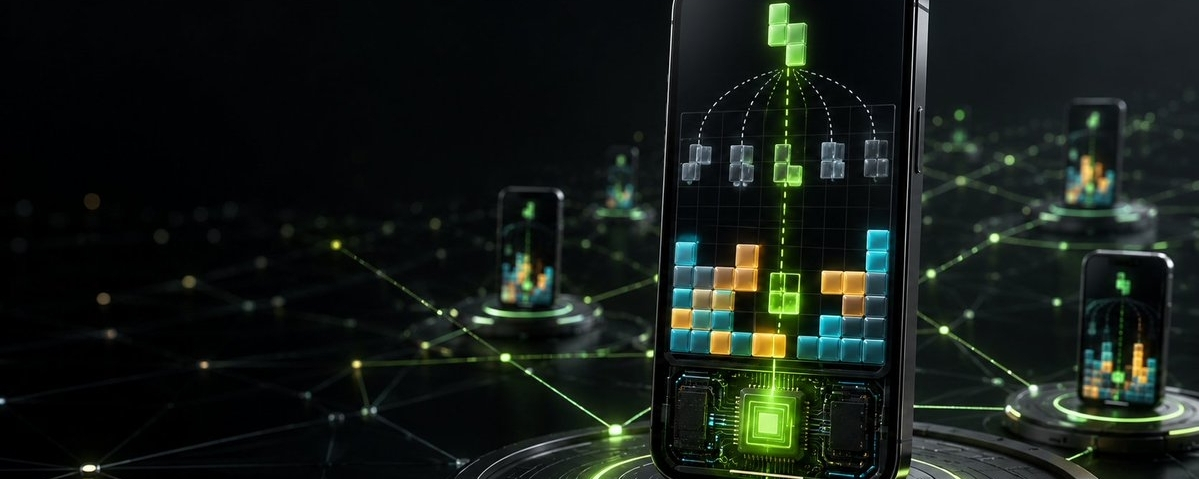

最近很多 AI 项目都在比参数、GPU 数量和模型规模, @Acurast Acurast 放出的这个演示却有点反着来:让一部 Android 手机决定俄罗斯方块的下一块应该放在哪里。
乍一看,这像是一个挺轻松的小游戏。但我觉得它有意思,并不是因为“AI 会玩俄罗斯方块”。这件事早就不新鲜了,真正值得看的,是它把 AI 任务拆成了另一种形式。
游戏会先根据当前棋盘,生成 5 个可以选择的落点,并说明每种选择可能带来的结果,例如能不能消除一行、会不会留下空隙。然后,这些信息通过一次 HTTP 请求发送给 Acurast 网络中的手机,由运行在手机 CPU 上的 Laya 模型选出一个方案,再把结果返回给游戏。
整个过程可以概括成一句话:软件负责生成选项,AI 负责做决定,手机负责完成计算。
Laya 也不是我们常见的聊天大模型。它属于 System One 决策模型,不负责写长文,也不需要进行复杂推理,而是在几个已经给出的选项中快速选择,并返回每个选项对应的概率。
根据 Acurast 公布的数据,这类短决策在手机 CPU 上通常需要大约 0.2—1 秒。除了俄罗斯方块,官方还做了 Snake、Doom、邮件分类、聊天审核和提示词注入检测等 9 个演示。每次回答都来自网络中的真实手机,页面还会显示设备所在国家、芯片型号和已经处理的决策次数,并提供链上记录供用户查看。
我觉得这个方向比“让手机硬扛一个超大模型”实际得多。
现实里的 AI 任务,并不全都需要生成几千字内容。钱包判断一笔授权是否符合用户规则、交易聚合器在几条路径中选择成本更低的一条、链上智能体决定下一步执行哪个操作,这些任务往往都有明确的候选项。
软件可以先计算出所有合法方案,小模型再根据用户设定的规则进行选择,最终结果继续经过独立检查。这样一来,AI 不必完成所有计算,也不能随意执行候选范围之外的操作。
当然,这类模型远远谈不上万能。
Acurast 的邮件分类测试中,Laya 判断正确了160封邮件中的144封,准确率约为90%。新闻分类演示可以判断一个标题像不像标题党,却无法判断内容是否真实;聊天速度太快时,审核队列也会逐渐变长。模型给出的概率同样不能直接当成可靠的“信心值”。
所以更合适的定位,可能是一个速度快、成本低的第一层过滤器,而不是替人作出最终决定。
官方目前给出的参考成本是,运行一套自己的 Laya 实例每天不到 1枚 $ACU ,实际费用和可用性仍会受到配置及网络状况影响。这个数字本身未必最重要,更值得注意的$ACU 在这里对应的不是一句抽象叙事,而是一次可以被调用、计费和验证的真实计算服务。
AI 的下一阶段未必只是训练越来越大的模型。大量真正进入产品的需求,可能只是一次分类、一次筛选或者一次很小的决定。
如果这些不起眼却高频的任务,能够交给分布在世界各地的手机处理,那么 Acurast 想提供的就不只是“便宜算力”,而是一套适合轻量 AI 决策的分布式执行环境。
如果一部闲置手机可以替你处理一种小型 AI 任务,你最希望它先做什么?
本文仅为个人对项目技术和应用场景的观察,不构成任何投资建议。