最近翻 @Acurast 的 NodeGhost 技术案例,看到一个挺有意思的测试结果。
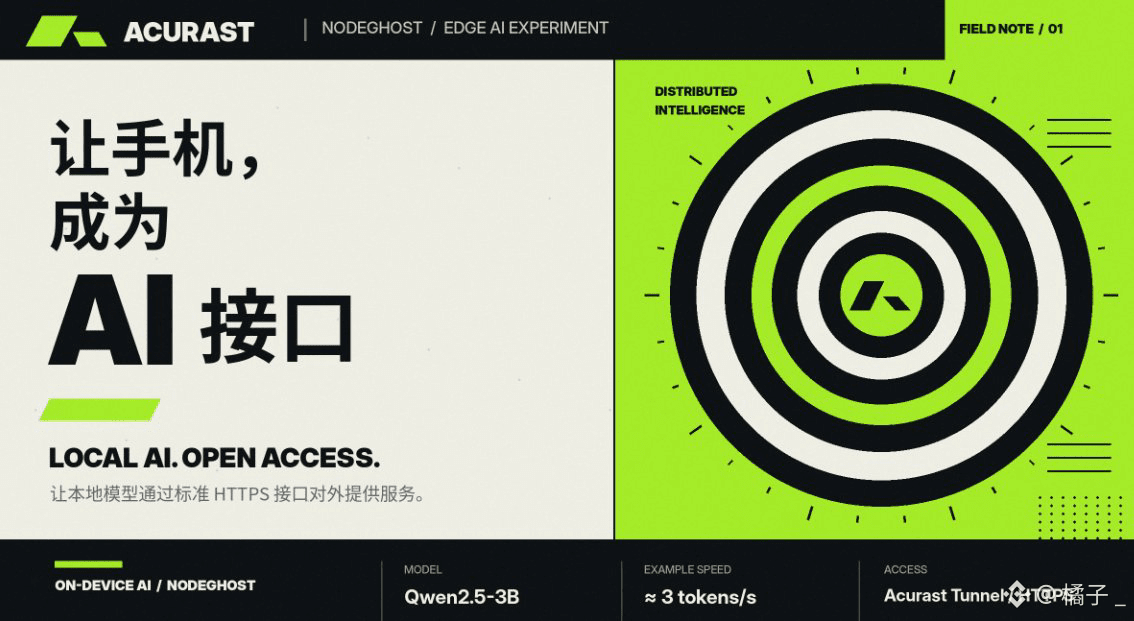
一台手机运行量化后的 Qwen2.5-3B 模型,生成速度大约每秒 3 个 Token。
回答 120 Token 左右的问题,需要约 45 秒
放在今天的大模型体验里,这速度确实有点慢。
但让我关注这个案例的,是另一处设计
通过 Acurast Tunnel,原本藏在手机本地、没有公网 IP 的模型,可以对外提供 HTTPS 接口。
再接入 NodeGhost 的兼容 OpenAI API,开发者原有的调用方式几乎不用改,就能把请求发送到手机上执行。
这样一来,手机不再只是网络里被动等待分配任务的 Processor,也可以对外提供标准化的 AI 推理服务。
当然,目前这个案例还是 Canary 网络上的参考实现,速度和复杂推理能力都有明显限制。
但我觉得它已经回答了一个很实际的问题:
如果开发者想把自己的模型部署在分布式手机上,现有应用能不能方便地调用?
至少这条技术路径已经有可运行的例子。
至于商业化,还需要继续验证延迟、并发、成本和长期稳定性。
Acurast 的 $ACU 负责连接网络使用和算力激励,但最终能否吸引付费需求,还得看这些应用有没有实际竞争力。
一台手机运行量化后的 Qwen2.5-3B 模型,生成速度大约每秒 3 个 Token。
回答 120 Token 左右的问题,需要约 45 秒
放在今天的大模型体验里,这速度确实有点慢。
但让我关注这个案例的,是另一处设计
通过 Acurast Tunnel,原本藏在手机本地、没有公网 IP 的模型,可以对外提供 HTTPS 接口。
再接入 NodeGhost 的兼容 OpenAI API,开发者原有的调用方式几乎不用改,就能把请求发送到手机上执行。
这样一来,手机不再只是网络里被动等待分配任务的 Processor,也可以对外提供标准化的 AI 推理服务。
当然,目前这个案例还是 Canary 网络上的参考实现,速度和复杂推理能力都有明显限制。
但我觉得它已经回答了一个很实际的问题:
如果开发者想把自己的模型部署在分布式手机上,现有应用能不能方便地调用?
至少这条技术路径已经有可运行的例子。
至于商业化,还需要继续验证延迟、并发、成本和长期稳定性。
Acurast 的 $ACU 负责连接网络使用和算力激励,但最终能否吸引付费需求,还得看这些应用有没有实际竞争力。