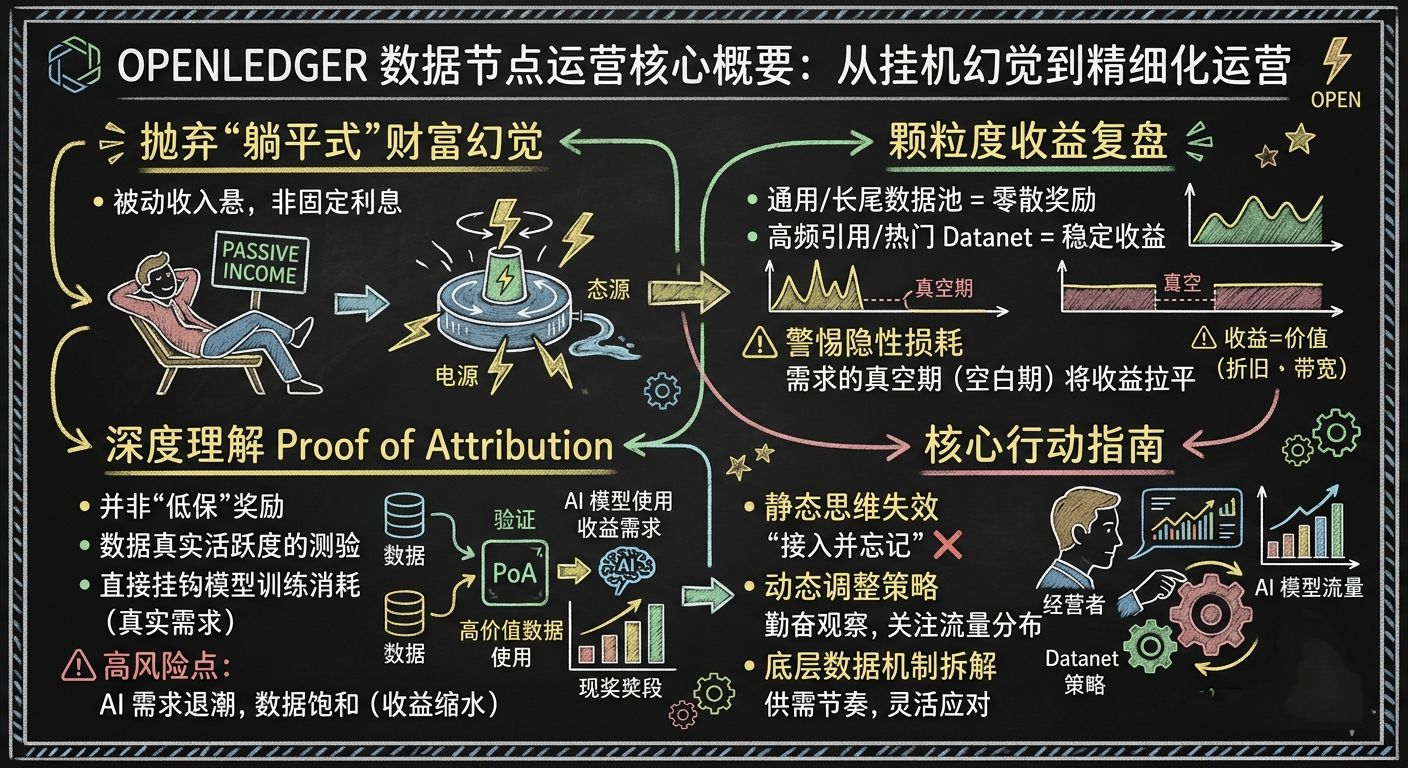
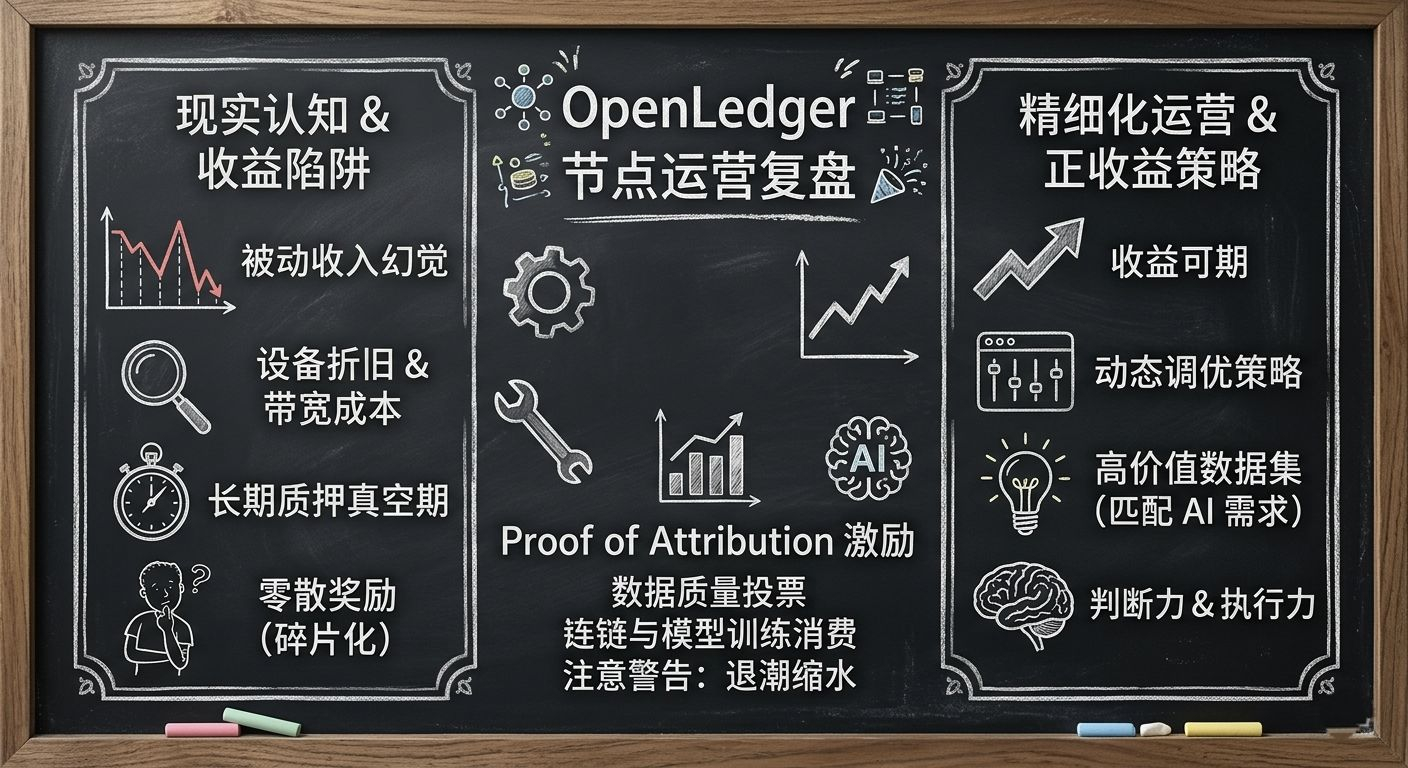
最近我又加码了几台设备投入到 @OpenLedger 的生态中,深度复盘了这段时间Datanet的颗粒度收益,心态反而比刚入局时沉稳了不少。很多人把 AI 数据节点想得太简单,觉得只要挂上机、账户里的$OPEN 就会源源不断地自动增长,这种躺平式的财富幻觉,实际上是很多入局者的白日梦。
我翻看了一下前期的交互记录,单纯为了追求挂机时长而接入那些长尾、冷门的数据池,其带来的碎片化奖励在剔除掉电费和网络损耗后,ROI几乎低得惊人。很多人被所谓的空投预期冲昏了头,却忽略了这种低质量数据在 AI 训练语境下其实根本没有议价权,充其量只是在为协议贡献一些无效的负载。真正想在OpenLedger里建立长效的收益模型,核心在于对数据资产化的理解。你必须明白,节点不仅是一个物理终端,更是一个需要动态调优的数据门户。我通过对比发现,那些能够稳定产生收益的节点,无一例外都是精准匹配了当前主流模型训练需求的 Datanet。这里有一个巨大的认知鸿沟:多数人只看当下的 APY,而忽略了 AI 训练算力需求是存在阶梯式波动的。如果你没有在需求波峰前做好数据缓存的布局,那么你的带宽和存力在大部分时间里其实都是在无效空转。
再聊#OpenLedger 备受关注的激励机制。通过长时间的观察,我深刻意识到,所谓的收益分配,本质上是生态系统对于高价值数据集的即时定价。如果你的数据不能直接命中大模型微调或检索增强生成的关键路径,那么无论你的节点在线时间有多长,奖励机制都会通过算法权重将其过滤掉。
我说白了,在$OPEN 的赛道里,静态的配置策略已经彻底失效。未来的盈利空间,只属于那些真正把节点当成数据工厂去精细化运营的人。记住,OpenLedger奖励的从来不是你的设备在线时长,而是你作为数据供应者,对这场 AI 变革浪潮的判断力与执行力
我翻看了一下前期的交互记录,单纯为了追求挂机时长而接入那些长尾、冷门的数据池,其带来的碎片化奖励在剔除掉电费和网络损耗后,ROI几乎低得惊人。很多人被所谓的空投预期冲昏了头,却忽略了这种低质量数据在 AI 训练语境下其实根本没有议价权,充其量只是在为协议贡献一些无效的负载。真正想在OpenLedger里建立长效的收益模型,核心在于对数据资产化的理解。你必须明白,节点不仅是一个物理终端,更是一个需要动态调优的数据门户。我通过对比发现,那些能够稳定产生收益的节点,无一例外都是精准匹配了当前主流模型训练需求的 Datanet。这里有一个巨大的认知鸿沟:多数人只看当下的 APY,而忽略了 AI 训练算力需求是存在阶梯式波动的。如果你没有在需求波峰前做好数据缓存的布局,那么你的带宽和存力在大部分时间里其实都是在无效空转。
再聊#OpenLedger 备受关注的激励机制。通过长时间的观察,我深刻意识到,所谓的收益分配,本质上是生态系统对于高价值数据集的即时定价。如果你的数据不能直接命中大模型微调或检索增强生成的关键路径,那么无论你的节点在线时间有多长,奖励机制都会通过算法权重将其过滤掉。
我说白了,在$OPEN 的赛道里,静态的配置策略已经彻底失效。未来的盈利空间,只属于那些真正把节点当成数据工厂去精细化运营的人。记住,OpenLedger奖励的从来不是你的设备在线时长,而是你作为数据供应者,对这场 AI 变革浪潮的判断力与执行力