A agregação dos rankings pode elevar a pontuação média das previsões, mas não elimina os erros científicos compartilhados.
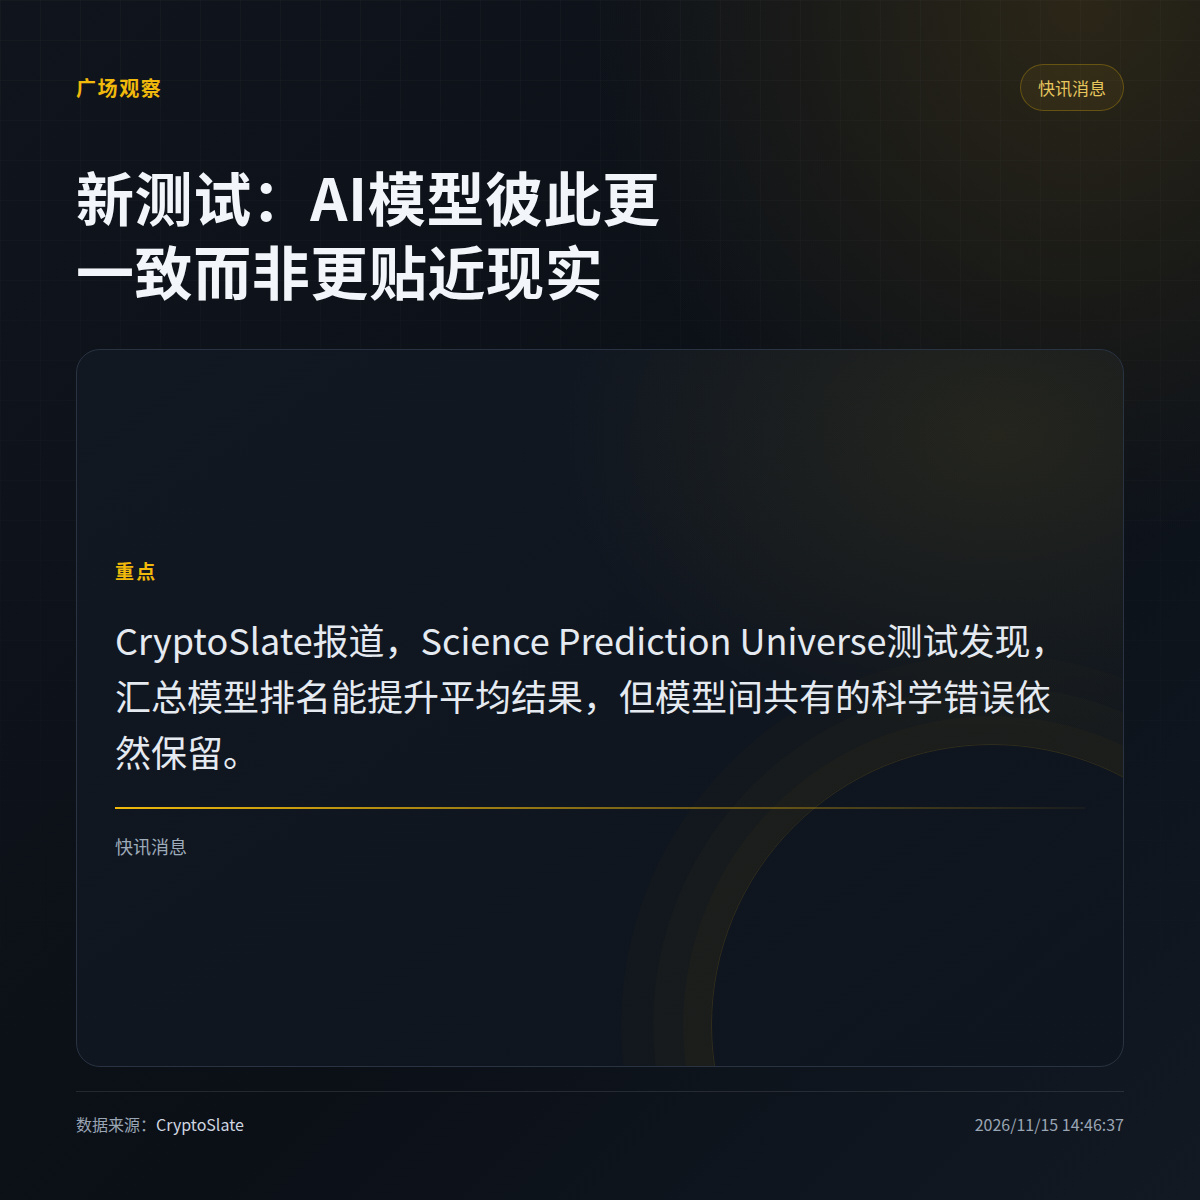
O teste relatado pela CryptoSlate chama-se Science Prediction Universe: ao agregar os resultados dos rankings de vários modelos de IA, o desempenho médio melhorou; porém, os erros científicos compartilhados entre os modelos não desapareceram. Os modelos concordaram mais entre si do que corresponderam à realidade.
· A agregação melhora apenas a pontuação média; não corrige automaticamente os erros compartilhados pela maioria dos modelos.
· O teste abrange cenários de previsões científicas, mas a reportagem não informa o número de modelos nem dados específicos sobre os erros.
Se você fosse projetar esse teste, começaria analisando os vieses de cada modelo ou o consenso entre eles?
O teste relatado pela CryptoSlate chama-se Science Prediction Universe: ao agregar os resultados dos rankings de vários modelos de IA, o desempenho médio melhorou; porém, os erros científicos compartilhados entre os modelos não desapareceram. Os modelos concordaram mais entre si do que corresponderam à realidade.
· A agregação melhora apenas a pontuação média; não corrige automaticamente os erros compartilhados pela maioria dos modelos.
· O teste abrange cenários de previsões científicas, mas a reportagem não informa o número de modelos nem dados específicos sobre os erros.
Se você fosse projetar esse teste, começaria analisando os vieses de cada modelo ou o consenso entre eles?