
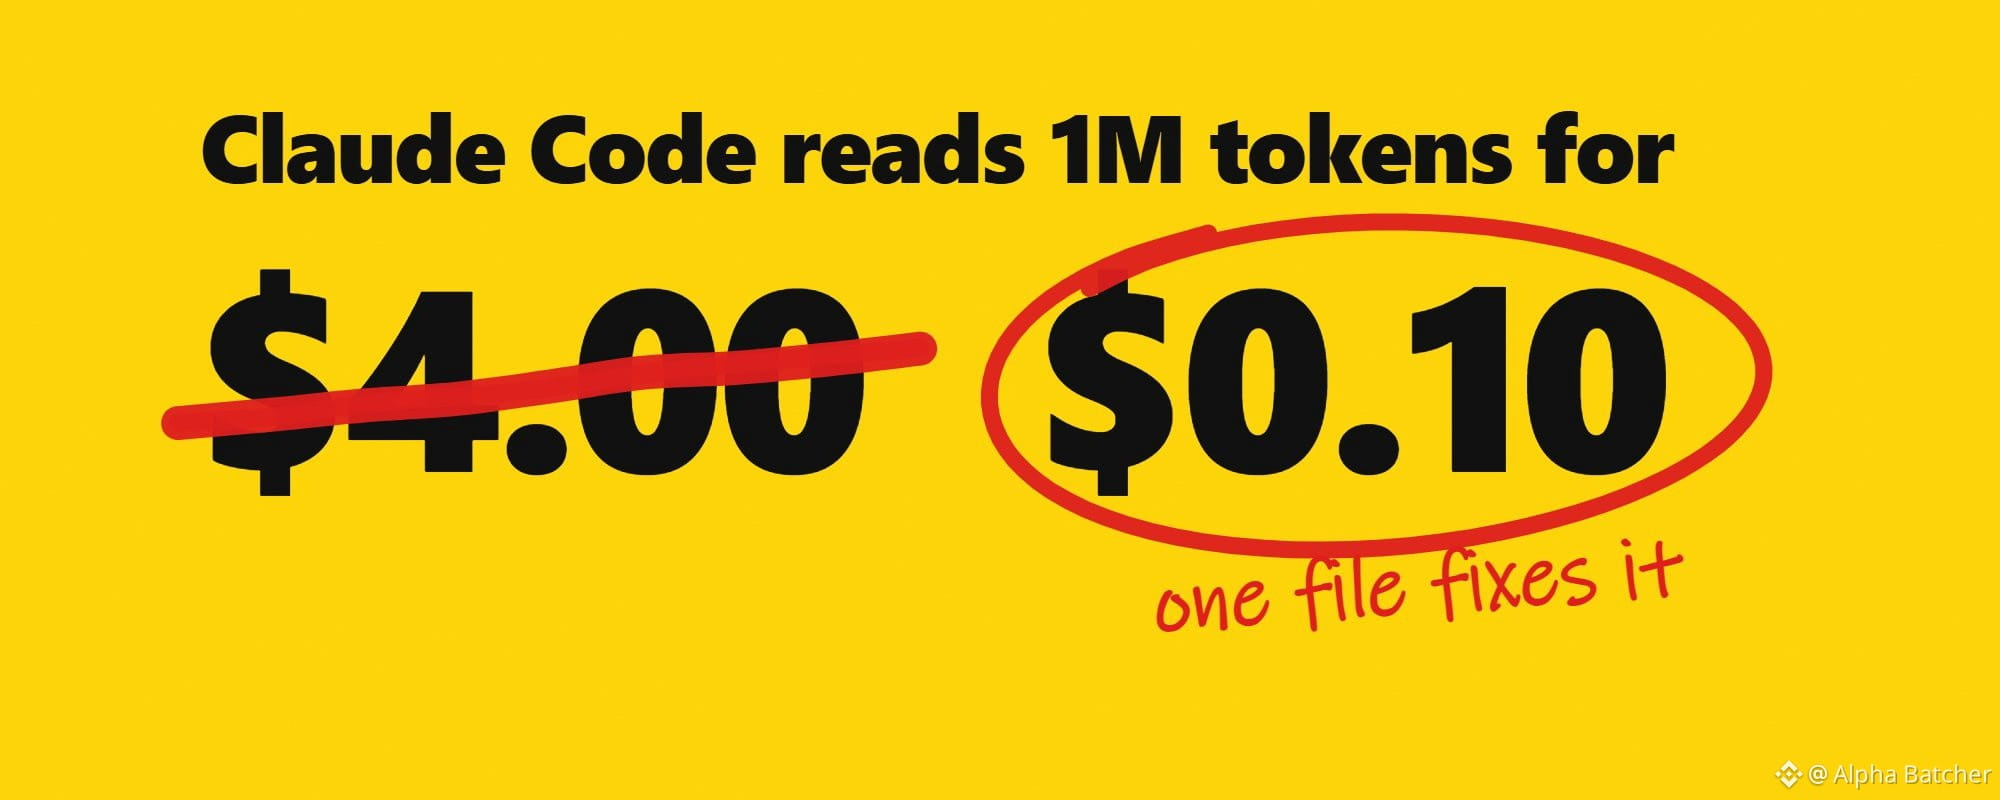

O Claude Code agora lê seus arquivos no Opus.
O subagente Explore integrado, que o Claude usa para pesquisar sua base de código, antes era executado no Haiku. Nas versões atuais, ele é executado no modelo da sua sessão. Na configuração padrão, esse modelo é o Opus 5.5: US$ 4 por milhão de tokens de entrada, contra US$ 0,10 no Haiku 5.5.
essa é uma configuração. A Anthropic publicou os números por trás do restante no guia de 9 de novembro sobre como escolher um modelo Claude e em uma publicação de setembro sobre quanto custa uma tarefa no Opus 5.5:
• Todas as tarefas com baixo esforço, repetindo apenas as que falharam com esforço alto, concluíram cerca de 97% das tarefas a US$ 0,17 cada. Todas as tarefas com esforço alto concluíram 95,3% a US$ 0,29.
• um líder Opus com até 25 agentes Sonnet custou cerca de um terço a menos do que Opus sozinho, com uma pontuação semelhante.
• com uma chave de API, uma pausa de 6 minutos para um café, com 120K tokens de contexto, transforma a próxima leitura de cache de $0.02 numa escrita de $0.60.
• num benchmark de 20 problemas, 2 problemas representaram 43% dos gastos.
este curso transforma esses números em definições. cada capítulo termina com algo que pode colar no Claude Code, e gastará menos depois de cada um:
• para onde vai o dinheiro: turnos, cache, saída e modelo
• coloque Explore e os outros leitores no Haiku
• defina o esforço antes de trocar de modelo
• mantenha o cache aquecido
• envie menos em cada turno
• escolha o modelo de acordo com a tarefa
• um líder e agentes baratos
• avalie-o no seu próprio trabalho
se só tiver 30 segundos, estas 5 linhas resumem todo o curso:
crie um subagente chamado Explore com model: haiku e coloque no Haiku todos os subagentes que apenas leem.
comece com esforço medium. execute lotes em low e repita apenas as falhas em high.
com uma chave de API, faça a compactação antes da pausa, nunca depois.
mantenha CLAUDE.md abaixo de 200 linhas e desligue os servidores MCP que não utiliza.
mantenha Opus para as decisões e as edições de código, e consulte /usage depois de cada tarefa real.
para onde vai o dinheiro
uma tarefa do Claude Code é um ciclo: ler a conversa, chamar uma ferramenta, ler o resultado e repetir. cada volta do ciclo é um pedido, e 4 coisas determinam o preço.
• turnos. cada turno reenvia a conversa inteira. no exemplo da Anthropic, uma tarefa cujo contexto aumenta de 20K para 120K tokens ao longo de 40 turnos envia cerca de 2,8M de tokens de entrada. a mesma tarefa em 25 turnos envia cerca de 1,75M.
• leituras de cache. a maior parte do que um turno reenvia já foi enviada no turno anterior, por isso é faturada como leitura de cache: $0.20 por milhão no Opus 5.5, um vigésimo do preço de entrada de $4. esses 2,8M de tokens custam $11.20 sem cache, $1.62 com uma taxa de acerto de 90% e cerca de $0.99 com 96%.
• saída. $20 por milhão no Opus 5.5, 100 vezes o custo de uma leitura de cache. o raciocínio é faturado como saída, mesmo quando o Claude Code só lhe mostra um resumo. 60K tokens de saída custam $1.20, tanto como 6M de tokens lidos do cache.
• modelo. determina o preço de cada token, e todos os subagentes que herdam o modelo herdam também o respetivo preço.
no fim da próxima tarefa real, execute /usage e leia 3 linhas:
participação do cache: alta numa sessão longa. baixa significa uma pausa longa, uma troca de modelo ou um servidor MCP conectado a meio da sessão.
saída comparada com entrada: muita saída para uma pequena alteração significa que o esforço é demasiado elevado ou que o modelo está a tentar novamente.
entrada total comparada com o tamanho da conversa: um valor muitas vezes maior significa muitos turnos. leia a sessão e encontre o ciclo.
recebe a linha da fatura que deve corrigir primeiro.
menos turnos e um cache aquecido poupam mais do que qualquer desconto.
coloque Explore e os outros leitores no Haiku
um subagente é um assistente que o Claude inicia para uma tarefa secundária. trabalha na sua própria janela de contexto e devolve um resumo, e paga os próprios tokens ao preço do seu próprio modelo.
Subagentes integrados do Claude Code, segundo a documentação:
• Explore pesquisa na sua base de código, só para leitura. funciona com o modelo da sua sessão. quando a sessão usa Fable, Explore passa a Opus numa subscrição Claude, numa conta Anthropic Console ou num gateway, e continua a usar Fable no Bedrock, Google Cloud, Foundry, Claude Platform na AWS e num gateway de aplicações Claude.
• Plan faz pesquisa no modo de planeamento. herda o modelo da sua sessão.
• general-purpose explora e edita. também herda o modelo.
um ficheiro chamado Explore na sua pasta de agentes substitui o integrado e mantém o seu próprio modelo. o guia da Anthropic recomenda fazer exatamente isso.
guarde isto como ~/.claude/agents/Explore.md para todos os projetos, ou como .claude/agents/Explore.md para um só:
---
name: Explore
description: Agente rápido de pesquisa, só de leitura, para procurar e compreender uma base de código. Use-o para encontrar ficheiros, pesquisar código e responder a perguntas como «onde está isto?».
tools: Read, Grep, Glob
model: haiku
omitClaudeMd: true
---
Pesquise e leia apenas. Nunca crie nem edite ficheiros. Responda com caminhos de ficheiros, números de linha e um breve resumo do que encontrou.
omitClaudeMd inicia-o sem o seu CLAUDE.md, tal como o Explore integrado. reinicie o Claude Code se a pasta agents ainda não existia, e execute claude update: na API da Anthropic, o alias haiku aponta para Haiku 5.5 a partir da versão v2.1.293. no Bedrock, Google Cloud, Foundry e Claude Platform na AWS, continua a significar Haiku 4.5.
faça o mesmo com todos os assistentes que apenas leem registos, resultados de testes ou resultados de pesquisas. este é um exemplo da própria Anthropic:
---
name: log-reader
description: Lê resultados de testes e registos e comunica cada caso que falhou. Use após executar os testes.
tools: Read, Grep, Glob, Bash
model: haiku
---
Leia os registos fornecidos. Para cada falha, indique o ficheiro, o nome do teste e a primeira linha do erro. Não edite nenhum ficheiro.
para colocar todos os subagentes no mesmo modelo, defina a variável de ambiente CLAUDE_CODE_SUBAGENT_MODEL. um modelo indicado no ficheiro de um subagente tem precedência sobre a variável.
mantenha as edições de código e as decisões de julgamento no seu modelo principal. um modelo pequeno que interpreta mal um resultado de pesquisa leva o principal ao ficheiro errado, e o principal paga pelo desvio.
paga $0.10 por milhão de tokens de entrada para ler pesquisas, registos e resultados de testes, em vez de $4. execute /tasks na próxima vez que o Claude delegar uma tarefa e verá que modelo cada subagente está a usar.
um ficheiro por leitor, e a leitura deixa de custar preços de Opus.
defina o esforço antes de trocar de modelo
o esforço determina quanto o modelo pensa, escreve e usa ferramentas em cada turno. Opus 5.5 tem os níveis low, medium, high e xhigh, além de max para uma única sessão. medium é a predefinição no Claude Code.
A Anthropic mediu-o num subconjunto do SWE-bench Pro com Opus 5.5:
• medium: cerca de 2,5 pontos abaixo de high, por cerca de 70% do custo.
• low: cerca de 8 pontos abaixo de high, por cerca de um terço do custo.
• xhigh: cerca de 1,4 pontos acima de high, por 2,5 vezes o custo.
depois, a execução que superou todas as outras: tudo em low, e apenas as falhas repetidas em high. cerca de 97% das tarefas concluídas a $0.17 cada, contra 95,3% a $0.29 com todas as tarefas em high.
só funciona quando o Claude consegue verificar o próprio trabalho: um teste, uma compilação ou um script que chama o endpoint. uma verificação custa um turno e a respetiva saída. mais esforço acrescenta pensamento a cada turno.
quando um modelo não é suficientemente bom, o guia da Anthropic recomenda esta ordem:
1. dê-lhe uma forma de verificar o próprio trabalho.
2. aumente o esforço um nível.
3. passe para o modelo seguinte, usando um nível de esforço inferior ao que usou no modelo mais pequeno.
para um lote de tarefas, execute /effort low e cole:
faça todas as tarefas em todo.md, uma de cada vez. depois de cada uma, execute o respetivo teste. escreva em failed.md as tarefas cujos testes falharem, incluindo a primeira linha do erro. não altere nada fora deste repositório e não envie nada.
depois execute /effort high e cole:
refaça apenas as tarefas em failed.md e execute novamente os respetivos testes. diga-me quais continuam a falhar. não envie nada.
obtém uma primeira passagem barata por tudo, e o esforço high é usado apenas onde a primeira passagem falhou.
com uma chave de API ou uma subscrição, alterar o esforço mantém o cache. no Bedrock, Google Cloud's Agent Platform ou num gateway, limpa o cache; por isso, faça a alteração durante uma pausa.
low primeiro, high nas falhas, e só paga pelo raciocínio onde ele altera o resultado.
mantenha o cache aquecido
o cache guarda a parte da conversa que o Claude Code não precisa de reenviar ao preço integral. no Opus 5.5, uma leitura de cache custa 5% de um token de entrada novo. uma escrita de cache custa 1,25 vezes o preço de entrada para um cache de 5 minutos, e 2 vezes para uma hora.
o tempo de validade depende da forma de pagamento: uma hora numa subscrição Claude, 5 minutos com uma chave de API ou um fornecedor cloud, e 5 minutos quando uma subscrição começa a usar créditos de utilização.
é aí que entra a pausa para o café. com 120K tokens de contexto, uma leitura custa cerca de $0.02 e uma escrita nova de 5 minutos cerca de $0.60. faça uma pausa de 6 minutos com uma chave de API, e o seu próximo turno paga a escrita.
estas situações também fazem com que o próximo turno pague uma escrita:
• trocar de modelo: o novo modelo começa com o cache vazio.
• ligar ou desligar um servidor MCP a meio da sessão.
• ativar o modo rápido pela primeira vez numa conversa.
• compactação, que reescreve o histórico com o qual o cache correspondia.
• alterar o esforço no Bedrock, Google Cloud's Agent Platform ou num gateway.
configure tudo isso quando a sessão começar e não altere nada enquanto estiver a trabalhar.
faça a compactação numa pausa natural, enquanto o cache ainda está aquecido. com 150K tokens, um /compact custa cerca de $0.25 e poupa cerca de $0.025 em cada turno seguinte, por isso compensa ao fim de cerca de 10 turnos. depois de uma pausa mais longa do que a validade do cache, o mesmo /compact volta a ler a conversa toda: cerca de $0.75 com 150K.
/clear não custa nada, por isso use-o entre tarefas sem relação. /rewind volta a um turno anterior que ainda esteja em cache, quando quiser descartar um caminho.
antes de se afastar, cole:
/compact mantenha os nomes dos testes que falharam, os ficheiros que alterámos e o próximo passo
quando voltar, terá uma conversa curta que continua em cache.
faça a compactação antes da pausa para o café, nunca depois.
envie menos em cada turno
cada turno reenvia tudo o que veio antes. com 20K tokens de contexto, uma leitura de cache por turno custa cerca de $0.004 no Opus 5.5. com 150K, custa cerca de $0.03; assim, 30 turnos gastam $0.90 apenas em leituras, contra cerca de $0.12 com 20K.
3 coisas são carregadas antes de escrever:
• CLAUDE.md é carregado em todas as sessões e reenviado em cada turno. a documentação de custos da Anthropic recomenda mantê-lo abaixo de 200 linhas.
• Servidores MCP. no início, são carregados apenas os nomes das ferramentas e as instruções do servidor; a definição completa é carregada quando a ferramenta é usada. execute /mcp e desligue os servidores que não utiliza.
• Instruções antigas. prompts escritos para um modelo anterior podem fazer o Opus 5.5 escrever mais e repetir chamadas de ferramentas. no benchmark de suporte de 44 pedidos da Anthropic, passar do Opus 4.8 para o Opus 5.5 com esforço low reduziu o custo em cerca de 18%, e o comando /claude-api prompt-audit do Claude Code reduziu-o mais 9%.
execute /claude-api prompt-audit primeiro e depois cole:
leia o meu CLAUDE.md e todos os ficheiros que importa. proponha uma versão com menos de 200 linhas: mantenha os comandos para compilar e testar, as regras que o Claude não consegue aprender a partir do código e tudo o que já causou problemas. mova o resto para docs/ e crie uma ligação para lá a partir do CLAUDE.md. mostre-me as diferenças e não altere nada até eu autorizar.
fica com um CLAUDE.md mais curto, sem as instruções ritualísticas antigas, e uma lista de servidores para desligar.
um contexto curto torna cada um dos seus turnos mais barato.
escolha o modelo de acordo com a tarefa
preços por milhão de tokens:
• Haiku 5.5: $0.10 de entrada, $0.50 de saída para prompts até 100K tokens; $0.50 e $2.50 acima disso.
• Sonnet 5.5: $2 de entrada, $10 de saída.
• Opus 5.5: $4 de entrada, $20 de saída.
• Fable 5.2: $8 de entrada, $40 de saída.
Recomendações iniciais da Anthropic:
• Haiku 5.5: classificação, encaminhamento, extração e subagentes que pesquisam ficheiros, leem registos ou fazem resumos.
• Sonnet 5.5: programação bem delimitada, como correções de erros e funcionalidades implementadas de acordo com uma especificação; conversas; documentos do dia a dia; e tarefas de agentes executadas repetidamente.
• Opus 5.5 em medium: engenharia e depuração do dia a dia, e tudo aquilo de que não tem a certeza. é a predefinição do Claude Code.
• Fable 5.2: grandes refatorações e migrações, arquitetura, investigação aprofundada e coordenação de muitos subagentes. passe para ele quando Opus 5.5 em high ainda não for suficiente.
um preço mais elevado por token nem sempre significa um preço mais elevado por tarefa. no FrontierCode 2.0, Fable 5.2 em high obteve uma pontuação semelhante à do Opus 5.5 em max, 45,3% contra 45,5%, por cerca de metade do custo por tarefa. antes de levar Opus além de high numa tarefa difícil, experimente Fable com menos esforço.
troque de modelo numa pausa natural. o cache pertence ao modelo que o criou, por isso o primeiro turno com um modelo novo paga a escrita de toda a conversa. execute /compact primeiro ou comece de novo com um plano escrito curto.
o alias opusplan faz o planeamento com Opus e deixa Sonnet fazer as edições. isso coloca as alterações ao código no modelo mais barato, ao contrário da configuração de leitores acima; por isso, meça o resultado nas suas próprias tarefas antes de o tornar a predefinição.
cole:
leia todo.md. para cada tarefa, indique o modelo e o nível de esforço inicial recomendado: Haiku para pesquisas rápidas e leitura de registos, Sonnet para correções bem delimitadas de acordo com uma especificação, Opus em medium para o trabalho do dia a dia e tudo o que não estiver claro, Fable para migrações, grandes refatorações e trabalho que coordene muitos subagentes. guarde routing.md com uma linha por tarefa e a respetiva justificação. não altere nenhuma definição.
obtém routing.md: um modelo e um nível de esforço para cada tarefa antes de começar.
Opus por predefinição, Haiku para leitura, Fable quando Opus em high não for suficiente.
um líder e agentes baratos
quando uma tarefa não couber numa única janela de contexto, coloque o modelo mais forte no comando e atribua partes do trabalho a modelos mais baratos.
num benchmark interno que pesquisou cerca de 22 milhões de tokens de código-fonte à procura de defeitos, um líder Opus 5.5 com agentes Sonnet 5.5, até 25 de cada vez, custou cerca de um terço menos do que Opus 5.5 sozinho no nível de esforço predefinido e obteve uma pontuação semelhante.
não use esta abordagem quando o trabalho consistir numa cadeia de passos dependentes ou couber numa única janela de contexto. nesses casos, o planeamento e a integração custam mais do que poupam.
mantenha as equipas pequenas. as equipas de agentes, uma funcionalidade experimental, executam cada colega como uma instância própria do Claude Code, e a documentação de custos da Anthropic estima que uma equipa usa cerca de 7 vezes mais tokens do que uma sessão normal quando os colegas trabalham em modo de planeamento. desligue cada colega quando terminar a sua parte.
a ferramenta de aconselhamento combina um executor barato com um consultor mais potente a quem pode pedir ajuda. na tabela da própria Anthropic, nenhum dos 4 pares superou claramente o executor sozinho; por isso, meça a frequência com que o executor pede ajuda antes de pagar por um consultor.
cole:
divida [a tarefa] em partes independentes, cada uma com espaço para caber numa janela de contexto. você é o líder: escreva o plano em plan.md, depois atribua cada parte a um subagente Sonnet, indicando a lista de ficheiros que pode alterar, e integre o trabalho devolvido. nenhuma parte pode editar o mesmo ficheiro que outra. execute os testes após cada integração. mostre-me plan.md antes de iniciar qualquer subagente.
obtém plan.md, as partes feitas em paralelo com Sonnet e Opus dedicado ao plano e à integração.
o líder decide, e os agentes leem e escrevem.
avalie-o no seu próprio trabalho
todos os números acima vêm das execuções da Anthropic. os seus dependem da sua base de código e dos seus hábitos.
• /usage no fim de uma tarefa mostra os tokens, a participação do cache e um custo estimado em dólares ao preço de tabela. /cost faz o mesmo. num plano Pro, Max, Team ou Enterprise, o valor em dólares dá uma ideia da quantidade de trabalho que fez, e o mesmo ecrã mostra as barras de utilização.
• /effort status mostra o seu nível de esforço, e /tasks mostra que modelo cada subagente usa.
• para uma equipa, a API Claude Code Analytics fornece o custo estimado por utilizador, e a API Usage and Cost discrimina os gastos por modelo e por tokens em cache e fora do cache.
• referência da documentação de custos da Anthropic: cerca de $13 por programador por dia ativo em implementações empresariais, e menos de $30 por dia para 90% dos utilizadores.
escolha uma tarefa real da sua lista de pendências e execute-a com 2 configurações. cole isto uma vez para cada configuração:
estou a comparar 2 configurações na mesma tarefa. a tarefa: [tarefa]. faça-a, execute o respetivo teste e, quando terminar, diga-me quantos turnos usou e o que teria reduzido esse número. não envie nada.
depois de cada execução, consulte /usage, depois /clear, troque com /model ou /effort e cole novamente.
obtém o seu próprio custo por tarefa para cada configuração.
o valor do seu próprio /usage é aquele em que deve confiar.
uma única instrução configura os leitores Haiku, um CLAUDE.md mais curto e o encaminhamento dos modelos. abra o Claude Code no seu repositório e cole:
ajude-me a gastar menos no Claude Code, um passo de cada vez. depois de cada passo, mostre-me a alteração e aguarde que eu diga «avançar».
1. crie ~/.claude/agents/Explore.md: name Explore, uma descrição que indique que é um agente rápido de pesquisa, só de leitura, tools Read, Grep, Glob, model: haiku, omitClaudeMd: true e um corpo que diga para pesquisar e ler apenas, sem nunca criar nem editar ficheiros.
2. crie .claude/agents/log-reader.md com model: haiku. lê resultados de testes e registos e comunica cada falha com o ficheiro, o nome do teste e a primeira linha do erro, sem nunca editar ficheiros.
3. leia CLAUDE.md e todos os ficheiros que importa e proponha uma versão com menos de 200 linhas. mova o resto para docs/.
4. liste os servidores MCP na minha configuração e assinale os que este repositório nunca utiliza.
5. leia todo.md e crie routing.md com um modelo e um nível de esforço inicial para cada tarefa.
não altere outras definições, não envie nada e não apague nada sem perguntar.
depois de colar a instrução, terá:
• Explore e um leitor de registos no Haiku.
• um CLAUDE.md com menos de 200 linhas, e o restante em docs/.
• uma lista de servidores MCP para desligar.
• routing.md: um modelo e um nível de esforço para cada tarefa.
a configuração numa página
EXPLORE ~/.claude/agents/Explore.md, model: haiku, omitClaudeMd: true.
LEITORES subagentes de leitura de registos e pesquisa no haiku. as edições de código ficam no modelo principal.
ESFORÇO medium por predefinição. lotes em low, falhas repetidas em high.
VERIFICAÇÃO um teste ou uma compilação que o Claude possa executar, antes de aumentar o esforço.
CACHE subscrição: 1 hora; chave de API: 5 minutos. /compact antes de uma pausa.
CONTEXTO CLAUDE.md com menos de 200 linhas. servidores MCP não utilizados desligados.
MODELO haiku para leitura, sonnet para trabalho delimitado, opus no dia a dia, fable para os casos mais difíceis.
EQUIPAS líder Opus + agentes Sonnet apenas quando o trabalho não couber numa janela de contexto.
VERIFICAR /usage após tarefas reais, /tasks para ver os modelos dos subagentes.
guarde uma captura de ecrã disto.
esta noite, guarde o ficheiro Explore, reinicie o Claude Code e execute /tasks na próxima vez que ele pesquisar o seu código.