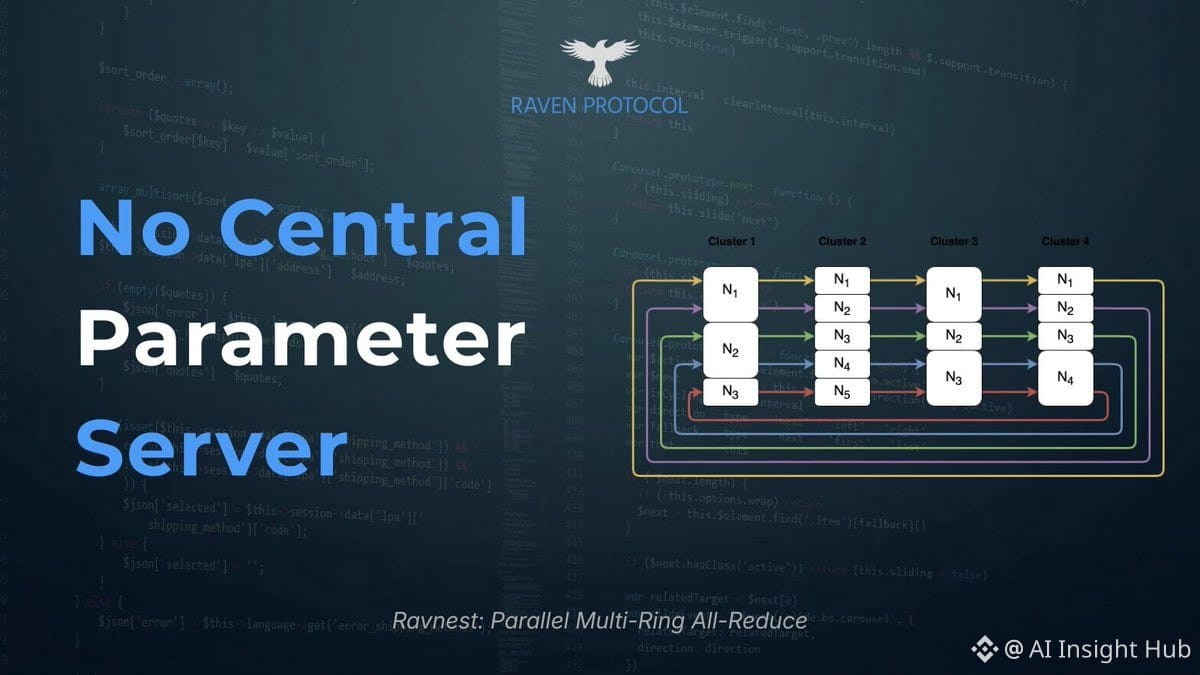
O all-reduce em anel permite que os nós de treinamento distribuído sincronizem gradientes sem um servidor central de parâmetros. Em vez de criar um gargalo em uma única máquina, cada nó passa os dados para o nó vizinho em uma topologia em anel.
Como funciona: o nó A envia para B, B para C e C de volta para A. Cada nó reduz (calcula a média dos) gradientes recebidos junto com os seus próprios e, em seguida, os encaminha. Após N etapas em um anel com N nós, todos têm a média global.
A novidade da Ravnest: all-reduce paralelo com múltiplos anéis. Execute vários anéis simultaneamente no mesmo cluster. O espaço de parâmetros é dividido em blocos, e cada bloco tem seu próprio anel. Isso reduz as rodadas de comunicação e escala melhor quando há mais de 100 workers.
Por que isso importa: treinamento de modelos grandes em hardware convencional, sem precisar de uma infraestrutura na escala da AWS. Não há um único ponto de falha e o uso da largura de banda é melhor do que em uma topologia em estrela.
Como funciona: o nó A envia para B, B para C e C de volta para A. Cada nó reduz (calcula a média dos) gradientes recebidos junto com os seus próprios e, em seguida, os encaminha. Após N etapas em um anel com N nós, todos têm a média global.
A novidade da Ravnest: all-reduce paralelo com múltiplos anéis. Execute vários anéis simultaneamente no mesmo cluster. O espaço de parâmetros é dividido em blocos, e cada bloco tem seu próprio anel. Isso reduz as rodadas de comunicação e escala melhor quando há mais de 100 workers.
Por que isso importa: treinamento de modelos grandes em hardware convencional, sem precisar de uma infraestrutura na escala da AWS. Não há um único ponto de falha e o uso da largura de banda é melhor do que em uma topologia em estrela.