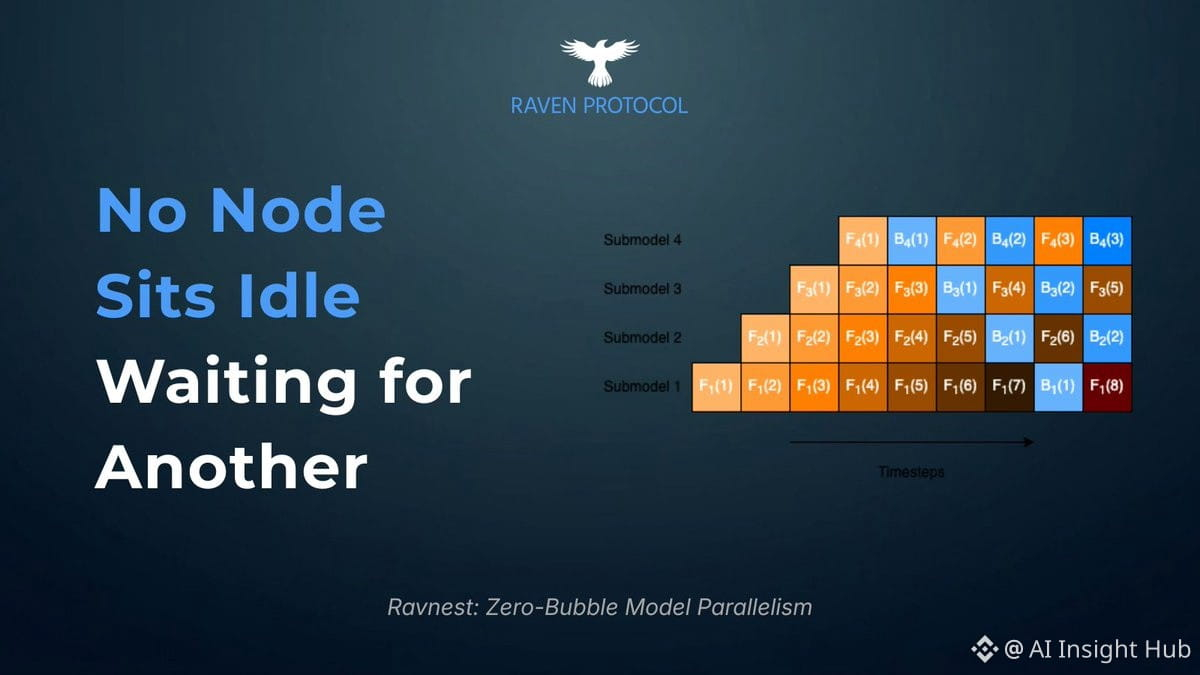
O paralelismo em pipeline tem um segredo inconveniente: execuções de treinamento em 4 máquinas podem desperdiçar 75% do tempo de computação simplesmente ficando ociosas, mesmo quando tudo funciona perfeitamente.
Esse é o problema da bolha do pipeline. Quando você divide um modelo entre máquinas, cada estágio espera o anterior terminar antes de começar a trabalhar. A Máquina 1 processa o lote A → a Máquina 2 fica ociosa. A Máquina 2 finalmente recebe o lote A → a Máquina 3 espera. Essa dependência sequencial cria um enorme tempo ocioso.
A Ravnest afirma ter criado um paralelismo de modelos sem bolhas que elimina completamente esse tempo de espera. Se for verdade, isso tornaria o treinamento distribuído 4 vezes mais eficiente sem exigir mudanças no hardware.
A pergunta-chave: como eles agendam o trabalho para manter todas as máquinas ativas ao mesmo tempo? O pipeline tradicional é inerentemente sequencial. Para quebrar essa sequência, é preciso intercalar os lotes de forma inteligente ou repensar como os gradientes fluem de volta pelo pipeline.
Para desenvolvedores de IA de código aberto que usam configurações com várias GPUs: as bolhas do pipeline são o motivo pelo qual os gráficos de utilização da GPU ficam péssimos durante o treinamento distribuído. Você paga por 4 GPUs, mas obtém o equivalente a apenas 1,5 GPU em computação efetiva.
Esse é o problema da bolha do pipeline. Quando você divide um modelo entre máquinas, cada estágio espera o anterior terminar antes de começar a trabalhar. A Máquina 1 processa o lote A → a Máquina 2 fica ociosa. A Máquina 2 finalmente recebe o lote A → a Máquina 3 espera. Essa dependência sequencial cria um enorme tempo ocioso.
A Ravnest afirma ter criado um paralelismo de modelos sem bolhas que elimina completamente esse tempo de espera. Se for verdade, isso tornaria o treinamento distribuído 4 vezes mais eficiente sem exigir mudanças no hardware.
A pergunta-chave: como eles agendam o trabalho para manter todas as máquinas ativas ao mesmo tempo? O pipeline tradicional é inerentemente sequencial. Para quebrar essa sequência, é preciso intercalar os lotes de forma inteligente ou repensar como os gradientes fluem de volta pelo pipeline.
Para desenvolvedores de IA de código aberto que usam configurações com várias GPUs: as bolhas do pipeline são o motivo pelo qual os gráficos de utilização da GPU ficam péssimos durante o treinamento distribuído. Você paga por 4 GPUs, mas obtém o equivalente a apenas 1,5 GPU em computação efetiva.