
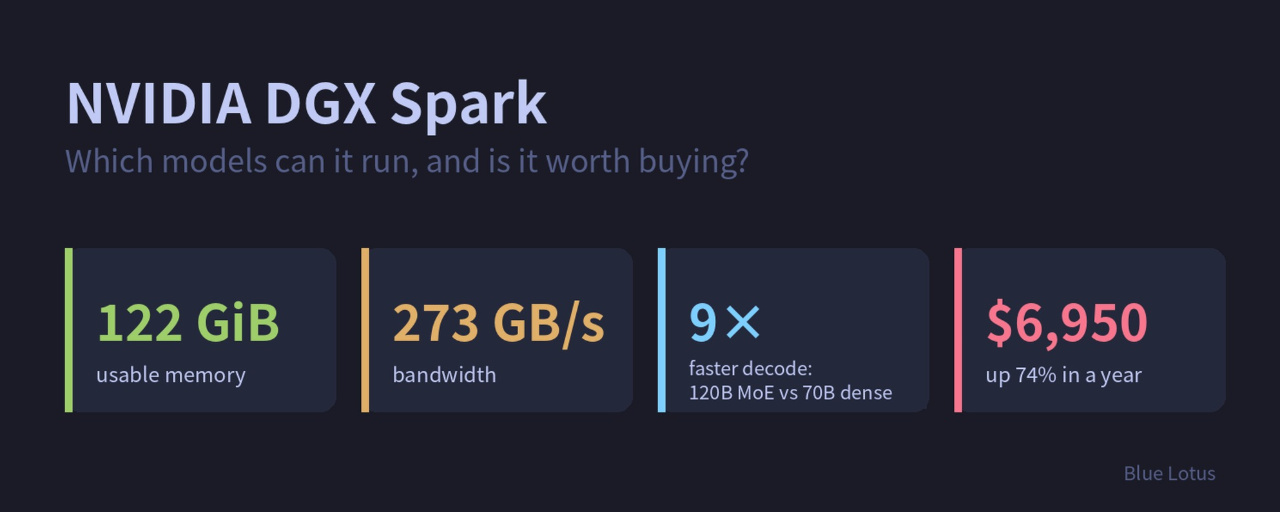
O NVIDIA DGX Spark cabe na palma da mão, e o sistema informa 121,93 GiB de memória utilizável. Esse número convida a uma conclusão tentadora: se todos os 128 GB podem ser usados como memória da GPU, então ele certamente consegue executar qualquer modelo grande que você queira?
Fazer um modelo caber na memória não significa que ele será executado rapidamente. O que essa máquina consegue fazer de fato depende de dois números, que medem coisas bem diferentes.
Dois números: capacidade e largura de banda
O DGX Spark é baseado no chip GB10 da NVIDIA. A CPU e a GPU compartilham um único conjunto de 128 GB de memória LPDDR5x e, depois de reservar a parte do sistema, restam cerca de 122 GiB para os modelos. Para comparar, uma RTX 5090 tem 32 GB de VRAM. Considerando apenas a capacidade, um Spark comporta tanto quanto quatro placas de vídeo topo de linha para jogos.
Sua largura de banda de memória, porém, é de apenas cerca de 273 GB/s. A RTX 5090 alcança 1,8 TB/s, mais de seis vezes isso.
A capacidade determina se um modelo cabe. A largura de banda determina a rapidez com que ele conversa.
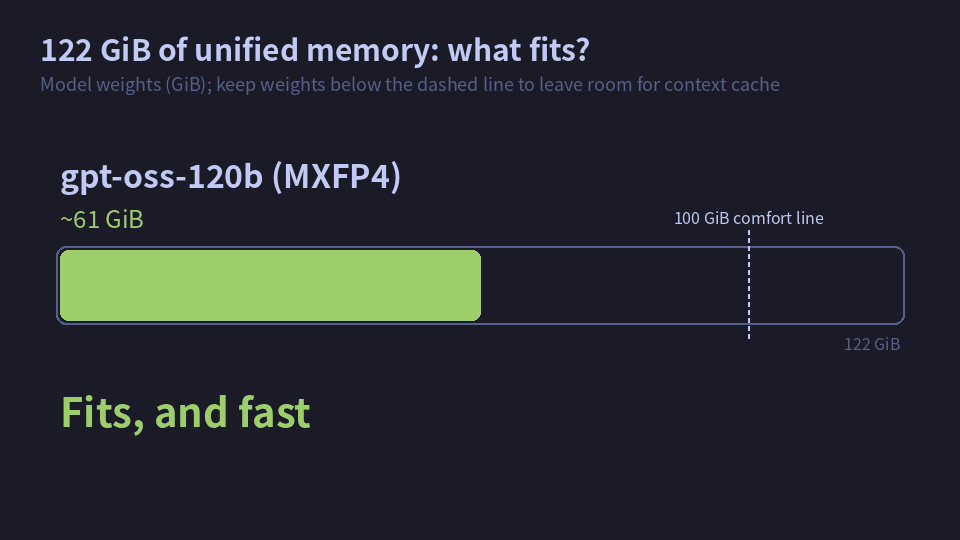
Ordenados pelo tamanho dos pesos: o gpt-oss-120b ocupa cerca de 61 GiB e o GLM-4.5-Air de 4 bits, cerca de 68 GiB. Ambos cabem com folga, deixando mais de 40 GiB para o cache de contexto. O Qwen3-235B só cabe com quantização de 3 bits, e aí o espaço fica apertado. Um modelo de 671B como o DeepSeek V3 precisa de cerca de 380 GiB mesmo com quantização de 4 bits, então um único Spark não consegue comportá-lo.
Uma regra prática: mantenha os pesos abaixo de 100 GiB. Acima disso, não sobra espaço para um cache de contexto longo.
A velocidade se resume a uma fórmula
Para gerar cada token, o modelo precisa ler da memória todos os pesos usados naquela etapa. Isso impõe um limite rígido à velocidade de geração para um único usuário:
Velocidade máxima de geração ≈ largura de banda da memória ÷ bytes lidos por token
Uma Llama 70B de 4 bits (Q4_K_M) ocupa cerca de 42,5 GB, e 273 ÷ 42,5 ≈ 6,4. Esse é seu limite teórico, e os resultados no mundo real são menores.
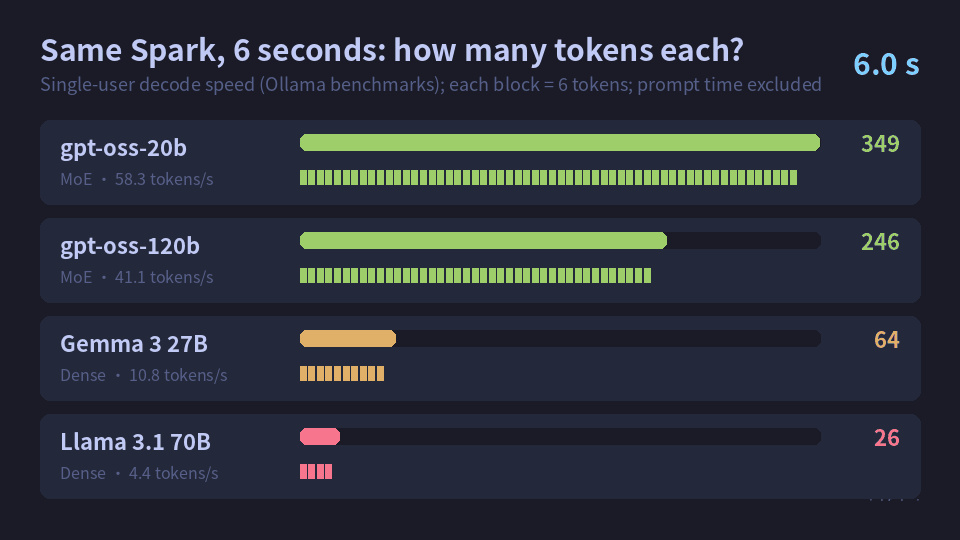
Benchmarks oficiais do Ollama no DGX Spark:
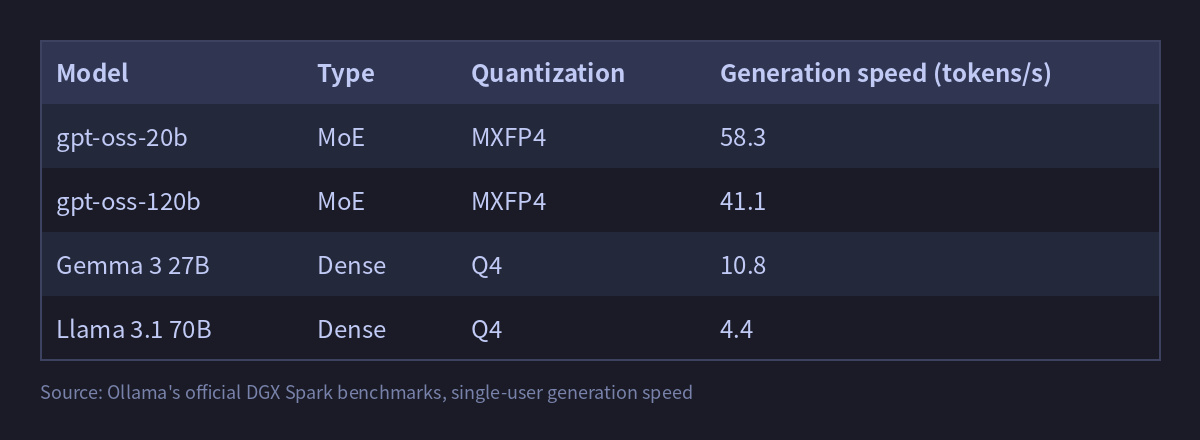
A 4 tokens por segundo, você fica vendo a resposta sair aos poucos. O uso interativo é frustrante.
O aspecto contraintuitivo: o 120B roda quase 10 vezes mais rápido que o 70B
A linha mais interessante daquela tabela é a do gpt-oss-120b. Ele tem cerca de 67% mais parâmetros que a Llama 70B, mas gera mais de 9 vezes mais rápido.
O motivo é a arquitetura. A Llama 70B é um modelo denso: todos os seus 70 bilhões de parâmetros participam de cada token, então todos são lidos da memória a cada vez. O gpt-oss-120b é um modelo de mistura de especialistas (MoE): seus 117 bilhões de parâmetros são divididos em muitos "especialistas", e cada token aciona apenas alguns deles. Apenas cerca de 5,1 bilhões de parâmetros ficam ativos por token.
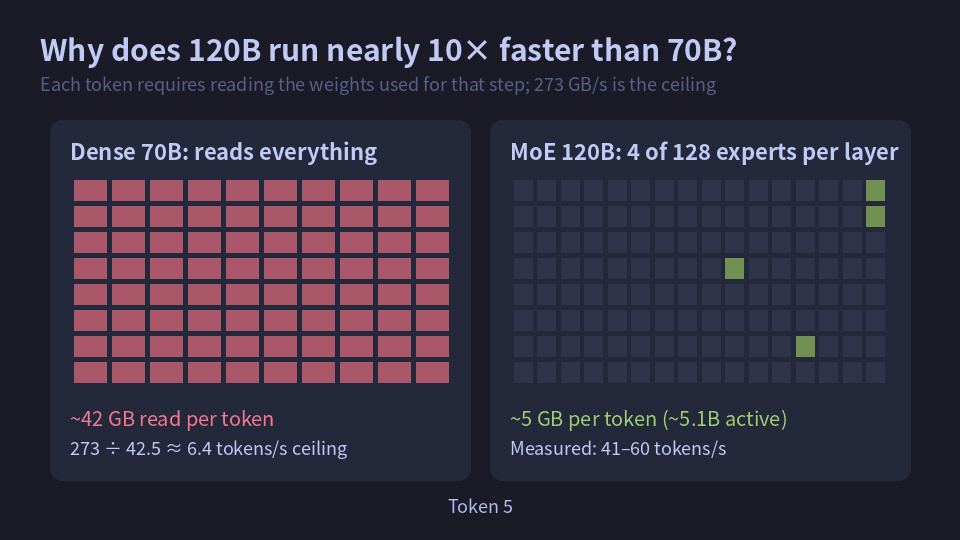
O modelo denso de 70B lê cerca de 42 GB por token. O MoE de 120B lê apenas cerca de 5 GB: cerca de 2 GB para os especialistas selecionados, mais cerca de 3 GB para as camadas de atenção e saída, mantidas em maior precisão. Isso explica a diferença de velocidade de quase dez vezes em uma máquina limitada pela largura de banda.
Isso também define a regra para escolher modelos: o Spark é uma máquina feita para MoE. O total de parâmetros pode ser grande, porque há bastante memória. Os parâmetros ativos precisam ser poucos, porque a largura de banda é limitada.
O que ele consegue executar de verdade
Por essa lógica, os modelos comuns de pesos abertos se dividem em sete categorias:
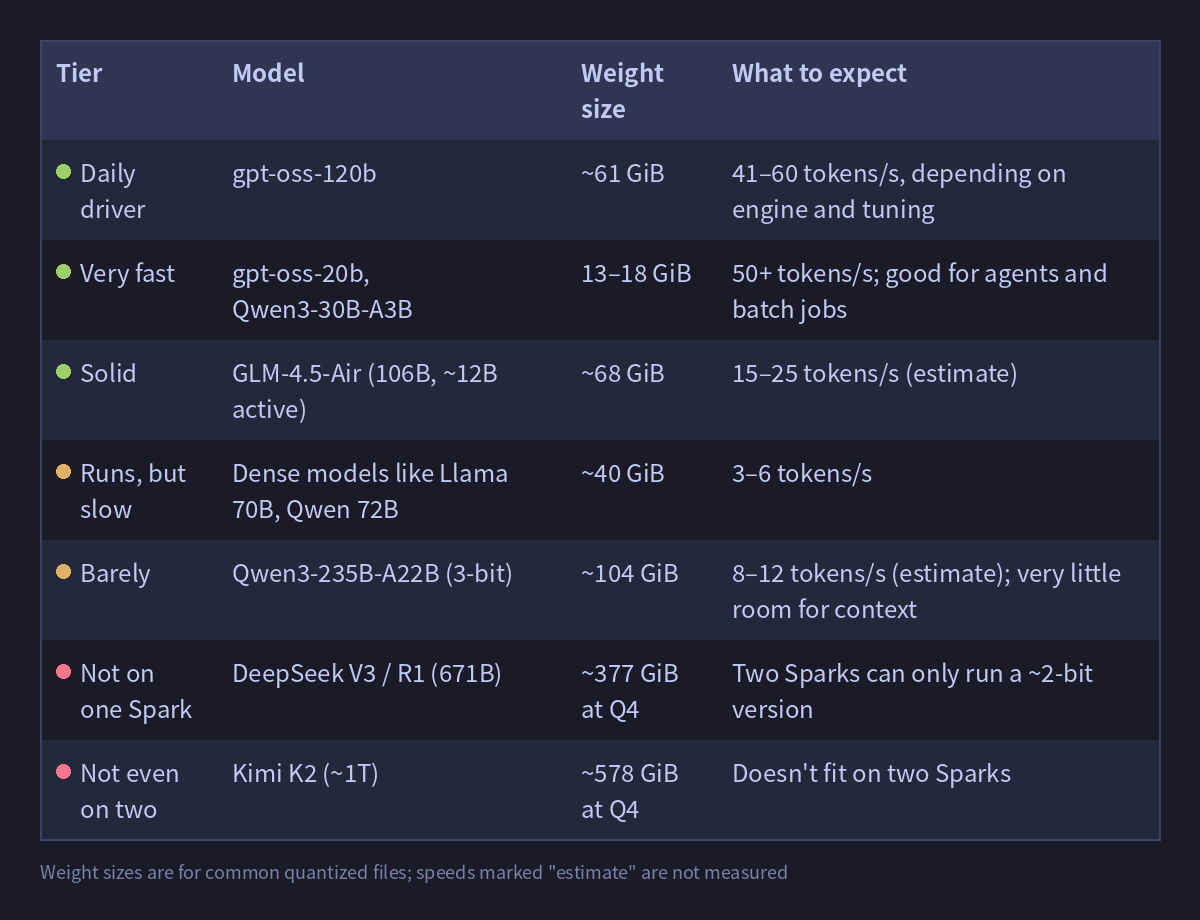
O mecanismo de inferência também importa. Benchmarks de gpt-oss-120b publicados em fóruns mostram cerca de 46 tokens/s no llama.cpp, cerca de 52 no SGLang e até 60 tokens/s em um vLLM otimizado. Para um único usuário, o llama.cpp dá menos trabalho. Para uso compartilhado com muitas solicitações simultâneas, escolha o vLLM.
Conectando dois: 256 GB
O Spark tem uma placa de rede de alta velocidade ConnectX-7 integrada. Duas unidades podem ser conectadas diretamente e usar paralelismo de tensores para dividir um modelo ao meio, com cada uma executando uma metade.
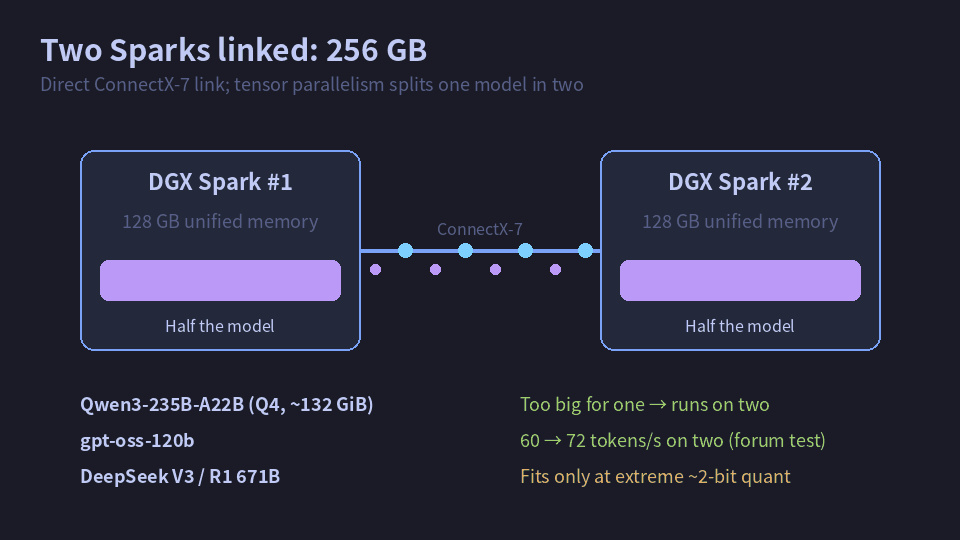
Com 256 GB distribuídos entre duas unidades, o Qwen3-235B roda completo com quantização de 4 bits. Em benchmarks publicados em fóruns, o gpt-oss-120b passa de 60 tokens/s em um Spark para 72 em dois: um ganho modesto, já que, desde o início, não faltava memória. O DeepSeek 671B ainda só cabe em duas unidades com uma quantização extrema de cerca de 2 bits; a perda de qualidade é perceptível, e dificilmente compensa.
Vale o preço?
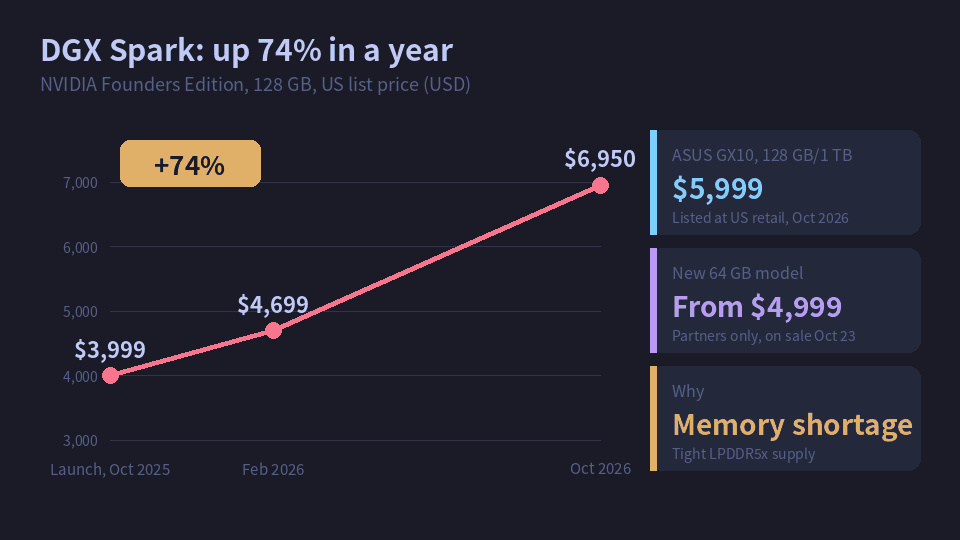
Esta máquina só ficou mais cara ao longo do último ano. A NVIDIA Founders Edition com 128 GB foi lançada por US$ 3.999, subiu para US$ 4.699 em fevereiro de 2026 e saltou para US$ 6.950 em outubro: um aumento de 74% em um ano. Quando aumentou o preço em fevereiro, a NVIDIA alegou escassez de memória; sobre o aumento de outubro, a cobertura da imprensa também apontou para a escassez global de memória.
Agora compare esses preços com os números de largura de banda aos quais sempre voltamos:
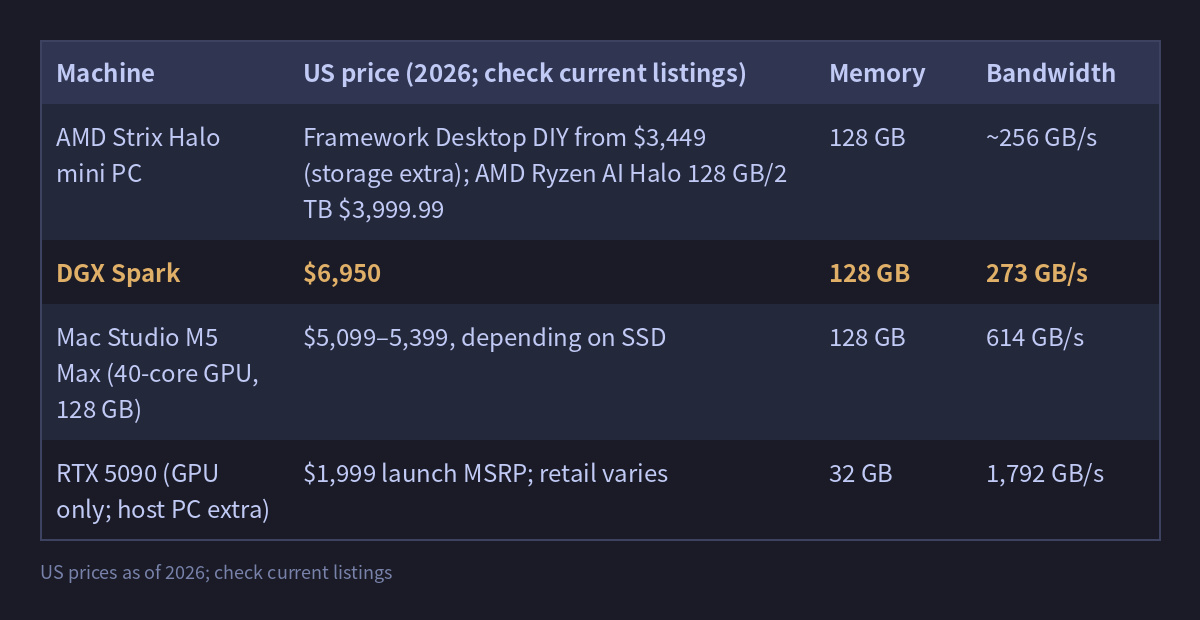
Com os mesmos 128 GB, um mini PC AMD Strix Halo tem uma largura de banda praticamente igual à do Spark por cerca de metade do preço. Um Mac Studio M5 Max agora custa menos que o Spark e tem 2,2 vezes a largura de banda dele, então gera respostas visivelmente mais rápido. Se tudo o que você quer é executar modelos grandes localmente, o Spark não oferece uma vantagem clara de preço.
O que o dinheiro extra compra é a pilha de software da NVIDIA: CUDA, vLLM, SGLang e TensorRT-LLM funcionam logo de cara, prompts longos são processados rapidamente, o ajuste fino funciona e tudo o que você desenvolver aqui pode ser transferido sem alterações para servidores NVIDIA no data center. Se você não precisa disso, não vale o preço.
Para quem é
Pense nesta máquina como uma estação de trabalho capaz de comportar modelos grandes, mas que não consegue conversar rápido:
Para conversas do dia a dia e ajuda com programação, o gpt-oss-120b é rápido e bom o suficiente;
Para agentes e processamento de documentos em lote, use um modelo MoE menor; nos benchmarks acima, o gpt-oss-20b decodifica cerca de 40% mais rápido que o gpt-oss-120b;
É no ajuste fino de modelos de até 70B (QLoRA) que os 128 GB de memória realmente compensam;
Modelos densos de 70B só servem para tarefas offline em que a espera não importa; se você precisar usar um, adicione um pequeno modelo auxiliar para decodificação especulativa, o que acelera bastante o processo.
Se o que você quer principalmente é "uma pessoa conversando rapidamente com um modelo grande", um Mac Studio ou uma GPU com bastante VRAM é mais adequado. Se você só quer comportar um modelo da classe 100B pelo menor custo possível, um mini PC AMD é a melhor opção. O Spark só vale o preço se seu trabalho depender de CUDA, envolver ajuste fino ou exigir a mesma pilha de software usada no data center.
Ao escolher um modelo, faça apenas duas perguntas: O total de parâmetros cabe em 122 GiB? Os parâmetros ativos são suficientemente poucos? Se a resposta a ambas for sim, é uma boa escolha para esta máquina.
Comprar hardware ou uma assinatura?
Depois das contas do hardware, há um cálculo mais direto.
Minha escolha pessoal são as assinaturas: Claude Max 5x por US$ 100 por mês, mais ChatGPT Plus (que inclui o Codex) por US$ 20 por mês, totalizando US$ 1.440 por ano. Um Spark de US$ 6.950 pagaria pelos dois por quase 5 anos; só pelo Max 5x, por quase 6 anos.
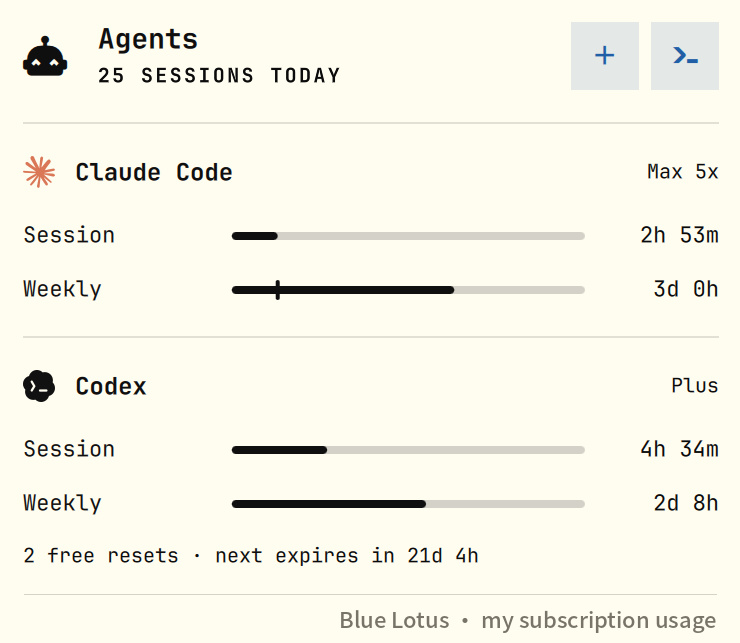
Este foi meu uso em um dia: 25 sessões de agente, cerca de 60% da cota semanal do Claude Code usada, faltando 3 dias para a renovação, e pouco mais da metade da cota semanal do Codex. Nesse ritmo, as duas assinaturas geralmente dão conta das minhas necessidades e oferecem modelos de ponta. A melhor opção local, o gpt-oss-120b, ainda fica aquém deles em programação e tarefas de longa duração.
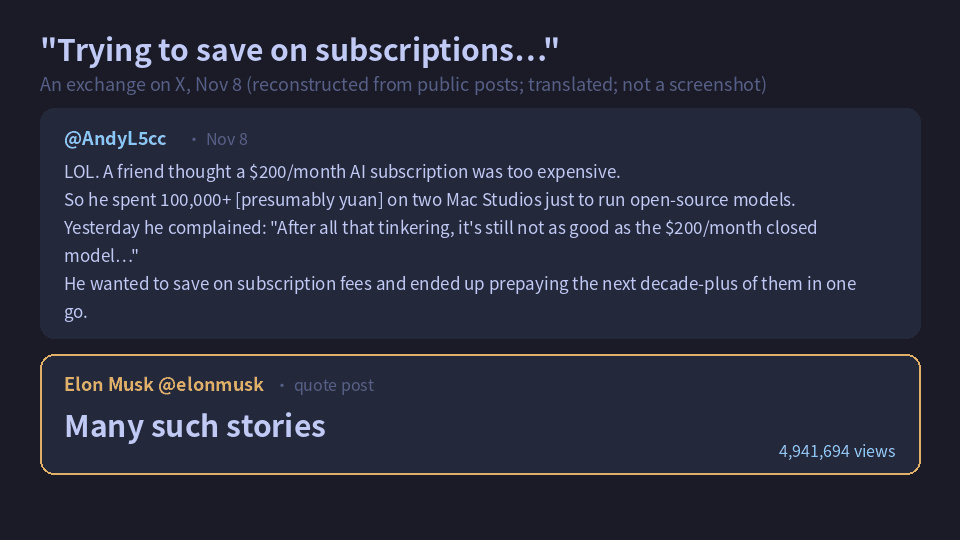
Não sou o único a fazer essas contas. Em 8 de novembro, uma publicação em chinês viralizou no X: alguém achou cara demais uma assinatura de IA de US$ 200 por mês, então acabou gastando mais de 100.000 (presumivelmente yuans) em dois Mac Studios só para executar modelos de código aberto, mas, depois de muito ajuste, descobriu que "ainda não é tão bom quanto o modelo fechado de US$ 200 por mês". O resumo de quem publicou foi: "Queria economizar nas taxas de assinatura e acabou pagando adiantado, de uma só vez, pelas assinaturas da próxima década e além." Elon Musk republicou a publicação com uma citação de apenas três palavras: "Muitas histórias assim." A publicação citada teve quase 5 milhões de visualizações.
Sam Altman, da OpenAI, explicou recentemente a lógica por trás disso em um podcast: a memória dos computadores pessoais fica em uso apenas cerca de 5% do tempo (segundo sua própria estimativa), enquanto a nuvem, ao agrupar solicitações e processá-las em lotes, geralmente consegue aumentar a utilização e distribuir os custos. Ele vende assinaturas de serviços na nuvem, então tem interesse nesse argumento, mas a lógica faz sentido: na nuvem, uma leitura dos pesos pode atender a um lote inteiro de solicitações de uma só vez, distribuindo o custo; uma máquina pessoal atende uma pessoa por vez e fica ociosa boa parte do dia. Portanto, antes de comprar hardware local, estime quanto você realmente vai usá-lo: quanto menos você usar, pior será o negócio.
Os modelos locais oferecem vantagens que uma assinatura não oferece:
Privacidade: dados de clientes, código interno, requisitos de conformidade; os dados não podem sair da sua própria máquina;
Sem restrições de plataforma: o modelo não está sujeito às políticas de conteúdo de um provedor, e você decide o que ele responde;
Offline e ilimitado: funciona sem conexão, e as tarefas em lote não consomem uma cota;
Ajuste fino: se você quiser treinar seu próprio modelo, uma assinatura não permite fazer isso.
Para a maioria das pessoas, uma assinatura custa menos e oferece modelos mais poderosos. Comprar um Spark só faz sentido se pelo menos uma das quatro necessidades acima for indispensável.