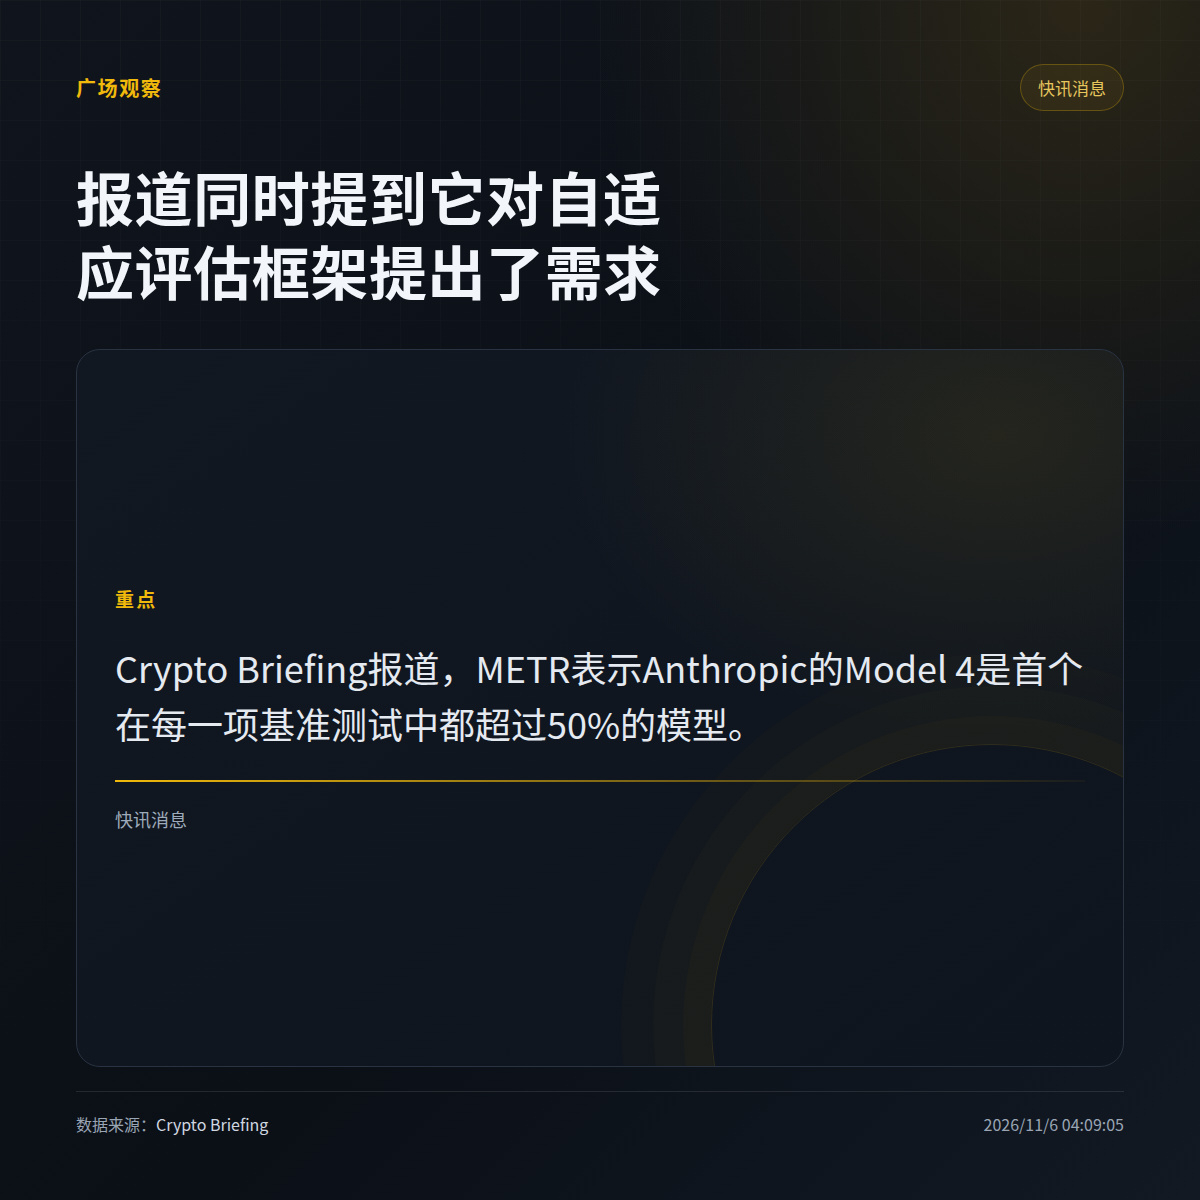
A METR afirma que o Model 4 da Anthropic superou 50% em todos os benchmarks pela primeira vez.
A Crypto Briefing noticiou que esse resultado foi descrito como uma estreia nas avaliações de modelos da Anthropic. A reportagem também mencionou a necessidade de uma estrutura de avaliação adaptativa e expressou preocupação com a velocidade do progresso da IA.
· O que pode ser verificado é a afirmação de que o modelo superou 50% em todos os benchmarks; a lista específica de benchmarks e as pontuações não foram incluídas no material.
· “Necessidade de uma estrutura de avaliação adaptativa” e “preocupação com o progresso rápido demais” são avaliações da reportagem, não conclusões da própria avaliação da METR.
Você prefere ver primeiro a lista completa de benchmarks ou as pontuações específicas de cada um?
A Crypto Briefing noticiou que esse resultado foi descrito como uma estreia nas avaliações de modelos da Anthropic. A reportagem também mencionou a necessidade de uma estrutura de avaliação adaptativa e expressou preocupação com a velocidade do progresso da IA.
· O que pode ser verificado é a afirmação de que o modelo superou 50% em todos os benchmarks; a lista específica de benchmarks e as pontuações não foram incluídas no material.
· “Necessidade de uma estrutura de avaliação adaptativa” e “preocupação com o progresso rápido demais” são avaliações da reportagem, não conclusões da própria avaliação da METR.
Você prefere ver primeiro a lista completa de benchmarks ou as pontuações específicas de cada um?