O ranking de avaliações de IA passou por uma grande reviravolta esta semana, a ponto de ficar um pouco difícil de entender.
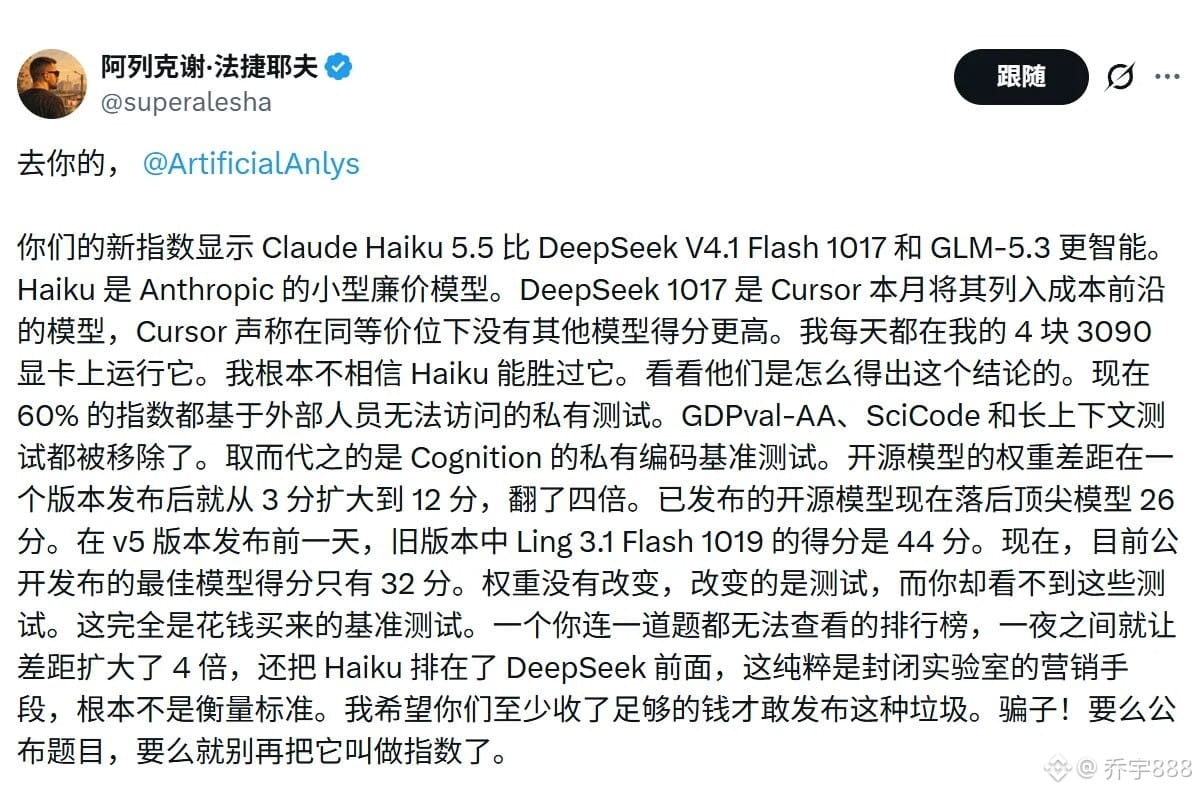
Em 23 de outubro, a Artificial Analysis ainda dava nota 55 ao Kimi K3.1 Pro, colocando-o em quarto lugar no mundo. Mas, com a atualização do ranking V5 em 27 de outubro, o Kimi caiu direto para 46 pontos, enquanto DeepSeek e GLM ficaram com apenas 32. O primeiro lugar passou a ser do Gemini 4 Carbon, com 59 pontos.
A principal mudança está no algoritmo: desta vez, vários testes foram substituídos e os pesos, redistribuídos. 60% do peso ficou com conjuntos de teste privados ou respostas ocultas. Ou seja, mais da metade da pontuação do ranking vem de testes que o público não consegue ver nem verificar de forma independente.
Minha opinião: o ranking deveria ser uma régua para ajudar desenvolvedores a escolher modelos. Mas, quando as marcações da própria régua mudam, os resultados da medição também mudam por completo. A queda do Kimi de 55 para 46 e a do DeepSeek para 32 não significam necessariamente que os modelos pioraram; é mais provável que o método de medição da nova régua tenha mudado. Na minha opinião, ao consultar um ranking, é preciso ver como ele calcula as notas, e não apenas olhar as posições — especialmente quando 60% da pontuação vem de testes de caixa-preta. Nesse caso, é melhor considerar o ranking com cautela.
#IAnaVanguarda
$BTC
Em 23 de outubro, a Artificial Analysis ainda dava nota 55 ao Kimi K3.1 Pro, colocando-o em quarto lugar no mundo. Mas, com a atualização do ranking V5 em 27 de outubro, o Kimi caiu direto para 46 pontos, enquanto DeepSeek e GLM ficaram com apenas 32. O primeiro lugar passou a ser do Gemini 4 Carbon, com 59 pontos.
A principal mudança está no algoritmo: desta vez, vários testes foram substituídos e os pesos, redistribuídos. 60% do peso ficou com conjuntos de teste privados ou respostas ocultas. Ou seja, mais da metade da pontuação do ranking vem de testes que o público não consegue ver nem verificar de forma independente.
Minha opinião: o ranking deveria ser uma régua para ajudar desenvolvedores a escolher modelos. Mas, quando as marcações da própria régua mudam, os resultados da medição também mudam por completo. A queda do Kimi de 55 para 46 e a do DeepSeek para 32 não significam necessariamente que os modelos pioraram; é mais provável que o método de medição da nova régua tenha mudado. Na minha opinião, ao consultar um ranking, é preciso ver como ele calcula as notas, e não apenas olhar as posições — especialmente quando 60% da pontuação vem de testes de caixa-preta. Nesse caso, é melhor considerar o ranking com cautela.
#IAnaVanguarda
$BTC