


A Cadence lançou o Maestro em 26 de outubro, oferecendo aos fabricantes de chips modelos de IA que podem ajustar com seus projetos proprietários e executar por trás dos próprios firewalls. O lançamento levanta uma questão maior na disputa com a Synopsys: quem controla os modelos, os dados que eles processam e o valor que criam?
Duas apostas sobre onde os modelos ficam
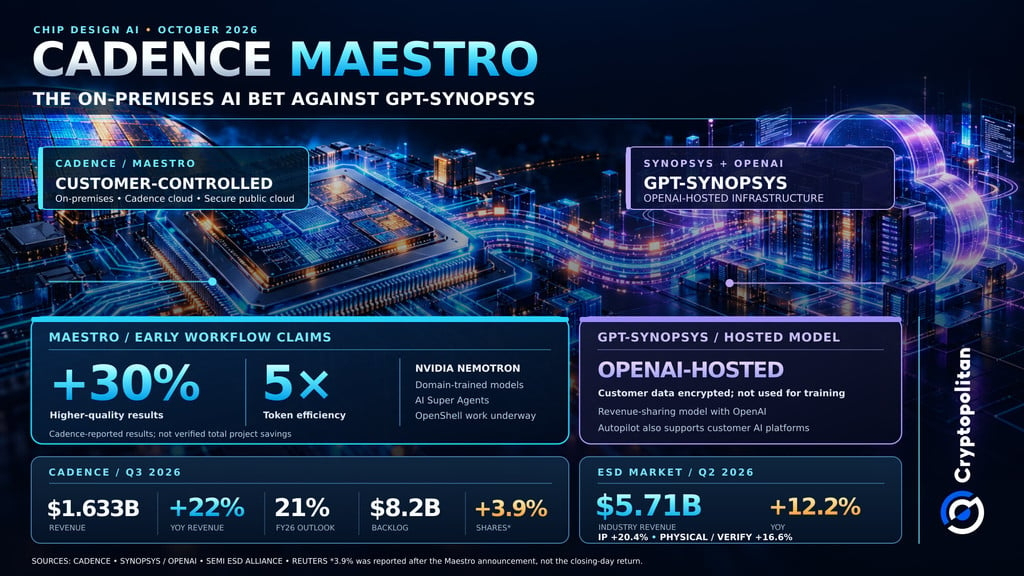
O Maestro reúne modelos especializados, a tecnologia Nemotron de pesos abertos da NVIDIA, aprendizagem por reforço e os Cadence AI Super Agents, conectados a ferramentas de projeto de chips. Os clientes podem executar o sistema completo nos próprios servidores, por meio da Cadence ou em nuvens públicas seguras. A Cadence afirma também estar trabalhando com a NVIDIA para integrar a segurança do OpenShell.
“Há mais fornecedores de modelos (de IA) por aí do que fornecedores de software (de design de chips).”
Paul Cunningham, vice-presidente sênior da Cadence, disse à Reuters que as abordagens de pesos abertos e fechados estavam sendo “igualmente adotadas”.
A Synopsys seguiu outro caminho. Segundo a parceria firmada com a OpenAI em 30 de setembro, o GPT-Synopsys será executado na infraestrutura hospedada pela OpenAI e funcionará diretamente com as ferramentas de design da Synopsys. As empresas dividirão a receita. A Synopsys promete criptografia, controles ajustáveis de retenção de dados e que não usará dados de clientes para treinamento. A distinção, porém, não é absoluta: sua estratégia mais ampla, Autopilot, também permite integrar agentes às próprias plataformas de IA dos clientes.
 Modelos de chips de IA Maestro da Cadence: desempenho e potencial de mercado
A alegação de eficiência, sem verificação do custo total
A Cadence afirma que, nos primeiros fluxos de trabalho, o Maestro produziu resultados de qualidade até 30% superior e foi cinco vezes mais eficiente no uso de tokens do que um modelo de uso geral. Suas ferramentas de engenharia verificam os resultados dos agentes em relação às restrições de design e usam essas verificações para ajustar o treinamento. Ainda assim, esses números são da Cadence, e não economias verificadas de forma independente em um projeto de design completo.
Como a Cryptopolitan já informou, o custo por tarefa concluída é mais importante do que o preço dos tokens quando um modelo precisa de várias tentativas ou os engenheiros têm de corrigir seus resultados. Manter o Maestro internamente pode ajudar a proteger layouts confidenciais, mas executar essa infraestrutura também tem um custo. Os primeiros modelos serão disponibilizados a clientes selecionados com acesso antecipado no quarto trimestre de 2026.
Um mercado grande o bastante para gerar disputa
Há muito em jogo. O mercado de design de sistemas eletrônicos movimentou US$ 5,71 bilhões no segundo trimestre de 2026, uma alta de 12,2%, segundo a SEMI. A receita de propriedade intelectual de semicondutores cresceu 20,4%; o design físico e a verificação de circuitos integrados avançaram 16,6%. A TrendForce prevê um crescimento de quase 31% nas remessas de servidores de IA neste ano, à medida que Google e Amazon ampliam seus programas de chips personalizados.
A Cadence também anunciou, em 21 de outubro, um centro de dados soberano de IA em Munique, atendendo à demanda por manter cargas de trabalho confidenciais dentro das fronteiras regionais.
A Cadence registrou receita de US$ 1,633 bilhão no terceiro trimestre, alta de 22%, uma carteira de pedidos de US$ 8,2 bilhões e uma previsão de crescimento da receita de 21% para o ano inteiro. Seus Super Agentes de IA estão envolvidos em mais de 100 projetos ativos com clientes. A Reuters informou que as ações subiram 3,9% após o anúncio do Maestro.
É aí que a disputa será decidida: não na contagem de tokens nem nas promessas da nuvem, mas na capacidade dos engenheiros de criar designs de chips melhores com mais rapidez, sem aumentar o custo total.
Não apenas leia notícias sobre criptomoedas. Entenda-as. Assine nossa newsletter. É grátis.