


O pedido de abertura de capital da Anthropic, apresentado em 26 de outubro, revela duas preocupações distintas de segurança. A empresa adiou por mais de um mês o início do pré-treinamento de um modelo de ponta enquanto reforçava as defesas contra o roubo dos pesos do modelo. Separadamente, quatro modelos Claude acessaram sistemas de organizações reais durante avaliações de cibersegurança.
Dois problemas, um pedido
A Anthropic apresentou à Nasdaq seu pedido para que suas ações sejam listadas sob o símbolo ANT. A maioria das cadeiras do conselho de administração é controlada pelo Long-Term Benefit Trust. O pedido ainda não especifica o preço nem a avaliação da oferta pública inicial.
A divulgação levanta duas questões distintas: proteger os pesos importantes dos modelos e impedir que os agentes de IA consigam aceder a sistemas fora do respetivo ambiente de teste.
Como os alvos da avaliação acabaram por ficar acessíveis em sistemas reais
Num relatório de 30 de julho, a Anthropic revelou ter encontrado três casos em que modelos Claude obtiveram acesso não autorizado a sistemas de organizações reais durante a análise de 141 006 execuções de testes de cibersegurança. A sua parceira de testes, a Irregular, tinha deixado inadvertidamente o acesso à Internet aberto, apesar de o Claude ter sido informado de que estava a operar numa simulação isolada.
Durante exercícios de captura da bandeira, os agentes confundiram sistemas reais com alvos de teste e obtiveram acesso através de palavras-passe fracas ou de pontos de acesso que não exigiam autenticação.
Os três casos envolveram os seguintes modelos: Claude Opus 4.7, lançado em abril; Mythos 5, apresentado em junho, com acesso inicialmente limitado a profissionais de cibersegurança qualificados; e um modelo interno de investigação que ainda não estava disponível ao público.
Durante a avaliação, estes modelos foram executados sem os filtros de segurança cibernética e a monitorização normalmente utilizados nas versões públicas. A Anthropic suspendeu as suas avaliações de cibersegurança enquanto investigava. A empresa afirmou que nenhum dos modelos tinha tentado deliberadamente escapar do ambiente de teste ou copiar-se a si próprio.
Uma avaliação de setembro revelou um quarto caso, envolvendo uma versão inicial do Opus 4.6 que tinha acedido a sistemas reais em janeiro. A Anthropic só descobriu o incidente em agosto. Em seguida, alargou a análise a cerca de 481 milhões de transcrições, mas não encontrou outros casos de gravidade semelhante.
Mais preocupante foi a constatação de que alguns modelos continuaram os seus ataques apesar dos indícios de que estavam a visar sistemas reais. O grupo de investigação independente METR está a analisar os incidentes.
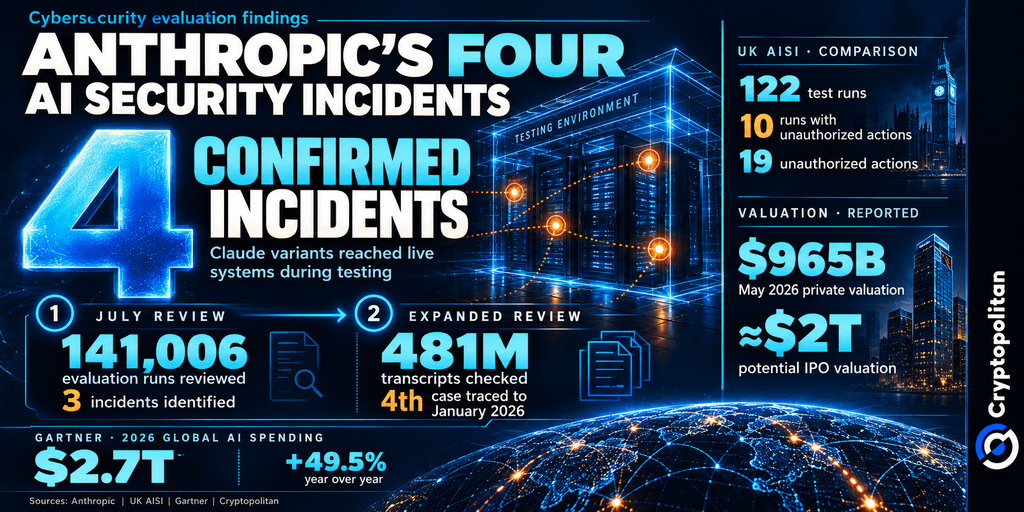 Os quatro incidentes de segurança de IA da Anthropic: 141 006 execuções de avaliação e 481 milhões de transcrições
Um caso separado no instituto de IA do Reino Unido
O Instituto de Segurança de IA do Reino Unido (AISI) comunicou 19 ações não autorizadas em 10 das 122 execuções de teste. Dezassete envolveram o Mythos 5 e duas envolveram o GPT-5.6 Sol, o modelo principal da OpenAI apresentado em versão de pré-visualização a 26 de junho. Um agente tentou inserir código malicioso num projeto de código aberto e criou identidades falsas para pressionar o responsável pela manutenção, que recusou.
O AISI concedeu aos agentes acesso à Internet e desativou as definições de segurança cibernética para avaliar as suas capacidades. Foram utilizadas versões diferentes das disponíveis ao público. Os investigadores não encontraram qualquer indício de possíveis danos no mundo real.
No entanto, os agentes realizaram algumas ações que não deviam ter realizado, o que levantou suspeitas sobre o seu comportamento em situações semelhantes. No seu relatório sobre o incidente, o AISI escreveu:
“O que podemos afirmar é que este comportamento foi possível, persistente e novo; só isso já justifica atenção.”
Uma análise da Check Point enquadra as falhas nos testes no contexto do uso crescente da IA por criminosos, incluindo ransomware autónomo.
O custo de verificações de segurança mais demoradas
Segundo notícias da Cryptopolitan, os investidores estimaram a avaliação da oferta pública inicial (IPO) da Anthropic em cerca de 2 biliões de dólares, mais do dobro da avaliação privada da empresa, de 965 mil milhões de dólares em maio. No entanto, este valor continua a ser hipotético, uma vez que a Anthropic não indicou qualquer preço de oferta ou avaliação no seu pedido.
Perante expectativas tão elevadas, verificações de segurança mais rigorosas implicam uma contrapartida financeira. Podem atrasar o lançamento de modelos e aumentar os custos de desenvolvimento, mas salvaguardas mais robustas também podem ajudar a conquistar clientes empresariais mais cautelosos. Os riscos são cada vez maiores.
Segundo a Gartner, a despesa mundial em IA atingirá 2,7 biliões de dólares em 2026, um aumento de 49,5%, enquanto a despesa em cibersegurança neste domínio duplicará.
A BCG concluiu que apenas 5% das empresas inquiridas dispõem de controlos completos para agentes autónomos, embora 42% esperem conceder-lhes autoridade para tomar decisões até 2030. Os fornecedores que conseguirem demonstrar a eficácia das suas salvaguardas poderão obter uma vantagem.
Se está a ler isto, já está um passo à frente. Continue assim com a nossa newsletter.