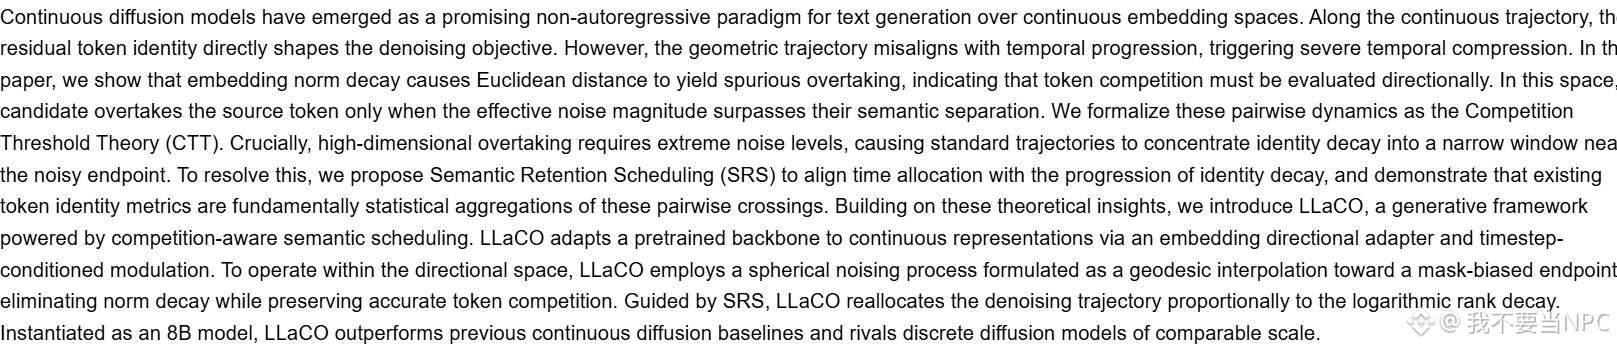
O modelo LLaCO de 8B seguiu um caminho um pouco diferente: em vez de gerar texto palavra por palavra, da esquerda para a direita, ele faz difusão no espaço de embeddings contínuo, removendo o ruído passo a passo. Em um preprint no arXiv, a equipe aponta um problema antigo da difusão contínua: a norma dos vetores de embedding diminui, e medir a competição entre tokens pela distância euclidiana pode criar uma “ultrapassagem falsa” — parece que um token candidato superou o token de origem, mas, na verdade, a distância foi calculada de forma distorcida. A equipe organizou essas relações de competição entre pares na Competition Threshold Theory (CTT) e, com base nela, propôs o Semantic Retention Scheduling (SRS), que ajusta a distribuição de tempo entre as etapas de remoção de ruído de acordo com o ritmo de degradação da identidade dos tokens. No modelo, um adaptador de direção dos embeddings e uma modulação condicionada pelo passo temporal conectam o backbone pré-treinado às representações contínuas; a adição de ruído é substituída por uma interpolação geodésica esférica em direção a um ponto de extremidade com viés para o mascaramento, contornando a degradação das normas. Segundo o resumo, o LLaCO supera os baselines anteriores de difusão contínua e empata com modelos de difusão discreta de escala semelhante. O preprint ainda não passou por revisão por pares, então convém encarar as conclusões experimentais apenas como referência.
$BTC
$BTC