


Acompanhar o ciclo de vida da transação, o tratamento de falhas e os mecanismos de recuperação nas redes Rayls.
Uma transferência entre blockchains pode parecer enganosamente simples.
Escolhe um token, introduz um endereço de destino, confirma a transação e aguarda que os fundos cheguem.
Mas o que acontece depois de clicar em confirmar?
O livro-razão de origem tem de processar a transação. Os serviços de suporte têm de preparar e encaminhar a mensagem. O destino tem de verificar e executar a operação correspondente. Se algo falhar pelo caminho, o sistema precisa de uma resposta definida.
Isso levanta uma questão que quis investigar na documentação da Rayls:
Se uma transferência entre cadeias falhar depois de a transação de origem ser bem-sucedida, o que acontece realmente aos tokens?
A resposta é mais interessante do que um simples estado de sucesso ou falha. A Rayls documenta comportamentos diferentes para o standard teleport, o atomic teleport e as transferências entre um ledger Rayls Sovereign e a Rayls Public Chain.
Compreender essas diferenças também revela um princípio importante da engenharia entre cadeias: uma transação pode ser bem-sucedida numa fase sem que a transferência esteja concluída na totalidade.
1. Uma transferência entre cadeias é uma sequência, não uma única transação
Comecemos com uma transferência padrão entre duas instituições dentro de uma Rayls Private Network.
Em termos gerais, a rota é a seguinte:
Ledger Sovereign de envio → Relayer → Private Network Hub → Relayer recetor → Ledger Sovereign de destino
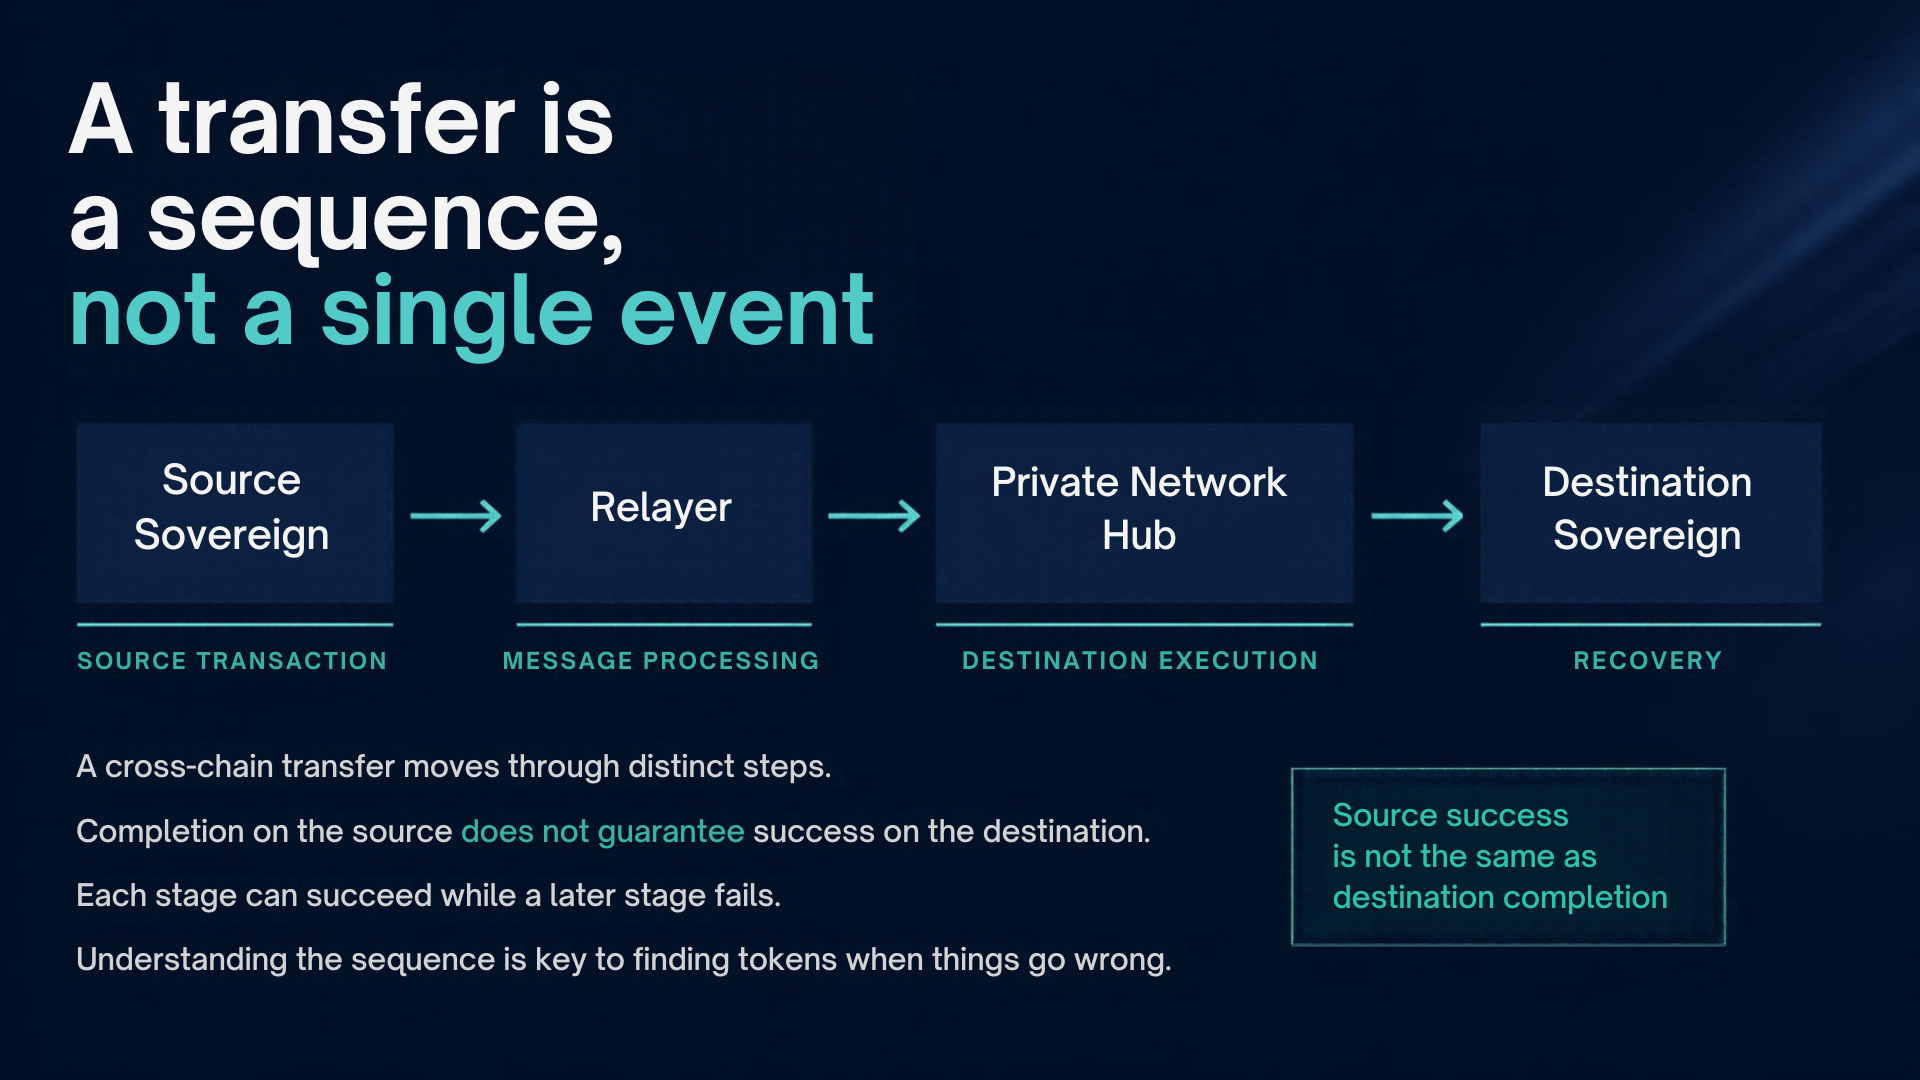
Cada componente tem uma responsabilidade específica.
O ledger de envio processa a transferência e queima os tokens de origem. O seu endpoint emite um evento MessageDispatched.
O Relayer do remetente deteta esse evento, prepara uma prova de Merkle e encripta a mensagem para a instituição de destino. Em seguida, a mensagem é submetida ao Private Network Hub, que valida a prova e armazena a mensagem.
No lado recetor, o Relayer de destino deteta a mensagem, desencripta a carga útil e submete a operação correspondente ao ledger de destino. O endpoint de destino verifica se a mensagem já foi executada e o gestor de tokens cunha os tokens para o destinatário.
Não se trata simplesmente de um token passar de um saldo para outro. É um processo coordenado que envolve execução na origem, preparação da mensagem, verificação, entrega e execução no destino.
A queima na origem e a cunhagem no destino são particularmente importantes. Ajudam a impedir que o mesmo ativo continue a poder ser gasto de forma independente em ambos os lados da transferência.
Mas também levantam uma questão de recuperação: o que acontece se a queima na origem for bem-sucedida e a operação no destino não?
Referência técnica oficial:
2. Quanto tempo demora realmente uma transferência normal?
Um pormenor chamou-me a atenção na documentação oficial: o tempo indicado de ponta a ponta para um standard teleport na Private Network é de aproximadamente 30–60 segundos.
Isto é um lembrete útil de que a velocidade de uma transação individual de blockchain não determina o tempo de conclusão de toda a operação entre cadeias.
O processo documentado inclui várias fases:
Submissão da transação de origem e execução local.
Deteção do evento pelo Relayer.
Geração da prova de Merkle.
Encriptação da mensagem.
Submissão ao Private Network Hub.
Deteção do evento no destino.
Desencriptação e execução no destino.
O tempo de bloco do Hub e os intervalos de consulta utilizados pelos Relayers contribuem significativamente para a duração total.
É necessário algum trabalho adicional para fluxos como o Enygma e a liquidação contra pagamento (DvP), que podem exigir a geração de provas de conhecimento zero.
Para um programador de aplicações, esta distinção altera a forma como o estado da transação deve ser apresentado.
Um recibo da transação de origem confirma que a transação de origem foi executada. Por si só, não prova que o destino concluiu a sua parte da transferência.
Uma interface útil deve, por isso, distinguir entre a confirmação da origem, o processamento entre cadeias, a execução no destino e a recuperação.
Os tempos exatos são expectativas documentadas, não uma garantia de que todas as transações serão concluídas no mesmo intervalo.
Fonte:
https://docs.rayls.com/docs/how-a-cross-chain-transaction-works
3. Quatro pontos de falha — e por que são diferentes
Para compreender a recuperação, dividi o processo em quatro cenários práticos de falha.
Cenário A: A transação de origem é revertida
Se a transação for revertida no ledger Sovereign de envio, a mensagem entre cadeias não é enviada.
A transferência não avançou para o processo normal de entrega entre cadeias. O remetente pode investigar o motivo da reversão e tentar novamente depois de corrigir o problema.
Isto é fundamentalmente diferente de uma transferência em que os tokens de origem já foram queimados e entraram no processo de mensagens.
Cenário B: Um serviço de suporte falha temporariamente
O Relayer depende de serviços de suporte para preparar e processar mensagens.
A documentação descreve o comportamento de novas tentativas quando a geração da prova de Merkle falha, quando o Cryptographic Trust Suite está indisponível e quando ocorre o tempo limite da API de geração de provas.
Estes são exemplos de falhas que podem ser resolvidas tentando novamente uma operação, em vez de abandonar imediatamente a transferência.
Um problema temporário num serviço e uma transação permanentemente inválida não são a mesma coisa.
Cenário C: O Private Network Hub rejeita uma prova
O Private Network Hub valida a prova que acompanha a mensagem entre cadeias.
Se a validação da prova falhar, a transação é rejeitada e registada para investigação.
O processo de recuperação documentado para o atomic teleport permite que o Relayer inicie uma transação de reversão no ledger de origem, devolvendo os tokens ao remetente.
Isto ilustra a diferença entre detetar uma operação inválida e recuperar o estado do ativo depois de essa operação não poder prosseguir.
Cenário D: A operação no destino falha
Uma transferência pode chegar ao lado recetor e ainda assim falhar durante a execução no destino.
O comportamento de recuperação depende do protocolo de transferência.
Para o standard teleport, a documentação indica que uma falha na execução no destino é assinalada como falha e exige uma nova tentativa manual.
Para o atomic teleport, uma falha na execução no destino desencadeia o processo automático de reversão documentado, devolvendo os fundos à origem.
Esta distinção é essencial. Seria incorreto afirmar que todas as transferências entre cadeias da Rayls são automaticamente revertidas após qualquer falha.
A garantia de recuperação depende da rota utilizada.
Fonte:
https://docs.rayls.com/docs/how-a-cross-chain-transaction-works
4. Estes dois termos podem parecer intercambiáveis, mas representam ações diferentes.
Tentar novamente significa repetir uma operação. É útil quando uma falha temporária pode desaparecer — por exemplo, quando um serviço de suporte volta a estar disponível ou quando se pode repetir uma tentativa de geração de prova.
Reverter, nos processos documentados de recuperação entre cadeias, significa iniciar uma transação compensatória que restaura o estado do ativo do lado da origem.
Consideremos um exemplo simplificado.
Uma instituição inicia uma transferência de 100 tokens. A transação de origem é bem-sucedida e os tokens do lado da origem são queimados. Mas o ledger recetor não consegue concluir a operação no destino.
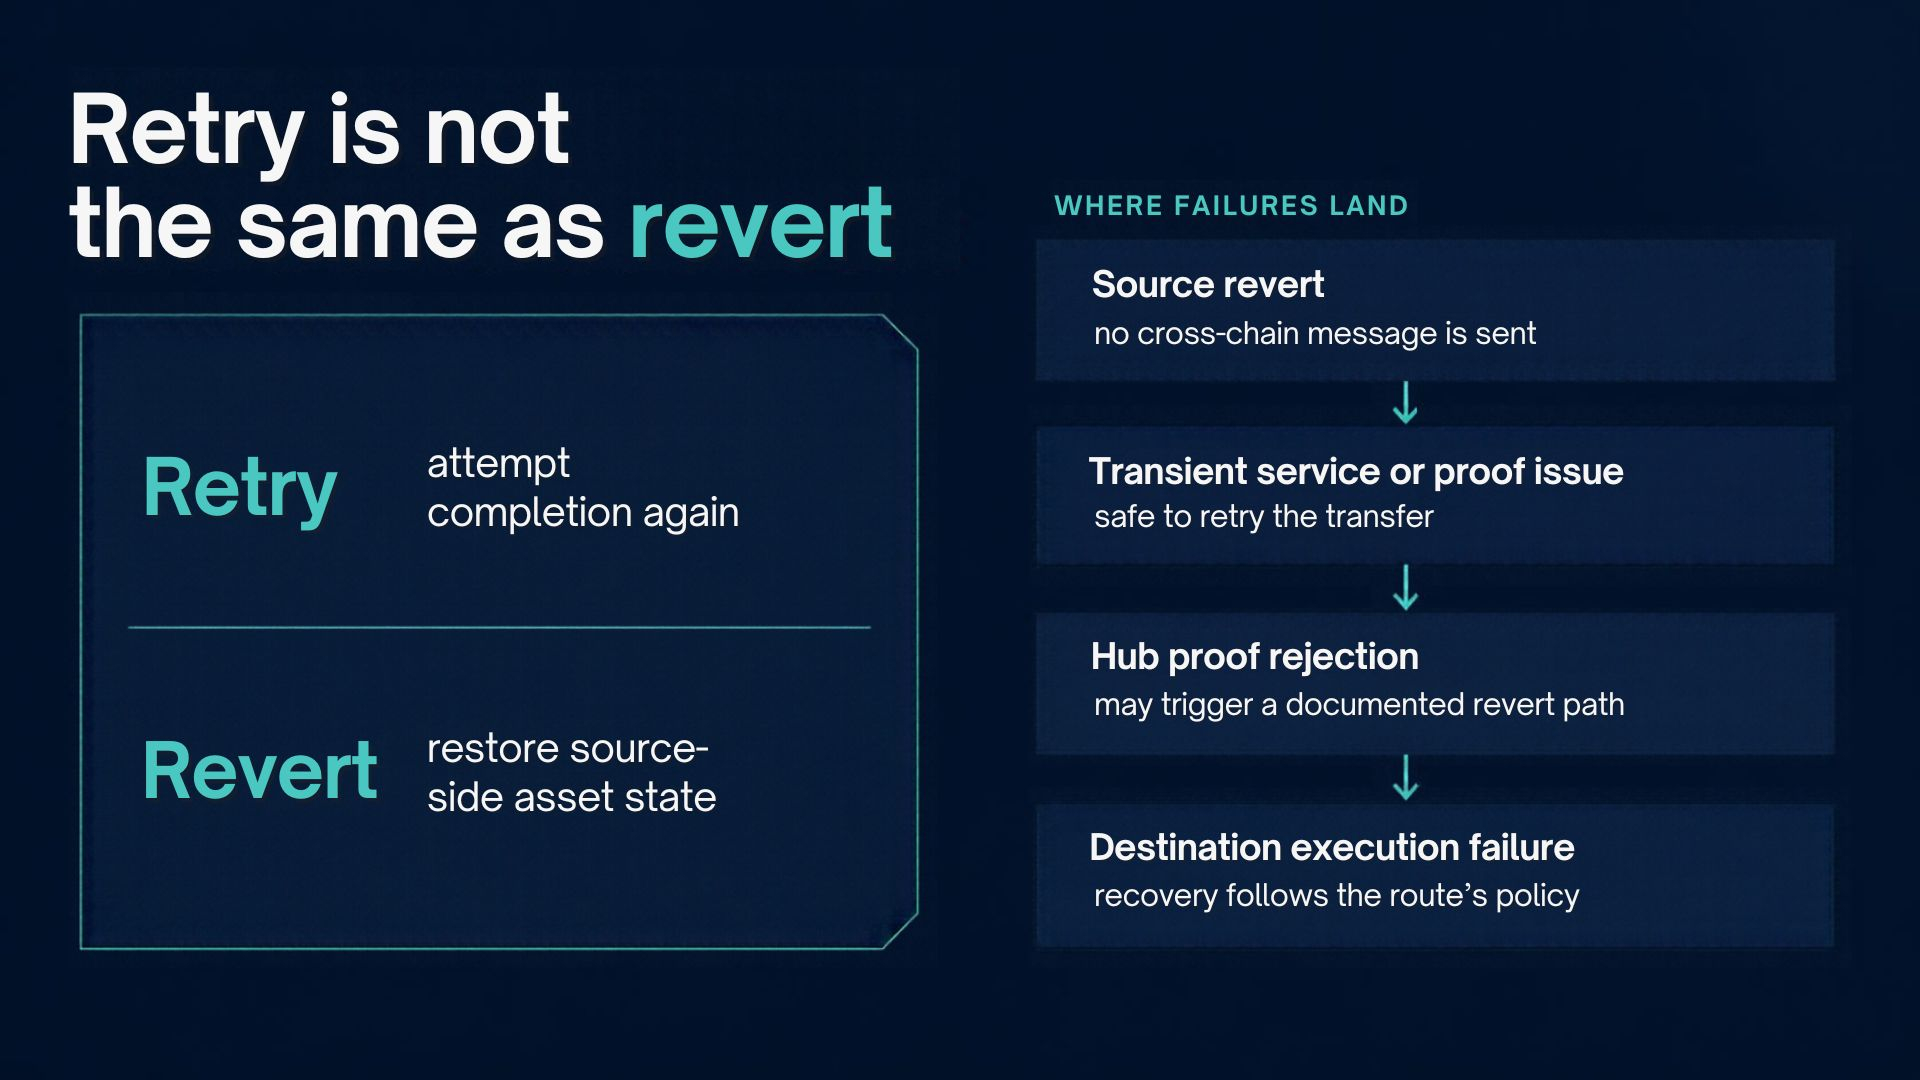
Com o standard teleport, a operação falhada no destino é assinalada como falha e a documentação especifica que é necessário tentar novamente manualmente.
Com o atomic teleport, o protocolo acrescenta coordenação e uma fase de retorno. Se a transação falhar no âmbito do fluxo atómico documentado, os tokens do lado da origem podem ser restaurados através do processo de reversão.
A diferença fundamental não está apenas na forma como a falha é comunicada. Está no que o protocolo faz em relação ao ativo após a falha.
Há também uma ressalva importante: uma reversão é, por si só, uma transação. O mecanismo de recuperação tem de ser submetido e processado. Um processo automático de recuperação documentado não deve ser confundido com a afirmação de que todas as falhas operacionais são resolvidas instantaneamente ou sem monitorização.
Fonte:
https://docs.rayls.com/docs/sending-teleports
5. Standard teleport versus atomic teleport
Esta é a distinção mais importante da investigação.
O standard teleport e o atomic teleport partilham a arquitetura geral entre cadeias, mas o tratamento de falhas é diferente.
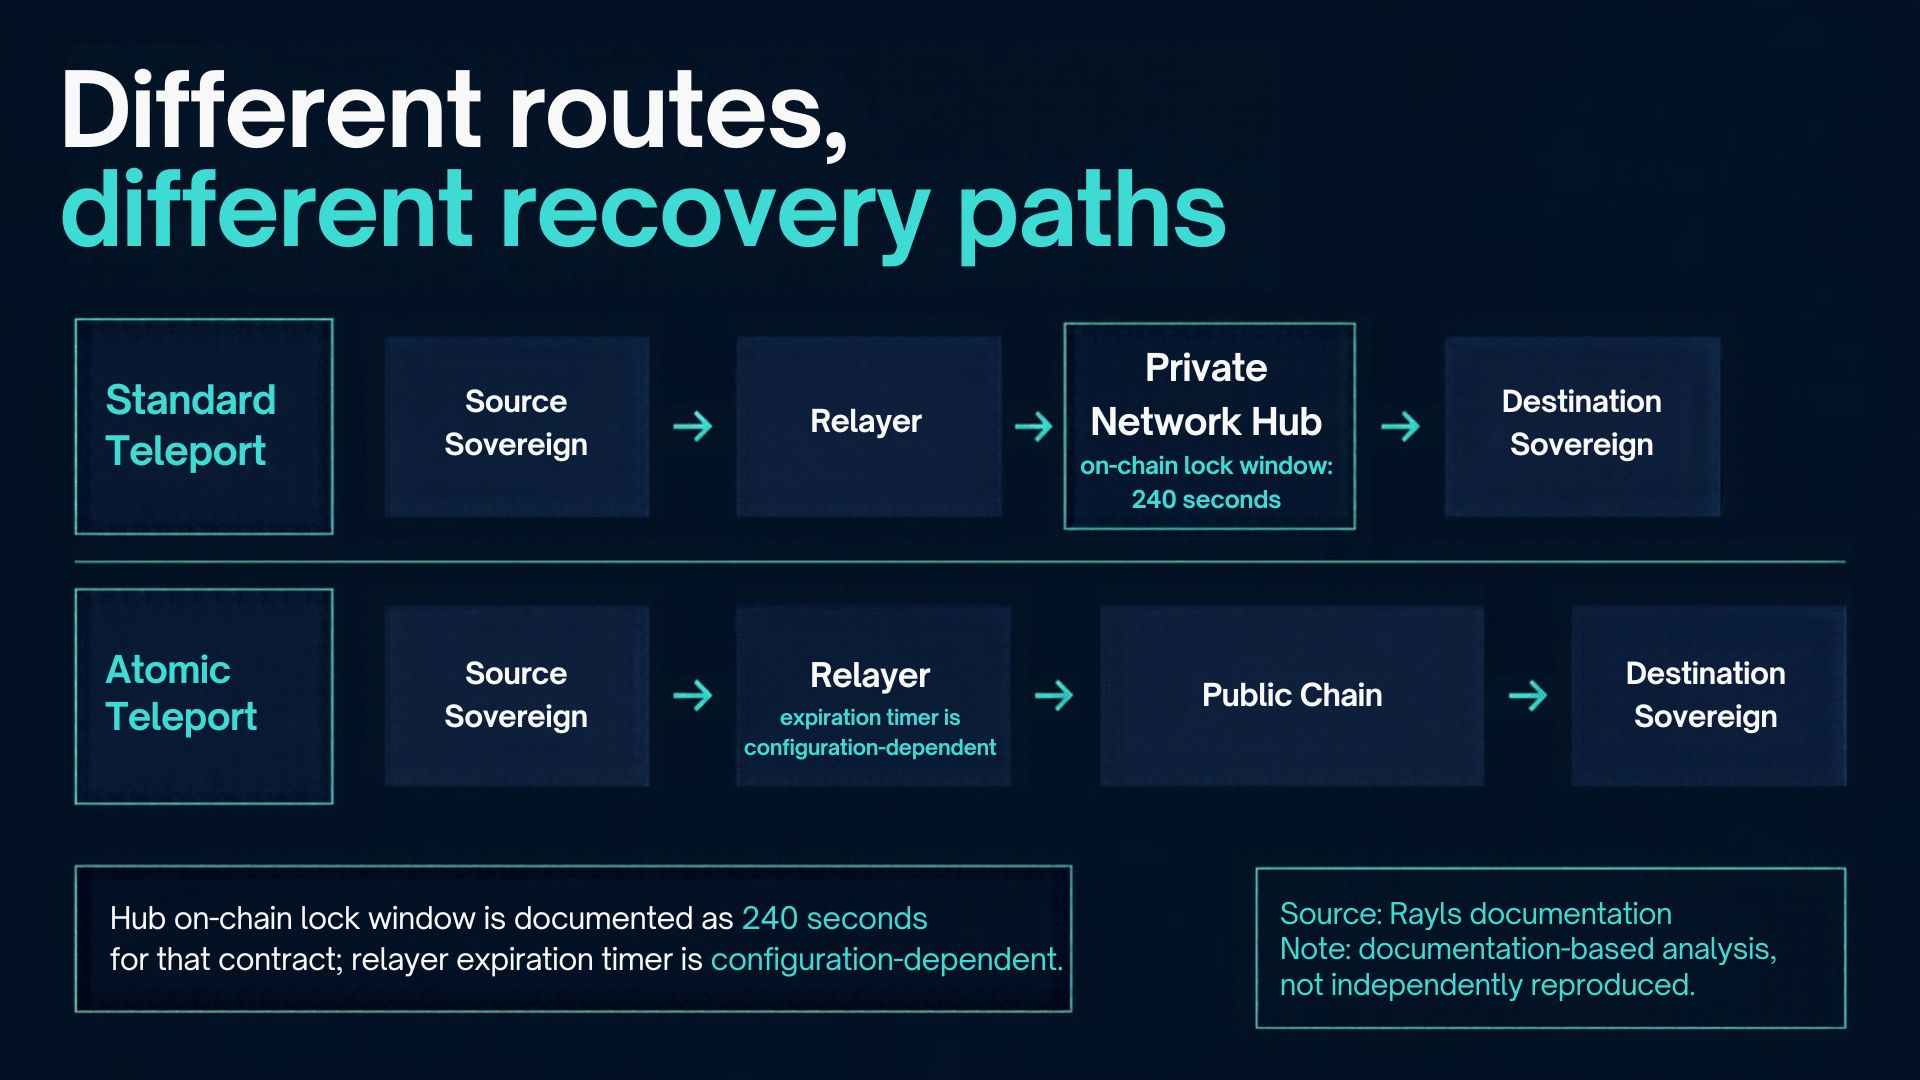
Standard teleport
Os tokens de origem são queimados.
A mensagem entre cadeias é processada.
O destino tenta executar a transferência.
Se a execução no destino falhar, a transação é assinalada como falha e é necessário tentar novamente manualmente.
Atomic teleport
São introduzidas fases adicionais de coordenação e bloqueio/desbloqueio.
O lado recetor segue o processo de finalização do protocolo.
Se ocorrerem as condições de falha documentadas, a transferência entra no processo automático de reversão.
O ativo do lado da origem pode ser restaurado, em vez de a recuperação depender de uma nova tentativa manual.
O contrato Teleport do Private Network Hub especifica uma janela de bloqueio on-chain de 240 segundos para o fluxo atómico. O Relayer também tem um temporizador off-chain de reversão por expiração, mas esse temporizador é configurado na implementação e não corresponde a um valor de protocolo universalmente fixo.
São mecanismos distintos e não devem ser tratados como um único temporizador.
A conclusão prática é simples: se uma aplicação necessita de um comportamento de reversão automática, tem de compreender qual é o protocolo de teleport que está realmente a utilizar. O nome da rede, por si só, não basta para determinar o comportamento de recuperação.
Referência oficial:
https://docs.rayls.com/docs/sending-teleports
6. O que muda quando o destino é a Rayls Public Chain?
A rota direta entre a Rayls Sovereign e a Rayls Public Chain é arquitetonicamente diferente da rota da Private Network.
De acordo com a documentação oficial, esta ligação não passa pelo Private Network Hub. Utiliza um conjunto separado de contratos e um processo separado de Relayer público.
A mecânica dos ativos também varia consoante a direção.
Quando os tokens passam de um ledger Sovereign para a Public Chain, os tokens de origem são bloqueados e são cunhados tokens-espelho correspondentes no lado público.
Quando os tokens passam da Public Chain para um ledger Sovereign, os tokens públicos são queimados e os tokens correspondentes no ledger Sovereign são desbloqueados.
O Relayer público monitoriza ambos os lados. A implementação documentada prepara e armazena uma carga útil de reversão ao criar a transação de avanço. Se a transação de destino falhar, o serviço de reversão pode recuperar a carga útil armazenada e submeter a transação de recuperação à cadeia de origem.
O resultado documentado é que uma transferência falhada devolve o ativo ao seu lado original: uma transferência falhada de Sovereign para a rede pública desbloqueia os tokens de origem, enquanto uma transferência falhada da rede pública para Sovereign restaura os tokens no lado público.
Esta implementação é diferente do fluxo do Private Network Hub, embora ambas as rotas procurem coordenar a movimentação de ativos entre ledgers.
Por isso, é importante não presumir que os mesmos contratos, o mesmo Relayer ou o mesmo processo de tratamento de falhas se aplicam a todas as ligações da Rayls.
Referência oficial:
https://docs.rayls.com/docs/connecting-rayls-sovereign-to-the-public-chain
7. O que isto significa para programadores e utilizadores
Esta investigação aponta para três lições práticas.
Em primeiro lugar, acompanhe a transferência completa, não apenas o recibo da origem.
Uma aplicação deve acompanhar a transação de origem, o processamento da mensagem entre cadeias, a execução no destino e qualquer transação de recuperação. Caso contrário, poderá apresentar uma transferência como concluída demasiado cedo — ou deixar os utilizadores sem perceber por que motivo uma transferência está parada.
Em segundo lugar, torne visível o comportamento de recuperação.
Uma operação falhada que exige uma nova tentativa manual não deve ser apresentada como se estivesse a ser recuperada automaticamente. Do mesmo modo, uma aplicação não deve dizer a um utilizador que os fundos foram devolvidos até a transação de recuperação ter sido confirmada.
Em terceiro lugar, compreenda o protocolo antes de fazer garantias.
O standard teleport, o atomic teleport e a rota direta da Public Chain têm mecanismos documentados diferentes. Uma aplicação deve utilizar as garantias de recuperação correspondentes à rota que realmente utiliza, em vez de fazer uma promessa geral sobre todas as transferências da Rayls.
Estas são implicações de conceção deduzidas da arquitetura documentada. Não são afirmações de que testei pessoalmente todos os percursos de falha.
8. O que verifiquei — e o que não verifiquei
A documentação oficial descreve as fases da transação, o comportamento de novas tentativas, a rejeição de provas, o tratamento de falhas no destino e os processos de reversão automática.
Utilizei essas descrições para comparar os comportamentos documentados e deduzir as implicações práticas para o acompanhamento do estado em aplicações.
Não implementei pessoalmente um ambiente Rayls, não provoquei falhas numa transferência ativa nem verifiquei o comportamento de recuperação através de rastos de transações. Esta é uma análise técnica baseada na documentação, não uma experiência reproduzida de forma independente.
Uma experiência seguinte útil seria realizar uma transferência controlada, provocar uma falha de execução no destino e registar a transação de origem, o recibo de destino, a transação de reversão e os saldos finais. Repetir a experiência com o standard teleport e o atomic teleport ajudaria a verificar a diferença entre os processos de recuperação documentados.
Isso transformaria uma comparação arquitetónica numa conclusão reproduzível de forma independente.
Considerações finais
A infraestrutura entre cadeias não deve ser avaliada apenas pela possibilidade de uma transferência ser bem-sucedida.
Também deve ser avaliada pela clareza com que o sistema se comporta quando uma transferência não pode ser concluída.
A documentação da Rayls descreve mecanismos distintos para repetir tentativas após falhas temporárias, rejeitar operações inválidas, tentar novamente manualmente um standard teleport falhado e reverter automaticamente um atomic teleport ou uma transferência falhada através da rota direta da Public Chain.
A lição mais útil é que «transação falhada» não explica completamente o que aconteceu ao ativo.
Para compreender o resultado, é necessário saber onde ocorreu a falha, que protocolo de transferência foi utilizado e se o processo de recuperação documentado foi efetivamente concluído.
Este é o nível de detalhe de que os programadores precisam antes de transformar a infraestrutura entre cadeias numa experiência fiável para os utilizadores.
Referências técnicas oficiais
Como funciona uma transação entre cadeias
https://docs.rayls.com/docs/how-a-cross-chain-transaction-works
Sending Teleports
https://docs.rayls.com/docs/sending-teleports
Ligar a Rayls Sovereign à Rayls Public Chain
https://docs.rayls.com/docs/connecting-rayls-sovereign-to-the-public-chain
#Rayls #TheRail #Blockchain #Web3 #CrossChain #Infrastructure