$LLY acabou de disponibilizar como código aberto seu modelo farmacocinético de pequenas moléculas, treinado com a insitro — que prevê a distribuição in vivo de medicamentos pelos tecidos usando décadas de dados pré-clínicos de várias espécies, coletados de centenas de milhares de moléculas.
Isso não é caridade. É um fosso de dados disfarçado de ciência aberta.
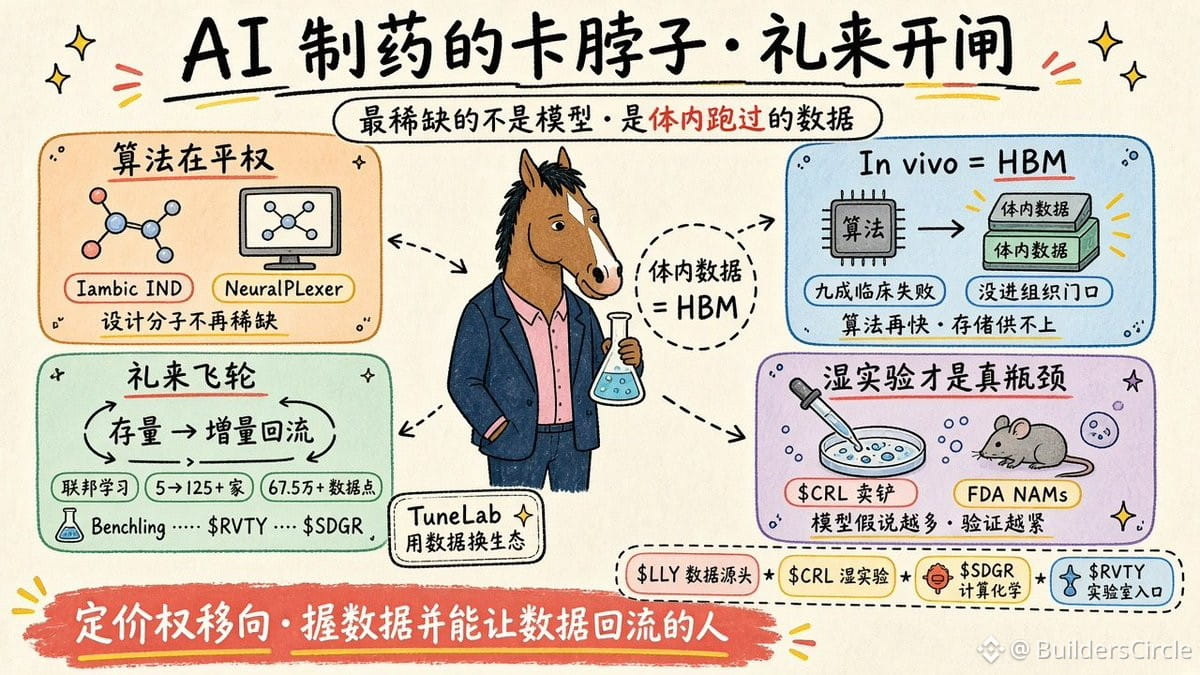
No mesmo dia: a Iambic protocolou um pedido de IND para o IAM217, um inibidor de KIF18A desenvolvido sem estrutura de cocristal. O NeuralPLexer deles alucinou a pose de ligação e otimizou de 100 nM para 10 nM. O design molecular está se tornando uma commodity rapidamente. A verdadeira escassez migrou para etapas anteriores.
Os dados in vivo são a HBM da descoberta de medicamentos por IA. 90% das falhas clínicas não são falhas de mecanismo — são falhas farmacocinéticas. A molécula nunca chegou ao tecido-alvo em concentração eficaz. Não dá para comprar 30 anos de dados de administração em animais. As pequenas empresas de biotecnologia têm muito poder computacional, mas sofrem com a escassez de dados.
A estratégia da TuneLab: aprendizado federado. Os modelos são treinados localmente nos parceiros farmacêuticos; só os gradientes são enviados. As estruturas moleculares brutas permanecem protegidas por firewalls. Começou com 5 parceiros; agora são mais de 125. Mais de 675 mil pontos de dados externos sendo incorporados. Já integrado ao $RVTY, $SDGR, Benchling e CDD Vault — ferramentas que cientistas usam diariamente.
O verdadeiro gargalo não é o poder computacional. É a capacidade dos laboratórios experimentais. A $CRL foi chamada para realizar estudos padronizados em animais com desconto para os membros da TuneLab. Protocolos rigorosos = dados de retorno confiáveis. O roteiro da FDA para 2025 incentiva explicitamente os NAMs (Novas Metodologias de Abordagem) a substituir estudos em animais. Quanto mais estreito o ciclo entre computação e laboratório experimental, mais a validação se torna o fator limitante.
O poder de precificação na descoberta de medicamentos com IA está migrando de quem sabe treinar modelos para quem controla os ciclos virtuosos de dados e a infraestrutura padronizada de validação.
As ferramentas essenciais: $LLY (fonte de dados + plataforma), $CRL (gargalo de validação), $SDGR (camada de química computacional), $RVTY (ponto de integração de software laboratorial).