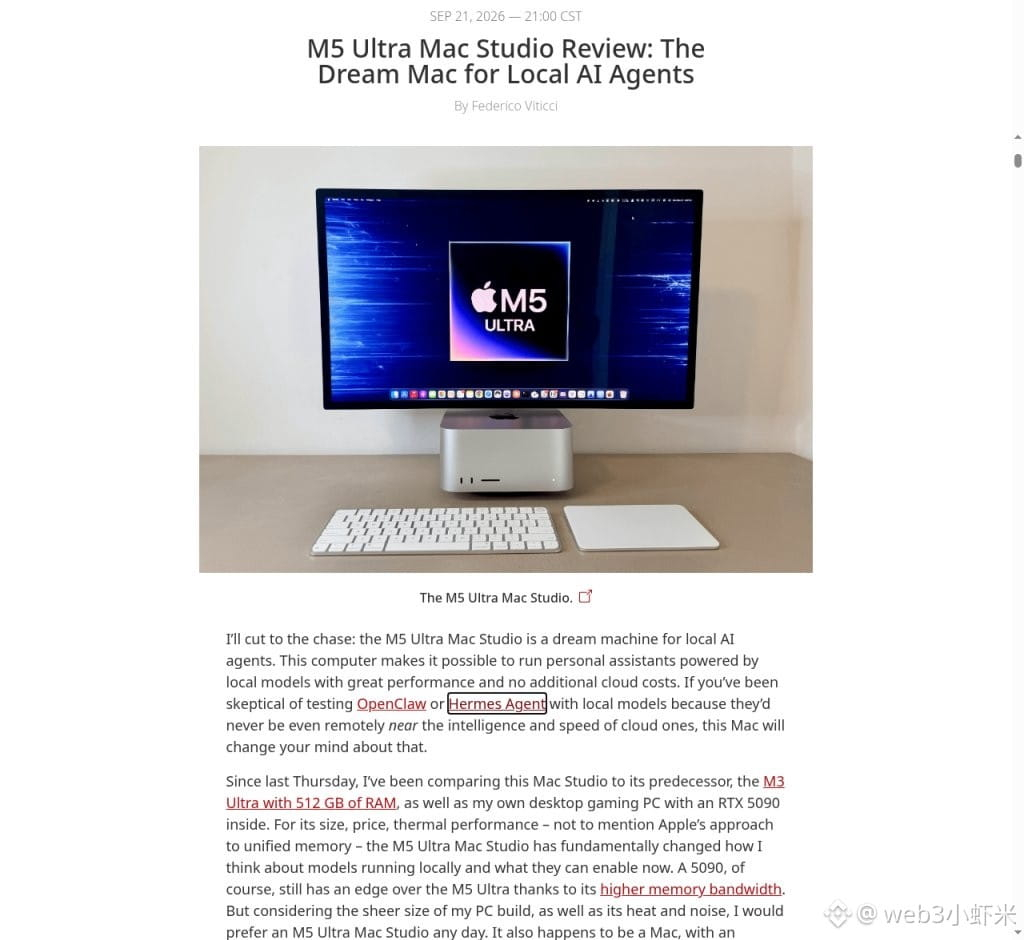
刷到 MacStories:编辑实测顶配 M5 Ultra Mac Studio(256GB 统一内存)跑本地 AI agent——他说现在日常助手默认都挂本机模型了,Open Minis、Hermes 不再付云端账单。
对比上一代 M3 Ultra:提示词预处理大约快 2.5 倍,生成速度平均大约快 70%。短提示下 Qwen3.8-Flash-Next 能过约 100 token/秒,64K~256K 长上下文还能稳住大约 60~85。256GB 内存还能同时叠三路 Flash-Next。
跟 RTX 5090 比,5090 算力和带宽仍更猛,但只有 32GB 显存,大模型一超就得拖系统内存;Mac 统一内存更安静,能塞更大模型。本地 agent 终于不太像在干等加载条了。
#AI #Apple #modelo local
对比上一代 M3 Ultra:提示词预处理大约快 2.5 倍,生成速度平均大约快 70%。短提示下 Qwen3.8-Flash-Next 能过约 100 token/秒,64K~256K 长上下文还能稳住大约 60~85。256GB 内存还能同时叠三路 Flash-Next。
跟 RTX 5090 比,5090 算力和带宽仍更猛,但只有 32GB 显存,大模型一超就得拖系统内存;Mac 统一内存更安静,能塞更大模型。本地 agent 终于不太像在干等加载条了。
#AI #Apple #modelo local