Eu realmente nunca achava que “dados reais” eram tão importantes
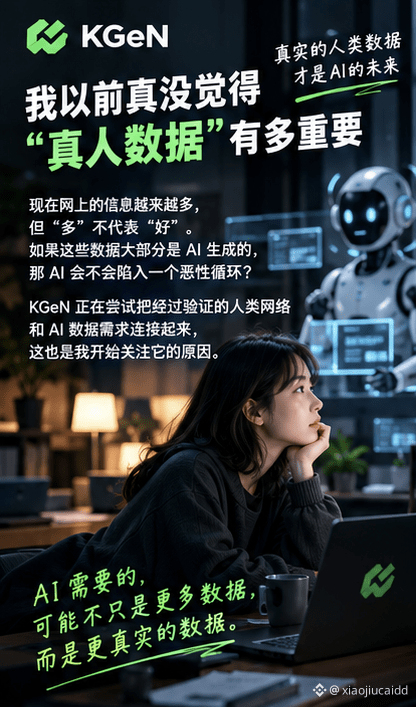
Antes, quando via projetos de IA falando de dados, eu basicamente só dava uma olhada rápida.
A quantidade de dados, o tamanho do modelo, com quem fizeram parceria... depois de ver muito, no fundo parecia tudo igual.
Mas recentemente, ao ver o KGeN, fiquei curioso justamente com uma pergunta bem simples:
Se, no futuro, a quantidade de dados para treinar IA for cada vez mais gerada por IA, quem vai provar que esses dados começaram originalmente com humanos de verdade?
Isso é bastante interessante.
Hoje, há cada vez mais informações na internet, mas “mais” não significa “melhor”.
Um artigo pode ser escrito por IA; uma imagem pode ser gerada por IA; até um trecho de comentário pode ser produzido em massa por robôs.
Se essas coisas continuarem sendo usadas para treinar a próxima geração de IA, no fim pode acontecer um ciclo bem estranho:
Dados gerados por IA → IA aprende → gera mais dados → treina outra IA.
Os dados continuam aumentando, mas as experiências humanas reais ficam cada vez mais raras.
Esse é também o motivo de eu ter começado a acompanhar o KGeN recentemente.
A proposta do KGeN não é simplesmente criar mais uma “plataforma de dados”, mas sim conectar redes humanas verificadas com necessidades de dados de IA.
Atualmente, as direções enfatizadas oficialmente incluem Verified Human, dados multimodais como Sound / Sight / Motion / Touch, além de Physical AI e LLM.
Eu acho que o que torna esse caminho realmente interessante não são as duas palavras “IA”.
Mas sim:
À medida que houver cada vez mais IA, será que o próprio humano de verdade não acabará virando, paradoxalmente, um recurso raro?
Acredito que essa questão vale a pena acompanhar de perto o KGeN.
#KGEN
Antes, quando via projetos de IA falando de dados, eu basicamente só dava uma olhada rápida.
A quantidade de dados, o tamanho do modelo, com quem fizeram parceria... depois de ver muito, no fundo parecia tudo igual.
Mas recentemente, ao ver o KGeN, fiquei curioso justamente com uma pergunta bem simples:
Se, no futuro, a quantidade de dados para treinar IA for cada vez mais gerada por IA, quem vai provar que esses dados começaram originalmente com humanos de verdade?
Isso é bastante interessante.
Hoje, há cada vez mais informações na internet, mas “mais” não significa “melhor”.
Um artigo pode ser escrito por IA; uma imagem pode ser gerada por IA; até um trecho de comentário pode ser produzido em massa por robôs.
Se essas coisas continuarem sendo usadas para treinar a próxima geração de IA, no fim pode acontecer um ciclo bem estranho:
Dados gerados por IA → IA aprende → gera mais dados → treina outra IA.
Os dados continuam aumentando, mas as experiências humanas reais ficam cada vez mais raras.
Esse é também o motivo de eu ter começado a acompanhar o KGeN recentemente.
A proposta do KGeN não é simplesmente criar mais uma “plataforma de dados”, mas sim conectar redes humanas verificadas com necessidades de dados de IA.
Atualmente, as direções enfatizadas oficialmente incluem Verified Human, dados multimodais como Sound / Sight / Motion / Touch, além de Physical AI e LLM.
Eu acho que o que torna esse caminho realmente interessante não são as duas palavras “IA”.
Mas sim:
À medida que houver cada vez mais IA, será que o próprio humano de verdade não acabará virando, paradoxalmente, um recurso raro?
Acredito que essa questão vale a pena acompanhar de perto o KGeN.
#KGEN