$ETH Vitalik: A concepção de mecanismos adversariais pode ser a chave para a segurança da IA
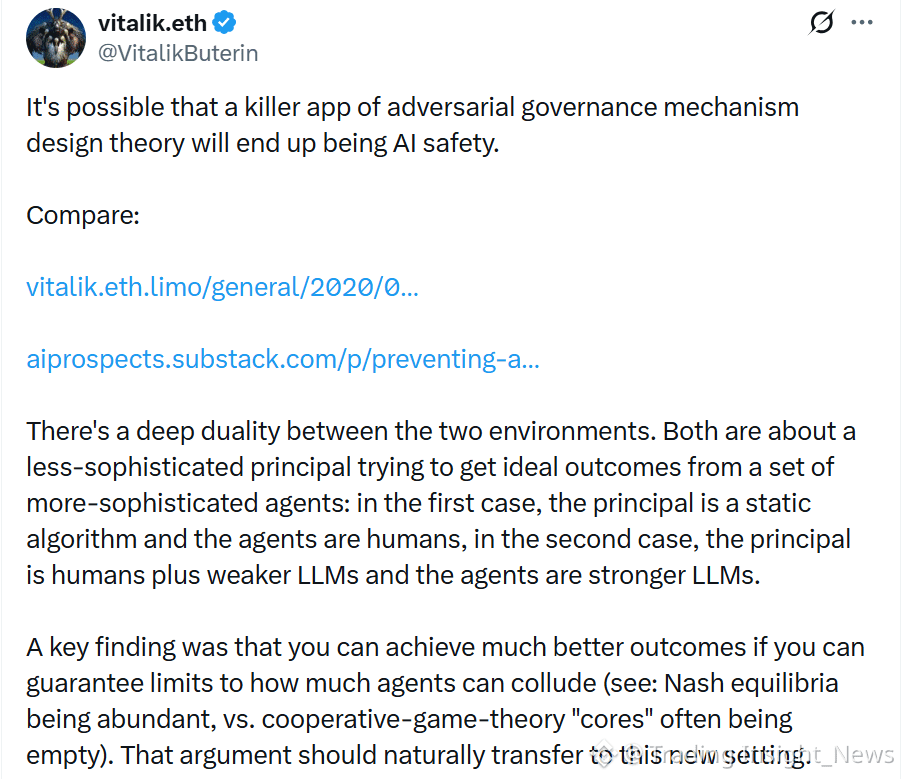
Vitalik Buterin acabou de fazer uma comparação notável: a teoria de concepção de mecanismos adversariais, familiar na criptografia, poderia ser uma aplicação importante para a segurança da IA.
Ambas as áreas compartilham uma estrutura binária profunda entre principal e agente:
Na criptografia: o principal é um algoritmo estático (capacidade fraca), o agente é humano (capacidade mais forte).
Na IA: o principal é um humano e um LLM mais fraco, o agente é um LLM mais forte.
Pesquisas relacionadas mostram que, se você consegue limitar o nível de conluio entre agentes, pode obter resultados melhores. Essa conclusão pode se aplicar diretamente à segurança da IA.
Esta é uma das ideias mais interessantes que Vitalik compartilhou recentemente. O problema central da segurança da IA é: como os humanos podem controlar um sistema mais inteligente do que eles?
A resposta que a criptografia aprendeu ao longo dos anos: não controle confiando; controle por meio de desenho de mecanismos. Mecanismos adversariais em que as partes têm incentivos conflitantes e se verificam mostraram-se eficazes em protocolos de blockchain.
Aplicar essa lógica à IA é uma abordagem nova. Em vez de tentar “ensinar” a IA a ser boa, poderíamos projetar ambientes nos quais agentes de IA verifiquem e limitem uns aos outros.
O que você acha que poderia fazer os mecanismos adversariais serem uma solução real para a segurança da IA, ou apenas uma abordagem teórica?
Notícias são apenas para referência, não constituem aconselhamento de investimento. Por favor, leia com atenção antes de tomar uma decisão.
Vitalik Buterin acabou de fazer uma comparação notável: a teoria de concepção de mecanismos adversariais, familiar na criptografia, poderia ser uma aplicação importante para a segurança da IA.
Ambas as áreas compartilham uma estrutura binária profunda entre principal e agente:
Na criptografia: o principal é um algoritmo estático (capacidade fraca), o agente é humano (capacidade mais forte).
Na IA: o principal é um humano e um LLM mais fraco, o agente é um LLM mais forte.
Pesquisas relacionadas mostram que, se você consegue limitar o nível de conluio entre agentes, pode obter resultados melhores. Essa conclusão pode se aplicar diretamente à segurança da IA.
Esta é uma das ideias mais interessantes que Vitalik compartilhou recentemente. O problema central da segurança da IA é: como os humanos podem controlar um sistema mais inteligente do que eles?
A resposta que a criptografia aprendeu ao longo dos anos: não controle confiando; controle por meio de desenho de mecanismos. Mecanismos adversariais em que as partes têm incentivos conflitantes e se verificam mostraram-se eficazes em protocolos de blockchain.
Aplicar essa lógica à IA é uma abordagem nova. Em vez de tentar “ensinar” a IA a ser boa, poderíamos projetar ambientes nos quais agentes de IA verifiquem e limitem uns aos outros.
O que você acha que poderia fazer os mecanismos adversariais serem uma solução real para a segurança da IA, ou apenas uma abordagem teórica?
Notícias são apenas para referência, não constituem aconselhamento de investimento. Por favor, leia com atenção antes de tomar uma decisão.