#dusk $DUSK @Dusk
Estava lendo as mudanças recentes de engenharia da Dusk e esperava que a parte interessante fosse mais uma melhoria no sistema de prova.
Em vez disso, acabei voltando para algo bem menos glamouroso: o que acontece antes mesmo de uma prova ser processada..
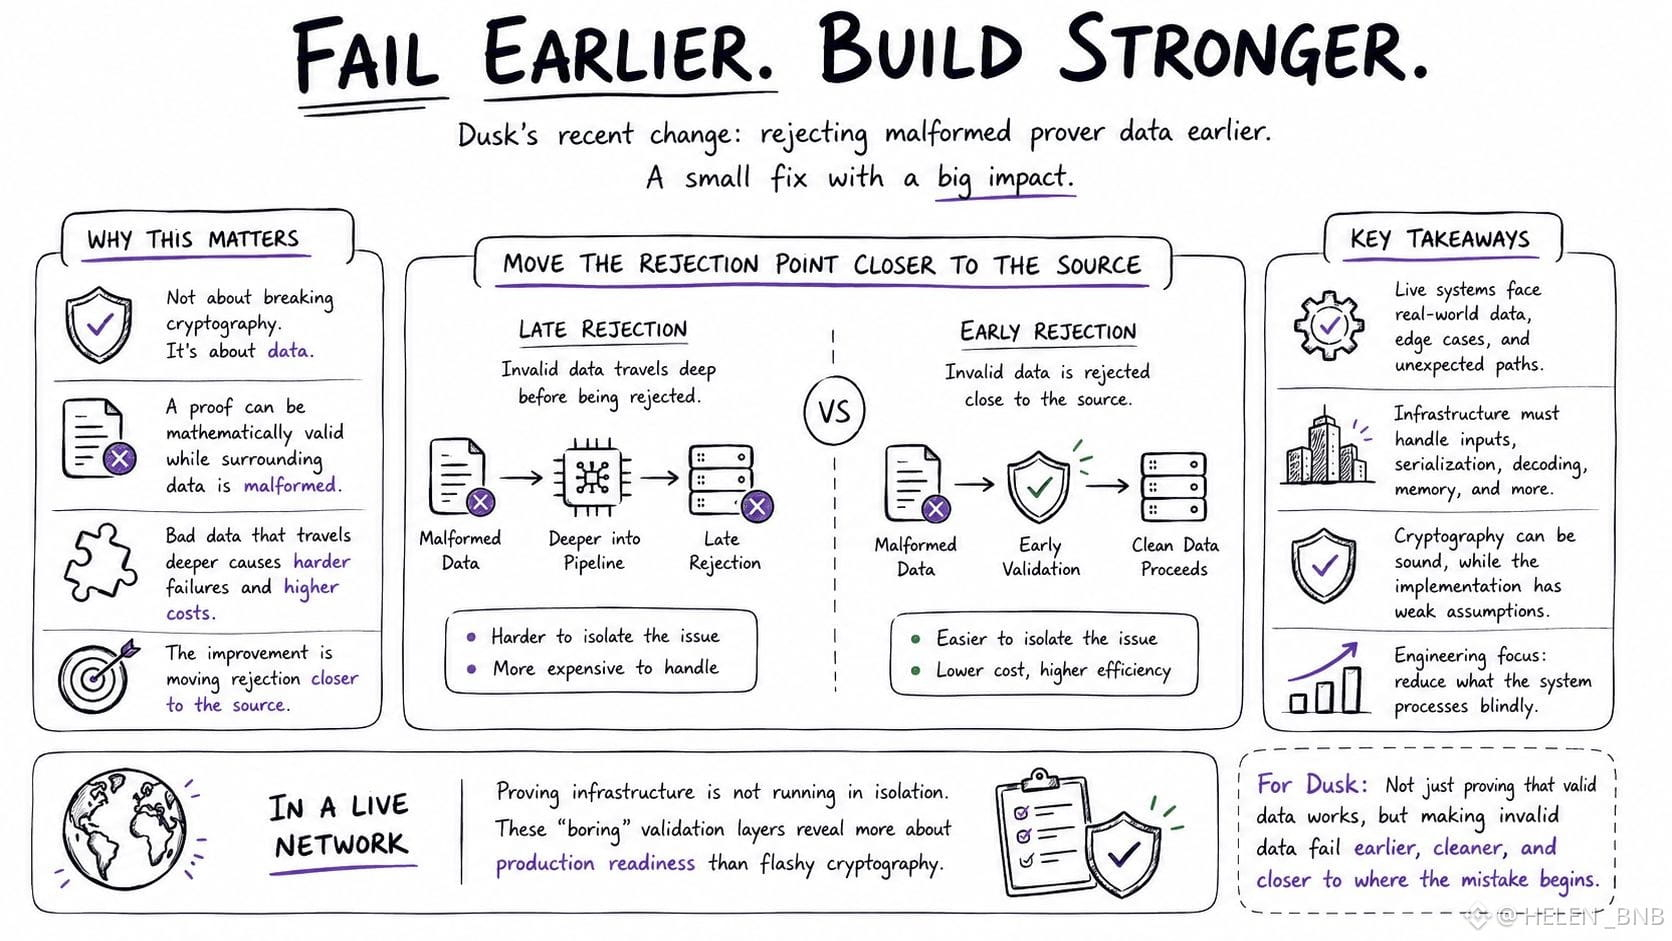
Uma mudança recente relacionada ao Plonk focou em rejeitar dados do prover malformados mais cedo. À primeira vista, isso parece uma limpeza rotineira.
Mas quanto mais eu pensava sobre isso, mais importante ficava.
Existe diferença entre quebrar a criptografia e alimentar dados ruins em uma infraestrutura criptográfica.
Uma prova pode ser matematicamente válida, enquanto os dados ao redor dela estão malformados de maneira incorreta, serializados ou estruturados de um jeito que o sistema nunca esperava. Se essas entradas forem permitidas seguir adiante no pipeline de provas, a falha eventual se torna mais difícil de isolar e potencialmente mais cara de lidar.
Então a melhoria real não é necessariamente sobre uma matemática mais forte.
É sobre mover o ponto de rejeição para mais perto da fonte.
Isso importa operacionalmente.
Em uma infraestrutura de prover em rede ao vivo, ela não roda de forma isolada. Ela precisa lidar com serialização e decodificação de entradas, caminhos de execução e todos os casos de borda estranhos que surgem quando o software encontra dados do mundo real.
A criptografia pode estar correta, enquanto a implementação ao redor ainda faz suposições fracas.
É por isso que acho essas mudanças menores mais reveladoras do que anúncios de recursos.
Elas mostram onde o time de engenharia está gastando tempo para reduzir o número de coisas que o sistema está disposto a processar cegamente.
Para a Dusk, eu acho que essa é uma direção importante: não apenas provar que dados válidos funcionam, mas fazer dados inválidos falharem mais cedo, de forma mais limpa e mais perto de onde o erro começa.
A entediante camada de validação pode acabar nos dizendo mais sobre prontidão para produção do que a criptografia chamativa jamais dirá.
Estava lendo as mudanças recentes de engenharia da Dusk e esperava que a parte interessante fosse mais uma melhoria no sistema de prova.
Em vez disso, acabei voltando para algo bem menos glamouroso: o que acontece antes mesmo de uma prova ser processada..
Uma mudança recente relacionada ao Plonk focou em rejeitar dados do prover malformados mais cedo. À primeira vista, isso parece uma limpeza rotineira.
Mas quanto mais eu pensava sobre isso, mais importante ficava.
Existe diferença entre quebrar a criptografia e alimentar dados ruins em uma infraestrutura criptográfica.
Uma prova pode ser matematicamente válida, enquanto os dados ao redor dela estão malformados de maneira incorreta, serializados ou estruturados de um jeito que o sistema nunca esperava. Se essas entradas forem permitidas seguir adiante no pipeline de provas, a falha eventual se torna mais difícil de isolar e potencialmente mais cara de lidar.
Então a melhoria real não é necessariamente sobre uma matemática mais forte.
É sobre mover o ponto de rejeição para mais perto da fonte.
Isso importa operacionalmente.
Em uma infraestrutura de prover em rede ao vivo, ela não roda de forma isolada. Ela precisa lidar com serialização e decodificação de entradas, caminhos de execução e todos os casos de borda estranhos que surgem quando o software encontra dados do mundo real.
A criptografia pode estar correta, enquanto a implementação ao redor ainda faz suposições fracas.
É por isso que acho essas mudanças menores mais reveladoras do que anúncios de recursos.
Elas mostram onde o time de engenharia está gastando tempo para reduzir o número de coisas que o sistema está disposto a processar cegamente.
Para a Dusk, eu acho que essa é uma direção importante: não apenas provar que dados válidos funcionam, mas fazer dados inválidos falharem mais cedo, de forma mais limpa e mais perto de onde o erro começa.
A entediante camada de validação pode acabar nos dizendo mais sobre prontidão para produção do que a criptografia chamativa jamais dirá.