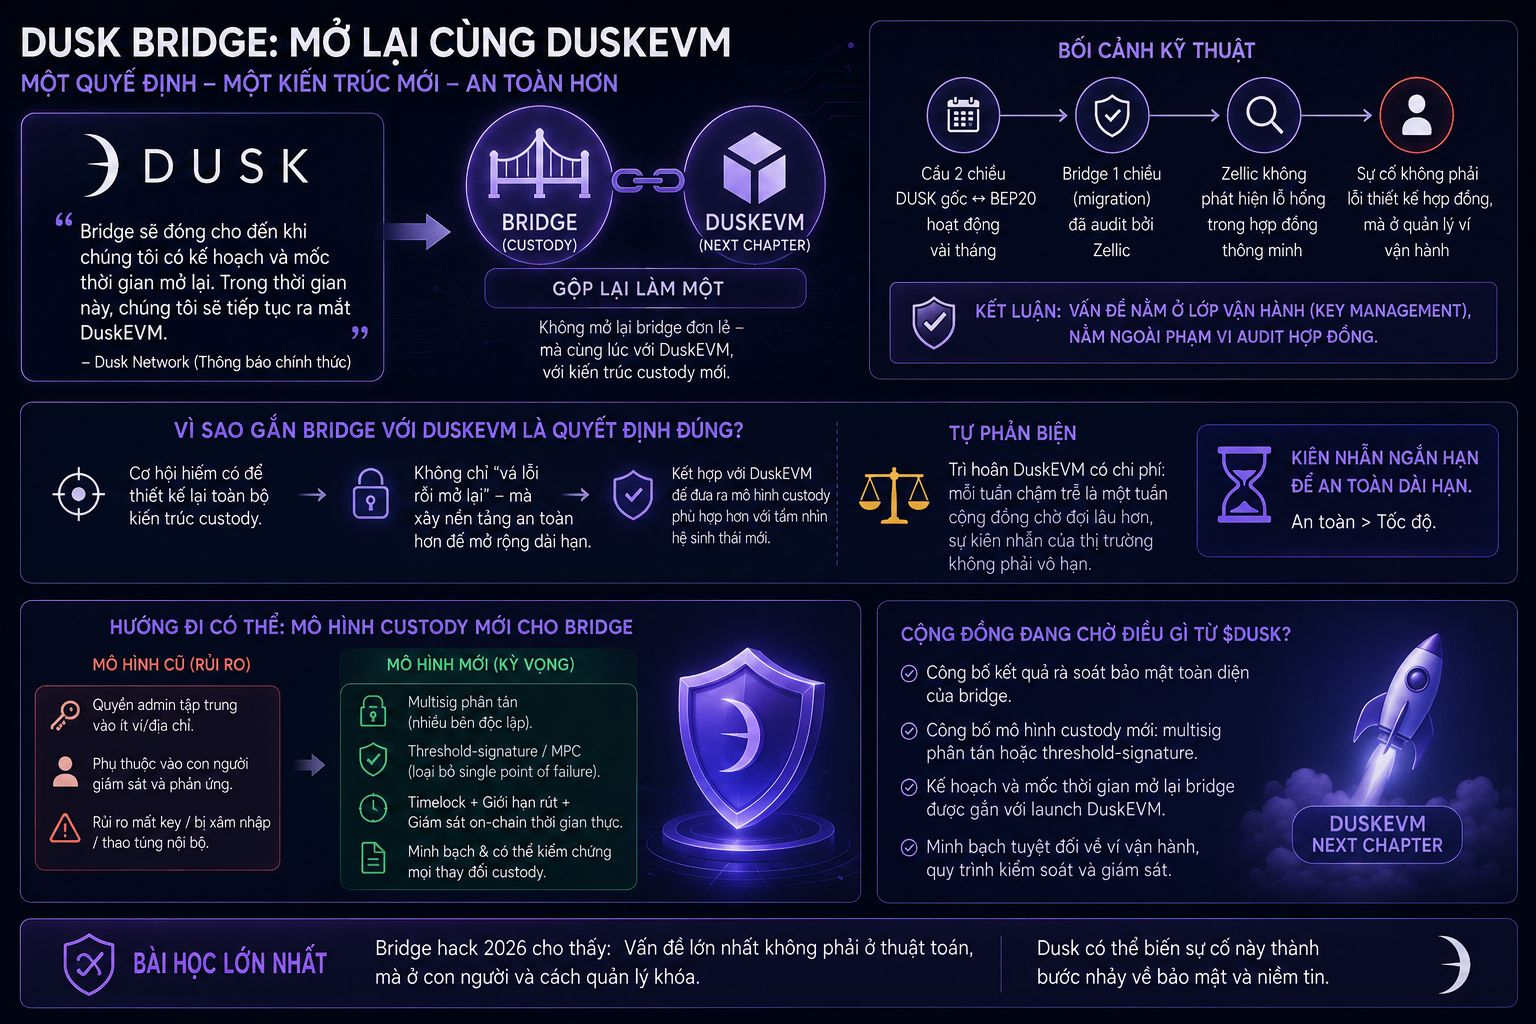
Vi observo um detalhe digno de nota ao analisar como @Dusk condiciona o reestabelecimento da bridge com o próprio DuskEVM: o comunicado oficial deixa claro que a bridge ficará fechada até que haja um plano e um cronograma para a reabertura, ao mesmo tempo em que continua a ser lançado o DuskEVM — ou seja, estas duas coisas estão sendo tratadas como uma única decisão, sem separação.
Este é o ponto que me fez parar. No início, pode-se pensar que o incidente na bridge era apenas um problema operacional isolado, que bastaria corrigir e reabrir como antes. Mas ao vincularem isso ao lançamento do DuskEVM, surge outra possibilidade: a equipe pode estar aproveitando este momento para redesenhar toda a arquitetura de custódia (custody) da bridge.
Se for verdade, isso indica uma reação muito mais madura do que simplesmente corrigir rapidamente e reabrir para aliviar a pressão da opinião pública. O contexto técnico também é relevante: a ponte bidirecional entre o DUSK original e o novo BEP20 esteve funcionando apenas alguns meses antes do incidente, e a bridge unidirecional para migração, já passou por auditoria da Zellic, sem detectar nenhuma vulnerabilidade. Isso reforça a visão de que o incidente não foi um erro de design do contrato, mas sim, exatamente como o comunicado sugere — um problema de gerenciamento de carteiras de operação (operational wallets), uma camada fora do escopo de auditorias comuns de contratos inteligentes.
Autocontra-argumento: adiar o DuskEVM para fazer mais bem a parte da bridge também tem seu próprio custo — cada semana de atraso é uma semana a mais em que a comunidade espera o marco mais importante do roadmap recente, e a paciência do mercado não é infinita.
Estou aguardando ver se $DUSK vai publicar um novo modelo de custody para a bridge — talvez um multisig mais distribuído ou uma threshold-signature — em vez de apenas restaurar exatamente a estrutura operacional anterior ao incidente.
#dusk $BTC $ETH
Este é o ponto que me fez parar. No início, pode-se pensar que o incidente na bridge era apenas um problema operacional isolado, que bastaria corrigir e reabrir como antes. Mas ao vincularem isso ao lançamento do DuskEVM, surge outra possibilidade: a equipe pode estar aproveitando este momento para redesenhar toda a arquitetura de custódia (custody) da bridge.
Se for verdade, isso indica uma reação muito mais madura do que simplesmente corrigir rapidamente e reabrir para aliviar a pressão da opinião pública. O contexto técnico também é relevante: a ponte bidirecional entre o DUSK original e o novo BEP20 esteve funcionando apenas alguns meses antes do incidente, e a bridge unidirecional para migração, já passou por auditoria da Zellic, sem detectar nenhuma vulnerabilidade. Isso reforça a visão de que o incidente não foi um erro de design do contrato, mas sim, exatamente como o comunicado sugere — um problema de gerenciamento de carteiras de operação (operational wallets), uma camada fora do escopo de auditorias comuns de contratos inteligentes.
Autocontra-argumento: adiar o DuskEVM para fazer mais bem a parte da bridge também tem seu próprio custo — cada semana de atraso é uma semana a mais em que a comunidade espera o marco mais importante do roadmap recente, e a paciência do mercado não é infinita.
Estou aguardando ver se $DUSK vai publicar um novo modelo de custody para a bridge — talvez um multisig mais distribuído ou uma threshold-signature — em vez de apenas restaurar exatamente a estrutura operacional anterior ao incidente.
#dusk $BTC $ETH